block: take i_rwsem for the direct I/O write fallback
块设备 I/O · O_DIRECT 回落写路径 · set_blocksize 竞态修复
💡 一句话总结
在块设备 O_DIRECT 写路径中,当一次直接写只完成一部分、剩余字节通过回落(fallback)转为缓冲写时,这段缓冲写此前在无任何锁保护下执行,与并发的 ioctl(BLKBSZSET) 调整块大小(改变 i_blkbits 与映射最小 folio 阶数)竞争,可在 __filemap_add_folio() 触发 VM_BUG_ON_FOLIO 内核崩溃;本补丁在回落写外加 inode_lock_shared(bd_inode),与普通缓冲写分支保持一致,从根上消除该竞态。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | bugfix(修复 commit c0e473a0d226 遗漏的竞态) |
| 状态 | In Review(v1 首版,review 中) |
| 当前版本 | v1 · lore 链接 |
| 版本演进 | 首版,暂无演进 |
| 作者机构 | Tal Zussman(Columbia University,tz2294@columbia.edu) |
| 提交日期 | 2026-08-02 |
| 改动范围 | block/fops.c,+8/-3 行,1 文件 |
| 核心函数 | blkdev_write_iter() / blkdev_buffered_write() / direct_write_fallback() |
| Fixes | c0e473a0d226(block: fix race between set_blocksize and read paths) |
| 原始链接 | 20260802-blkdev-fixes-v1-2-a82fc549fd74@columbia.edu |
📊 速览卡片
核心机制
i_rwsem 共享锁
优化目标
修复崩溃竞态
适用场景
O_DIRECT 回落写
实测提升
未提供
🎯 解决什么问题
背景 / 原始动机
上游 commit
c0e473a0d226(Darrick J. Wong,2025-04)为修复"块设备大扇区支持"引入的一个竞态:set_blocksize() 可以在并发读写仍持有旧 folio 时改变 i_blkbits 和映射的最小 folio 阶数,导致内核崩溃。该 commit 在块设备读写路径上加 i_rwsem 锁(set_blocksize() 持独占锁、读写路径持共享锁)——但只覆盖了普通缓冲读写分支,遗漏了 O_DIRECT 写回落路径。本补丁(2/2 系列)即补齐这一遗漏。问题由 Sashiko(内核自动化审查机器人)在审查 "block: enable RWF_DONTCACHE for block devices" 系列时发现,与那个系列相互独立。
系统层面:无锁的回落写 vs 持有独占锁的 set_blocksize
在
blkdev_write_iter() 的 IOCB_DIRECT 分支中,当前代码写成
direct_write_fallback(iocb, from, ret, blkdev_buffered_write(iocb, from))。
由于 C 语言函数实参在进入函数前求值,第 4 个实参 blkdev_buffered_write() 会在没有任何锁的情况下执行一次缓冲写(内部走 iomap_file_buffered_write() → iomap_write_begin() → __filemap_add_folio() 分配 folio)。与此同时 set_blocksize()(经 ioctl(BLKBSZSET))持 inode_lock() 独占锁,修改 i_blkbits 并调用 mapping_set_folio_min_order() 提高映射的最小 folio 阶数。当回落写分配低阶 folio(如 order-0)时映射的最小阶数已被提高,__filemap_add_folio() 就会触发 VM_BUG_ON_FOLIO(folio_order(folio) < mapping_min_folio_order(mapping))。
场景层面:什么工作负载会踩中
该崩溃需要同时具备苛刻条件(作者 commit message 自述):
- CONFIG_DEBUG_VM 内核(否则断言不编译,可能静默产生错误 folio);
- 块大小 > PAGE_SIZE:最小 folio 阶数只在块大小超过页大小时才会被抬高,需
CONFIG_TRANSPARENT_HUGEPAGE把BLK_MAX_BLOCK_SIZE提到 64K; - 四线程竞态:① 线程用 O_DIRECT
pwritev()提交两段 iovec,第二段是PROT_NONE不可读映射——直接写完成第一段、pin 第二段失败返回 short,从而进入回落;② 线程反复切换第二段的内存保护,让部分回落能越过fault_in_iov_iter_readable()进入页缓存;③ 线程用pread()/readahead 以"当前块大小"的 folio 填充页缓存;④ 线程用BLKBSZSET在 512B 与 64K 之间反复切换块大小。
kernel BUG at mm/filemap.c:858(__filemap_add_folio+0x860/0x8d0),同一负载还会触发 iomap_trim_folio_range() 里的 WARN_ON_ONCE(pos >= folio_pos(folio) + fsize)。
受影响负载:块设备 O_DIRECT 部分写回落 + 并发 BLKBSZSET 块大小调整 · 为什么踩中:回落写分配的 folio 阶数与 set_blocksize 新设定的最小 folio 阶数不匹配
🧩 核心机制
补丁把普通缓冲写分支早已持有的 inode_lock_shared(bd_inode) 补到直接 I/O 回落写路径上,使回落过程中的 folio 分配与 set_blocksize() 的几何重配置串行化。
从系统层面看:i_rwsem 读写信号量的角色
i_rwsem(inode 读写信号量)是块设备 inode 上的经典锁:set_blocksize() 持独占锁(inode_lock()),块设备读/写路径持共享锁(inode_lock_shared())。共享锁之间互不阻塞(并发写保持并行),只有独占锁持有者会让所有共享锁等待——这正是"调整块大小这种低频重配置"与"高频读写"之间的正确同步语义:写者不互相拖累,但几何变更时全体让路。本补丁就是让 O_DIRECT 回落写也纳入这一共享锁保护,与同函数里普通缓冲写分支(else 分支)的既有写法完全对齐。锁的作用域只包住
blkdev_buffered_write() 这一次缓冲写(即 folio 分配发生的时刻),解锁后才调用 direct_write_fallback() 做写回与页缓存失效——与普通缓冲写分支的锁范围一致。这就是"为什么这么改":不是发明新锁,而是补齐既有锁模型的覆盖盲区。
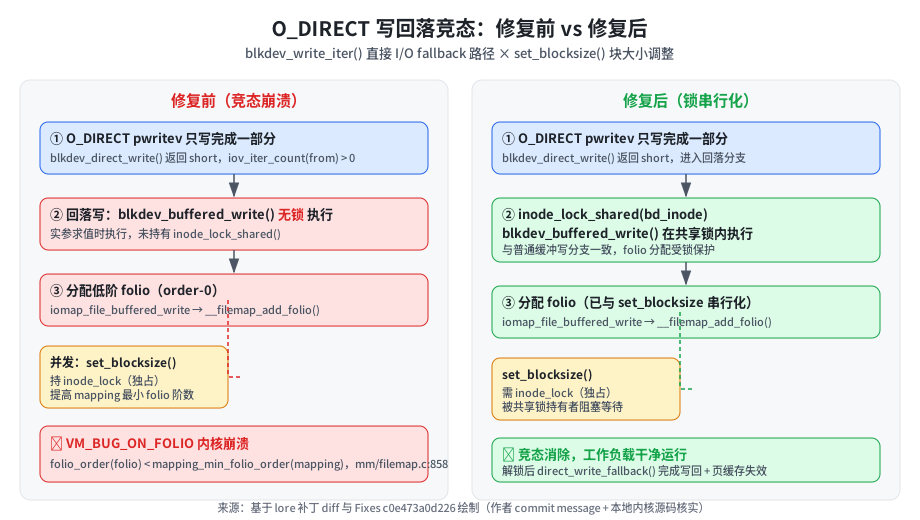
来源:基于 lore 补丁 diff、commit message 与本地内核源码(block/fops.c、fs/libfs.c、mm/filemap.c)绘制
| 环节 | 操作 | 目的 |
|---|---|---|
| 触发 | blkdev_direct_write() 返回 short 且 iov_iter_count(from) 仍有剩余 | O_DIRECT 未写完,剩余字节需转缓冲写 |
| 锁 | inode_lock_shared(bd_inode) | 与 set_blocksize 的独占锁互斥,阻塞几何变更 |
| 回落写 | blkdev_buffered_write() → iomap_file_buffered_write() | 锁内分配 folio,阶数必与当前 min_order 匹配 |
| 收尾 | inode_unlock_shared() → direct_write_fallback() | 写回 + 失效页缓存,保持 O_DIRECT 语义 |
🔬 关键代码
@@ -763,9 +763,14 @@ static ssize_t blkdev_write_iter(struct kiocb *iocb, struct iov_iter *from)

 	if (iocb->ki_flags & IOCB_DIRECT) {
 		ret = blkdev_direct_write(iocb, from);
-		if (ret >= 0 && iov_iter_count(from))
-			ret = direct_write_fallback(iocb, from, ret,
-					blkdev_buffered_write(iocb, from));
+		if (ret >= 0 && iov_iter_count(from)) {
+			ssize_t ret2;
+
+			inode_lock_shared(bd_inode);
+			ret2 = blkdev_buffered_write(iocb, from);
+			inode_unlock_shared(bd_inode);
+			ret = direct_write_fallback(iocb, from, ret, ret2);
+		}
 	} else {
 		/*
 		 * Take i_rwsem and invalidate_lock to avoid racing with
▲ 原文逐字来自 lore_patch(quoted-printable 解码)。改动实质:把回落写的"求值"从函数实参位置挪进显式变量,并在其外加共享锁。
为什么这么改
- 删掉的旧写法:
direct_write_fallback(..., blkdev_buffered_write(iocb, from))里,回落缓冲写作为实参在无锁状态下求值并完整执行。这正是竞态窗口所在。 - 新增的
inode_lock_shared(bd_inode):在回落写执行期间持 inode 共享锁。set_blocksize()要改几何必须先拿到inode_lock()独占锁,于是要么等回落写完成、要么回落写等 set_blocksize 完成——两者不再交错。关键一行:锁只包住blkdev_buffered_write()(folio 分配时刻),与下方普通缓冲写分支的既有写法逐字对齐。 - 局部变量
ret2:先存回落写结果,再传给direct_write_fallback()统一做写回与失效,保持返回语义不变。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| (作者未提供基准数据) | — | — | — |
说明:补丁未提供任何基准数据,作者也未声称性能提升——这是纯 bugfix,目标是消除崩溃而非提速。
性能含义(逻辑分析)
从 on-CPU / off-CPU 视角(Brendan Gregg:延迟 = 在 CPU 上算的时间 + 阻塞/等待的时间)看,本补丁属于纠正正确性而非优化某一段计算或等待(解读(AI 分析)):
- on-CPU 开销:回落路径多一次
down_read/up_read(inode_lock_shared)。共享锁无竞争时只是原子计数加解锁,开销为纳秒级,且只在"O_DIRECT 部分写"这一罕见路径上发生——可忽略。 - off-CPU 等待:仅当并发
set_blocksize()正持独占锁时,回落写会短暂阻塞等待;而set_blocksize(root 才可调的 ioctl)是极低频操作。正常并发写之间因共享锁不互斥、零额外串行。 - 真正的收益:避免
VM_BUG_ON内核崩溃(否则该 CPU 直接 BUG/Oops,甚至带 KASAN 的现场不可用),从"系统级 off-CPU"看是避免一次整机/单 CPU 停机——这是本补丁最主要的价值。 - 并发性:共享锁设计保证高并发 O_DIRECT 写吞吐不受影响。
🔄 方案演进
v1(首版,暂无演进)
本补丁是系列 [PATCH 0/2] block device write path fixes 的第 2 篇,发布于 2026-08-02,为 v1 首版,暂无版本演进。同系列第 1 篇(block: use iomap_dirty_folio for block devices)修复的是另一个独立问题:
CONFIG_BUFFER_HEAD=n 时 def_blk_aops 用 filemap_dirty_folio 不设置 folio 的 per-block dirty 位,导致 mmap 写被静默丢失——两问题均由 Sashiko 在 RWF_DONTCACHE 系列审查中发现,彼此独立。
与上游修复脉络的关系
本补丁的
Fixes: c0e473a0d226 说明它是对已有修复的补盲:Darrick J. Wong 在 2025-04 给块设备读路径(blkdev_read_iter)、普通缓冲写路径(blkdev_write_iter 的 else 分支)、fallocate、以及若干 discard/secure erase ioctl 都加了 i_rwsem 锁,唯独漏掉了同函数里 O_DIRECT 分支的回落写。作者在 commit message 里用四线程复现器(由 LLM 编写,gist 链接附于原文)演示了崩溃调用栈,并注明"修复后同一负载干净运行"。当前主线代码(本地内核源码核实)仍是未修复形态,说明补丁尚未合入、正在 review。
💬 讨论焦点
review 现状(截至分析日)
截至 2026-08-04 检索,未发现针对本系列(blkdev-fixes-v1)的公开 review 回复(lore 检索受限期间以 patchew 镜像 + 全网检索交叉确认,系列 mbox 内仅 cover letter + 两篇补丁、无回复)。若后续维护者(如块子系统维护者 Jens Axboe / Christoph Hellwig)提出意见,本章节需要更新。以下为可考的背景事实:
- 发现者:Sashiko(
sashiko-bot@kernel.org,内核自动化审查机器人),在审查 block: enable RWF_DONTCACHE for block devices v7 系列时发现问题,与本系列相互独立。 - 作者对触发难度的自述:commit message 明确说"两个问题目前实践中都很难触发,因为需要特定配置"——这决定了本补丁的优先级判断(正确性修复、非紧急性能项)。
- 工具链细节:补丁带
Assisted-by: Claude:claude-fable-5与"复现器由 LLM 编写"的说明,作者工具链公开透明。
⚠️ 风险与局限
潜在回归 / 边界 / 失败模式
- 回归风险低:改动只是把既有共享锁(普通缓冲写分支已用)复制到回落写路径,锁的类型与作用域与既有路径完全一致;回落路径本身罕见,锁竞争面极小(解读(AI 分析))。
- 锁范围未覆盖
direct_write_fallback()的写回与失效:解锁后才执行filemap_write_and_wait_range()与invalidate_mapping_pages()。这些操作不分配新 folio、作用在已建好的区间上,与set_blocksize()的kill_bdev()相比风险很低;但严格说这段仍在锁外,是 review 时可能的关注点(解读(AI 分析))。 - 失败模式:若共享锁获取/释放配对错误会导致死锁或锁未释放,但代码是对称的 lock/unlock 且无中途 return,无该风险(解读(AI 分析))。
- 多核扩展性:共享锁不引入写写互斥,高并发 O_DIRECT 写扩展性不受影响;仅在并发 set_blocksize 时短暂串行(正常可忽略)。
严重度:MINOR(改动自身回归风险)· 原缺陷严重度:MAJOR(崩溃/数据一致性)· review 质疑:目前无公开质疑,锁范围边界为潜在关注点
🔗 交叉引用
📌 关联工作
Fixes: c0e473a0d226(block: fix race between set_blocksize and read paths) — Darrick J. Wong,2025-04;本补丁修复其遗漏的 O_DIRECT 回落路径。
block: enable RWF_DONTCACHE for block devices(v7 系列) — 同作者的前置系列;Sashiko 正是在审查它时发现本系列两个缺陷。
同系列 PATCH 1/2:block: use iomap_dirty_folio for block devices — 独立修复 CONFIG_BUFFER_HEAD=n 下 mmap 写丢失。
系列 cover letter:[PATCH 0/2] block device write path fixes — 两个独立修复的总体说明。
block: enable RWF_DONTCACHE for block devices(v7 系列) — 同作者的前置系列;Sashiko 正是在审查它时发现本系列两个缺陷。
同系列 PATCH 1/2:block: use iomap_dirty_folio for block devices — 独立修复 CONFIG_BUFFER_HEAD=n 下 mmap 写丢失。
系列 cover letter:[PATCH 0/2] block device write path fixes — 两个独立修复的总体说明。
✅ 关键洞察
- 发现:块设备 O_DIRECT 写回落路径因实参求值时机,在无锁状态下执行缓冲写,与 set_blocksize() 的独占锁竞争,触发 VM_BUG_ON_FOLIO 崩溃——是 2025 年 c0e473a0d226 锁修复的覆盖盲区。
- 证据:补丁 Fixes 标签指向 c0e473a0d226;作者给出 CONFIG_DEBUG_VM + 64K 块大小下的完整崩溃调用栈(mm/filemap.c:858);修复后同一负载干净运行;当前主线代码仍为未修复形态(本地内核源码核实)。
- 边界:需 CONFIG_DEBUG_VM + 块大小>PAGE_SIZE(CONFIG_TRANSPARENT_HUGEPAGE)+ 四线程竞态工作负载才可复现,实践中触发概率低;无性能基准(纯 bugfix)。
- 风险 / 建议:改动与既有缓冲写分支逐字对齐、回归风险极低;建议关注锁范围是否覆盖 direct_write_fallback 的写回/失效(潜在 review 点);正确性修复值得合入。
⚠️ 免责声明
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。