mm: Unconditional per-VMA locks and cleanups
💡 一句话总结
在缺页、Binder、TCP 这类频繁按地址查找/读 VMA 的负载下,内核传统的 mmap_read_lock() 每次拿**整个地址空间的全局读锁**,多线程并发时成为争用点。作者把 per-VMA 锁从"仅部分架构 + SMP + MMU"扩展到**全配置可用**,并引入 vma_start_read_unlocked() 新 API,让热路径**彻底绕开 mmap_lock**——减少全局锁争用,同时砍掉大量 #ifdef 分支。补丁未提供基准数据,收益为逻辑分析。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 + 简化) |
| 性能类别 | 锁竞争(锁粒度细化:全局 mmap_lock → 单 VMA 锁) |
| 状态 | In Review(v3) |
| 当前版本 | v3 · 当前版链接 |
| 版本演进 | v2(Dave Hansen 原稿,2026-06)→ v3(Suren 接手,2026-08-02) |
| 作者机构 | Suren Baghdasaryan (Google) |
| 提交日期 | 2026-08-02 |
| 改动范围 | 28 文件,+13/-317 行 |
| 核心函数 | vma_start_read_unlocked() / lock_vma_under_rcu() |
| 原始链接 | lore Message-ID |
📊 速览卡片
🎯 解决什么问题
vma_lookup()、page fault 的 find_vma())都要先拿 mmap_read_lock(mm)——这把**整个地址空间的读写锁**。机制缺陷:per-VMA 锁通过
ARCH_SUPPORTS_PER_VMA_LOCK Kconfig 门槛控制,仅 arm/arm64/x86 等少数架构且要求 SMP+MMU。通用代码要么不能用它(退回 mmap_lock),要么到处 #ifdef。为什么能解:per-VMA 锁的底层依赖(RCU、maple tree、refcount)在无 SMP/MMU 下也能工作,所以移除门槛在技术上是安全的。
find_vma() / vma_lookup() → Binder 按地址找 VMA → TCP 某些路径。高频触发场景:多线程进程密集访问内存(数据库、容器运行时、高并发 IPC)。每线程每次缺页/找 VMA 都要拿 mmap_lock 读锁,**多线程并发时所有线程排队等这把全局锁**。
为什么该场景遇到缺陷:mmap_lock 粒度是整个地址空间,即使各线程访问的是**不同 VMA**,也要串行等同一把锁——争用随线程数放大。per-VMA 锁只锁单 VMA,并发访问不同 VMA 可并行。
🧩 核心机制
核心逻辑点(框架 B 识别):① 移除架构门槛 ② 引入新 API ③ 调用方迁移——三者构成"让 per-VMA 锁全配置可用 + fast path 绕开 mmap_lock"的完整链条。
ARCH_SUPPORTS_PER_VMA_LOCK,改为 mm/Kconfig 统一声明(RCU/maple tree/refcount 可在无 SMP/MMU 下工作)。这是"全配置可用"的前提。逻辑点②:新 API
vma_start_read_unlocked()——把最常见惯用法 mmap_read_lock(mm); vma = vma_lookup(); ...; mmap_read_unlock(mm) 简化为 vma = vma_start_read_unlocked(mm, addr); ...; vma_end_read(vma),fast path 完全不碰 mmap_lock。这是"绕开"的实现。逻辑点③:调用方迁移——Binder 一处、TCP 一处改用新 API(cover letter 明说 cc 这两个子系统的原因)。这是"落地"。
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① 架构解耦 | 移除 ARCH_SUPPORTS_PER_VMA_LOCK | per-VMA 锁全配置可用(前提) |
| ② 新 API | vma_start_read_unlocked() | fast path 绕开 mmap_lock(实现) |
| ③ 调用方迁移 | Binder / TCP 改用新 API | 消除全局锁争用(落地) |
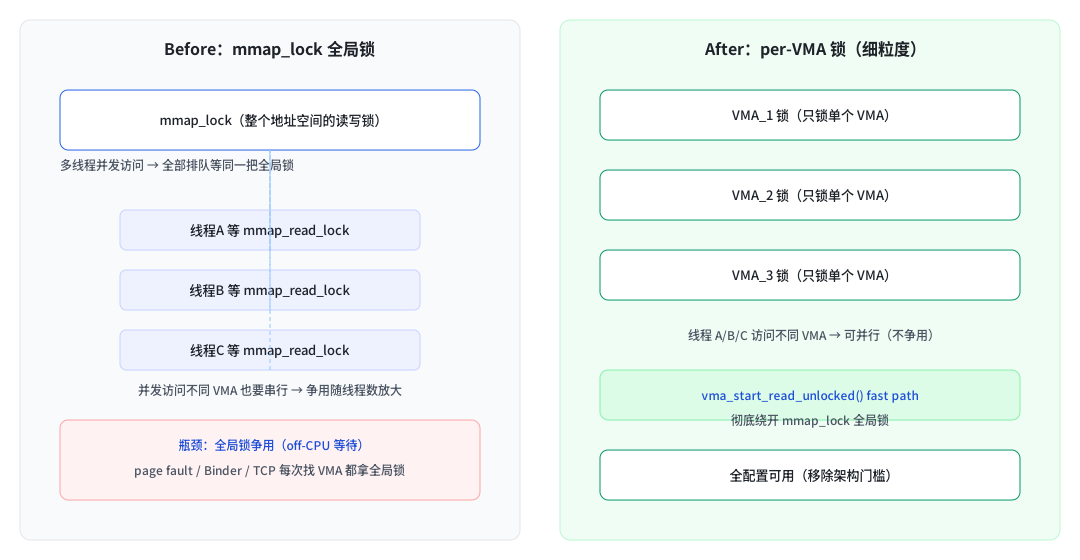
vma_start_read_unlocked() 在 fast path 彻底绕开 mmap_lock。来源:基于 lore 真实补丁 diff 绘制
🔬 关键代码
按核心逻辑点组织,每点选最能体现的 diff(非按改动大小):
diff --git a/arch/arm64/Kconfig b/arch/arm64/Kconfig
@@ -81,7 +81,6 @@ config ARM64
 	select ARCH_HAS_PTE_PROTNONE
 	select ARCH_SUPPORTS_NUMA_BALANCING
 	select ARCH_SUPPORTS_PAGE_TABLE_CHECK
-	select ARCH_SUPPORTS_PER_VMA_LOCK
 	select ARCH_SUPPORTS_HUGE_PFNMAP if TRANSPARENT_HUGEPAGE
▲ 为什么这是核心:移除架构门槛是"让通用代码能依赖 per-VMA 锁"的前提——28 文件里 Kconfig 是主体(-317 行的主要来源)。
// 传统惯用法(每次拿全局锁):
	mmap_read_lock(mm);
	vma = vma_lookup(mm, address);
	// fiddle with vma
	mmap_read_unlock(mm);

// 新 API(fast path 绕开 mmap_lock):
	vma = vma_start_read_unlocked(mm, address);
	// fiddle with vma
	vma_end_read(vma);
▲ 为什么这是核心:新 API 免去"先拿 mmap_lock 再 vma_lookup"两步,是"绕开全局锁"的实现关键。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 多线程并发访问 VMA(page fault / Binder / TCP) | 多核 | mmap_lock 全局读锁争用 | per-VMA 锁细粒度 |
说明:**补丁未提供基准数据**。收益为逻辑分析(解读(AI 分析)),依据框架 A 从执行路径推断:
① off-CPU 收益:mmap_lock 全局读锁在多线程并发时是等待点,per-VMA 锁粒度更细 → 减少锁等待(off-CPU 收益)
② on-CPU 收益:新 API 免去 vma_lookup 后的再次加锁 → 减指令(on-CPU 收益)
收益放大场景:线程数越多、VMA 访问越频繁,争用越大 → 收益越明显。单线程或低频访问场景收益趋近于零(no-op)。
🔄 方案演进
lock_vma_under_rcu() 失败后重试 VMA 锁而非退回 mmap_lock。Suren 回应(cover letter 内):Matthew(Wilcox)正在做 page-fault 代码统一重构,Barry 的建议在重构后更简单。
⚠️ 风险与局限
正确性风险:per-VMA 锁依赖 RCU + maple tree + refcount,在这些架构/配置下首次启用,需验证并发正确性(解读(AI 分析))。
待决:page fault 路径全面推广(Barry 提议,待 Matthew 重构)。
🔗 交叉引用
PATCH v3 0/5 cover letter — 系列问题/动机/方案/演进/讨论摘要
✅ 关键洞察
- 发现:per-VMA 锁全配置可用化 + 新 API 绕开 mmap_lock,是消除 VMA 热路径全局锁争用的关键步骤;顺带简化大量 #ifdef
- 证据:补丁未提供基准;收益基于"锁粒度更细"的逻辑分析(解读(AI 分析),框架 A 推断)
- 边界:!MMU / !SMP 构建 VMA 变大;收益依赖 VMA 高频访问 + 多线程场景(单线程近 no-op)
- 风险 / 建议:需关注全配置启用的并发正确性;page fault 全面推广待 Matthew 重构后
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。