sched/fair: Let sync wakeups target the waker's core
💡 一句话总结
在多核(超线程)CPU 上,一个线程写完数据、通过同步唤醒叫醒另一个线程继续干活时,调度器现在会把这个"被唤醒的线程"放到那个"即将空闲、且缓存还是热的"核心上,让它直接复用数据而不用重新从内存加载。补丁作者自报在 POWER11 上 producer-consumer 握手(-l 5)的单次访问延迟降低约 11%(作者自报、未独立验证,且 review 质疑该收益在 x86 等特定 SMT 布局下可能不成立)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 状态 | In Review(首版提交,等待维护者反馈) |
| 补丁类型 | 优化(同步唤醒路径性能优化) |
| 当前版本 | v1 · lore 链接 |
| 版本演进 | 首版,暂无演进 |
| 作者机构 | Madadi Vineeth Reddy (IBM) |
| 提交日期 | 2026-08-01 |
| 改动范围 | kernel/sched/fair.c,+38/-11 行,1 文件 |
| 核心函数 | select_idle_core() / select_idle_sibling() / select_task_rq_fair() |
| 原始链接 | lore Message-ID |
📊 速览卡片
注:+11% 为补丁作者在 commit message 中自报数据(POWER11 producer_consumer -l 5),未独立验证。
🎯 解决什么问题
为什么没做到:调度器选核时只判断"这个核现在忙不忙"。producer 所在的核此刻还在运行 producer,被判为"忙"排除在外;可 producer 马上要睡了,这个核其实"即将空闲"且缓存是热的——本该是最佳落点却被略过。
谁在解决:上游已有两个方向在探索"同步唤醒应落到 waker 附近"——Shubhang Kaushik(Ampere)从 wake-affine 分支直接返回 waker CPU(v3 限定非 SMT,因 SMT 下会把两人堆到同一硬件线程);K Prateek Nayak(AMD)把决策移进
select_idle_sibling() 的 if (!has_idle_core) 分支。本补丁作者自述在 Shubhang v2 线程上提出过自己的思路,现在独立成补丁,覆盖两者都没覆盖的情形(LLC 里有空闲核时的同步唤醒)。
select_idle_sibling(),在 LLC(最后一级缓存,多个 CPU 核共享的大缓存)里找一个空闲核放它。问题链条:同步唤醒时,内核会给调度器打一个
WF_SYNC 标志,意思是"waker 即将睡眠"。选核逻辑的早期步骤 wake_affine_idle() 本来会因此返回 waker 所在的核——但下一步 select_idle_sibling() 又把这个决定丢了:因为它逐个检查核是否空闲时,用 available_idle_cpu() 判断,而 waker 还在这核上跑着,available_idle_cpu() 返回"不空闲",于是 waker 的核被略过,扫描继续到别处找。为什么这是个缺陷:选核逻辑只懂"忙/闲"二值,表达不了第三种状态——"核正被即将睡眠的 waker 占用,马上会闲下来"。于是把本该最优的落点(即将空闲 + 缓存热)当成忙核排除。
WF_SYNC 唤醒 consumer 并即将睡眠,二者交替执行、访问同一份数据。此时 waker core 的 L1/L2 缓存中已驻留这份热点数据。为什么此场景遇到系统缺陷:waker core 当前被 waker 占用,
available_idle_cpu() 判它为忙,于是选核扫描略过它,把 wakee 放到 LLC 里另一个空闲核——这个核没有热点数据,wakee 首次访问必须从内存/上级缓存重新加载,握手延迟被放大。而 waker core 其实"即将"空闲(waker 马上阻塞),它的缓存又是热的,本该是最佳落点却因"当前 busy"被排除。
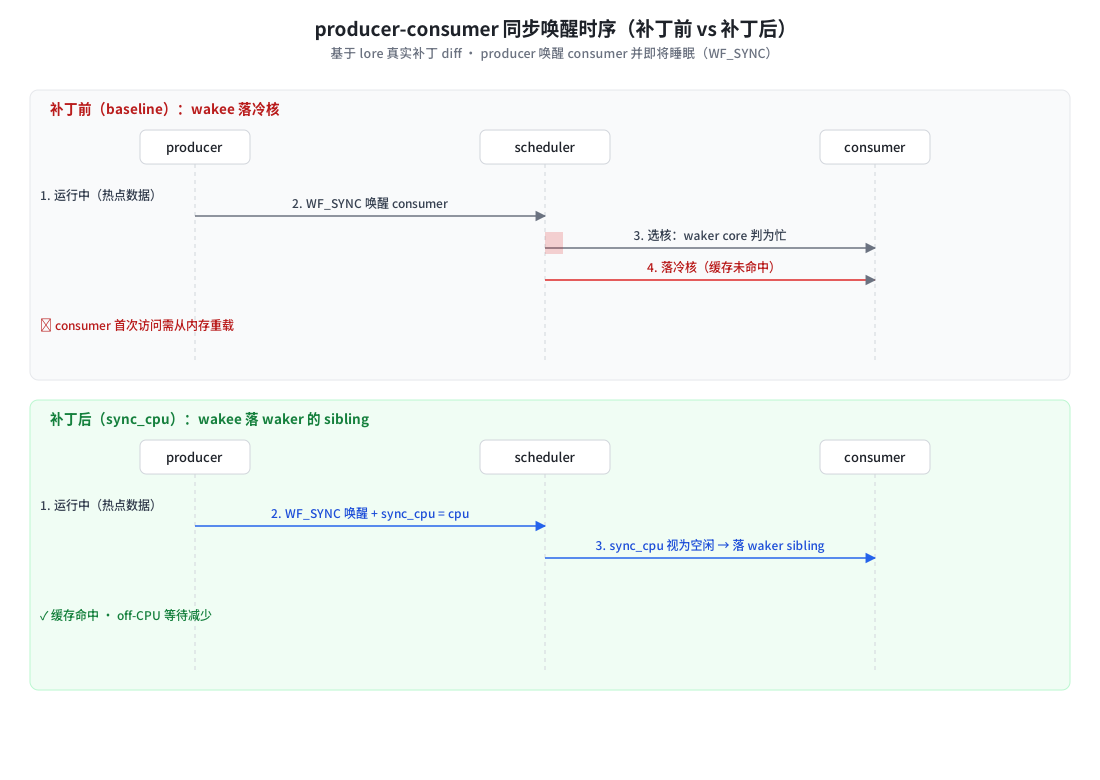
来源:基于 lore 真实补丁 diff + commit message 数据绘制
🧩 核心机制
把"即将阻塞的 waker CPU"(sync_cpu)一路传进 select_idle_core(),在检查核心是否空闲时把它当作空闲看待——于是这个核心保持"空闲核候选"资格,被唤醒的任务就落在它的兄弟线程上。
kernel/sched/fair.c 的任务唤醒路径——select_task_rq_fair() → select_idle_sibling() → select_idle_cpu() → select_idle_core()。改了啥:给这条链路的三个函数新增
sync_cpu 参数;select_task_rq_fair() 在 want_affine && sync && new_cpu==cpu 且运行队列仅 1 个可运行任务时把当前 CPU 设为 sync_cpu;select_idle_core() 遍历核心的 SMT 兄弟线程时,把 cpu==sync_cpu 视为空闲(!available_idle_cpu(cpu) && !sync_waker),同时禁止它作为兜底目标(!sync_waker && ...)。为什么要这么改 / 解决什么技术问题:选核逻辑原本只能区分"核忙/核闲"两种状态,无法表达第三种——"核正被即将睡眠的 waker 占用"。sync_cpu 用参数显式传递这一语义,让核心空闲性判断多出一个维度。技术上解决的是"扫描器对即将释放的资源视而不见"的问题:waker 所在核心即将空闲且缓存热,却被当作忙核排除。
为什么支撑场景提升:producer-consumer 握手里,wakee 落到 waker core 的兄弟线程(sibling,指同一物理核心下的兄弟硬件线程,如 Intel 超线程中的两个逻辑核;同一核心的 siblings 共享 L1/L2 缓存)后与 waker 共享 L1/L2,热点数据无需从内存重载,握手每轮省下一次缓存未命中的延迟——这正是基准里 producer_consumer -l 5(每轮工作最小、唤醒占主导)收益最大(+11%)的原因。
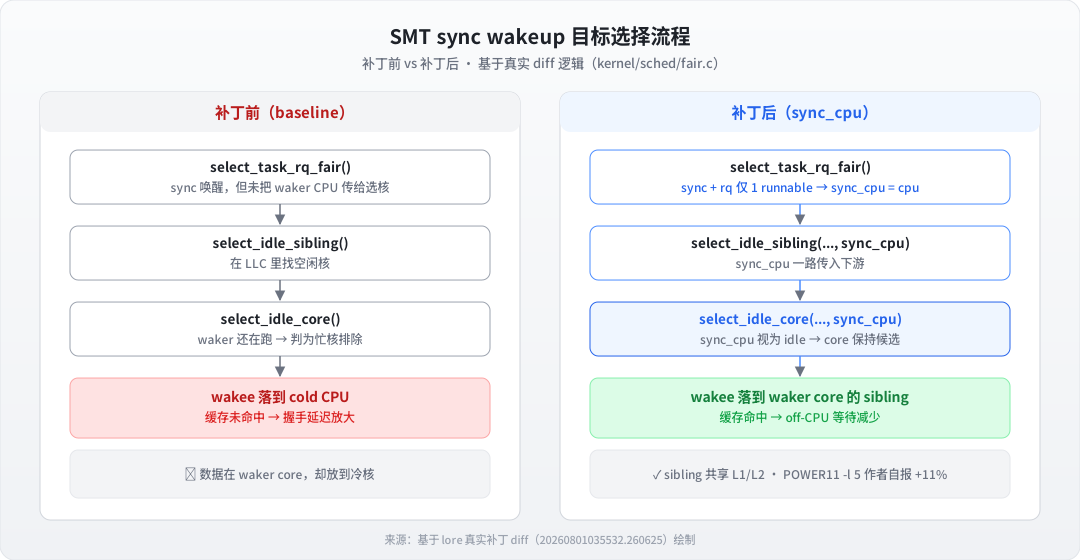
来源:基于 lore 真实补丁 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 识别 sync | want_affine && sync && new_cpu == cpu 且 rq 仅 1 runnable | 确认 waker 即将阻塞、core 即将空闲 |
| 传参 | select_idle_sibling(p, prev, new_cpu, sync_cpu) | 把 waker CPU 传入下游扫描 |
| 视为空闲 | !available_idle_cpu(cpu) && !sync_waker | waker core 保持 idle-core 候选 |
| 落核 | wakee 放在 waker core 的 sibling | 共享 cache,避免冷加载 |
🔬 关键代码
+		if (want_affine && sync && new_cpu == cpu) {
+			struct rq *rq = cpu_rq(cpu);
+
+			if ((rq->nr_running - cfs_h_nr_delayed(rq)) == 1)
+				sync_cpu = cpu;
+		}
+		return select_idle_sibling(p, prev_cpu, new_cpu, sync_cpu);
▲ 识别"waker 即将阻塞且无其他 runnable"的情形,把该 CPU 作为 sync_cpu 传入
+		bool sync_waker = (cpu == sync_cpu);
+		/* ...把即将阻塞的 waker 视为 idle,让 core 保持候选... */
+		if (!available_idle_cpu(cpu) && !sync_waker) {
 			idle = false;
 			...
 		}
-		if (*idle_cpu == -1 && cpumask_test_cpu(cpu, cpus))
+		if (!sync_waker && *idle_cpu == -1 && cpumask_test_cpu(cpu, cpus))
 			*idle_cpu = cpu;
▲ 核心:sync_cpu 视为空闲,但不作为"兜底目标"(它还没真正空闲,不能当 fallback)
📈 性能影响
数据出处:下表所有数字均来自补丁作者 Madadi Vineeth Reddy 在 commit message 中自报(POWER11,SMT8,160 CPUs / 20 cores,每组 40 任务,5 次运行取中位数,全部归一化到 baseline)。均为作者自报数据,尚未获独立第三方复现验证。
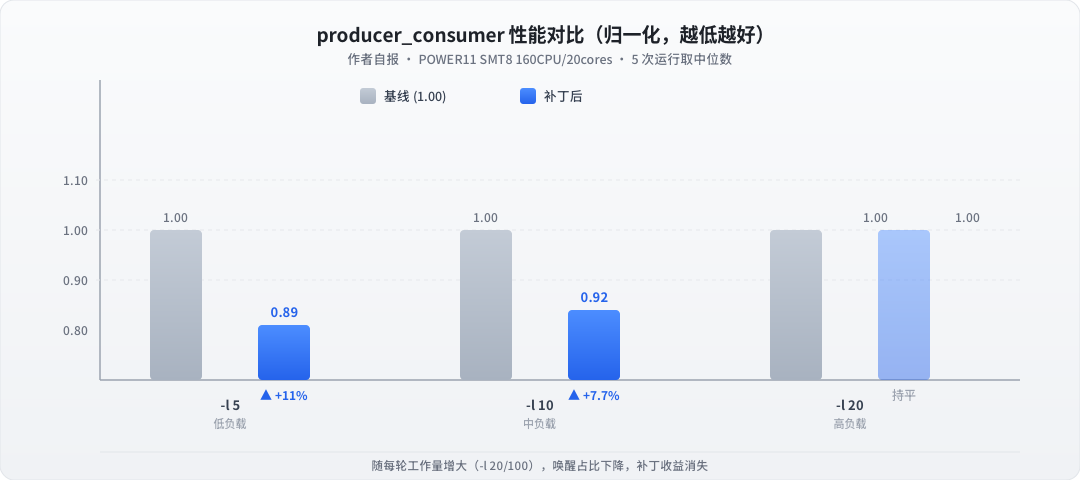
来源:补丁作者 commit message 自报数据(未独立验证)
| 场景/用例 | 运行环境 | 度量 | 基线 | 补丁后 |
|---|---|---|---|---|
| producer_consumer 严格两任务握手(-l 5,低负载) | POWER11 SMT8 160CPU/20cores | time/access(越低越好) | 1.00 | 0.89(+11%) |
| producer_consumer(-l 10) | 同上 | time/access | 1.00 | 0.92(+7.7%) |
| hackbench process-pipe 1-group | 同上 | 完成时间(越低越好) | 1.00 | 0.94(+6.4%) |
| hackbench thread-pipe 1-group | 同上 | 完成时间 | 1.00 | 0.92(+7.8%) |
| hackbench thread-pipe 4-group(高负载) | 同上 | 完成时间 | 1.00 | 1.09(-8.8% 回退) |
作者自述:随利用率升高(1-group 占 25% CPU → 8-group 达 200%)补丁收益缩水——它需要有 LLC 里的空闲核才有效;多数数字为正且在 run-to-run 波动内,仅 thread-pipe 4-group 有 -8.8% 回退。schbench p99 延迟/RPS 均在波动范围内无明显变化。
on-CPU vs off-CPU 视角(解读(AI 分析)):本补丁优化的是 off-CPU 等待环节——它减少的是 wakee 因"落冷核 + 缓存未命中"产生的等待/重载时间,而非减少 CPU 计算量(on-CPU)。producer-consumer 握手里每轮收益主要来自省下一次缓存未命中的延迟,而非省指令。补丁作者未提供 on/off-CPU 分项数据,此项为逻辑推演。
⚠️ 局限提示:以上数据仅覆盖 POWER11(SMT sibling 连续编号)。review 质疑该收益在 x86/arm64 等非连续 SMT 编号布局下可能不成立(见下文 💬 讨论焦点),目前缺少 x86/arm64 实测数据。
💬 讨论焦点
select_idle_cpu() 的实现逐层论证了收益的架构依赖:
select_idle_cpu()用for_each_cpu_wrap(cpu, cpus, target + 1)从 target+1 开始按 CPU 编号循环扫描- POWER SMT8 的 sibling 连续编号,waker 的 sibling 就在
target + 1,最先被扫到 → 正好命中"落到 waker core"的意图 - 但 x86 常见布局(sibling 在
cpu + nr_cores而非cpu + 1)下,扫描会先访问其他 core;若其中任意一个完全空闲,select_idle_core()就返回那个 cold core(没有热点数据的核) - 结论:缓存共享收益可能 主要特定于连续编号的 SMT;x86/arm64 下收益能否实现存疑
select_idle_sibling()。本补丁定位为覆盖"LLC 中有空闲核"这一不相交情形,无空闲核时 no-op,且自述此思路曾在 Shubhang v2 线程讨论过。
🔗 交叉引用
K Prateek Nayak(AMD)— 同主题 (v3) — 把决策移进 select_idle_sibling() 的 if (!has_idle_core) 分支,优先 prev 的 idle sibling 再堆 waker
⚠️ 风险与局限
高负载回退:thread-pipe 4-group 有 -8.8% 回退(作者自报),随利用率升高(8-group 达 200% CPU)收益消失——它需要有 LLC 里的空闲核。
边界(no-op 情形,作者自述):waker core 无 idle sibling / waker rq 多个 runnable / prev_cpu 已有效 / 非 SMT 系统——这些情形补丁不改变行为。
✅ 关键洞察
- 发现:sync 唤醒时把"即将空闲的 waker core"视为 idle 候选,wakee 落在其 sibling 上复用热 cache(off-CPU 等待减少,非计算减少)
- 证据:作者自报 POWER11 producer_consumer -l 5 提升 +11%、hackbench 多数场景 +3~8%(未独立验证)
- 边界:4 个 no-op 条件(waker core 无 idle sibling / rq 多个 runnable / prev_cpu 已有效 / 非 SMT)
- 风险 / 建议:收益可能仅限 SMT sibling 连续编号的架构(POWER);建议补测 x86/arm64 SMT2 数据验证 Zhan 的质疑;thread-pipe 4-group -8.8% 回退需关注
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。