mm: optimize zone-device memmap initialization
内存管理 · ZONE_DEVICE memmap 初始化优化 · 模板复用 + 非时间局部性拷贝
💡 一句话总结
在绑定/重绑大容量 PMEM(持久内存)命名空间时,内核需逐页初始化几乎相同的 struct page 描述符,耗时明显。本系列通过复用"模板页"避免逐页重复初始化,并在 x86 上用 memcpy_nontemporal() 非时间局部性拷贝,使 memmap 初始化耗时在 nd_pmem rebind 场景降低约 60%(作者实测:244.28ms → 96.79ms)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能) |
| 性能类别 | 内存初始化(memmap 逐页初始化的重复工作消除) |
| 状态 | In Review(v9) |
| 当前版本 | v9 · v9 cover letter |
| 版本演进 | v1(2026-05-15)→ ... → v8(2026-07-27)→ v9(2026-08-03) |
| 作者机构 | Li Zhe (ByteDance) |
| 提交日期 | 2026-08-03 |
| 改动范围 | 4 文件,+200/-28 行(mm/mm_init.c 为主 +132) |
| 核心函数 | memmap_init_zone_device() / memcpy_nontemporal() |
| 原始链接 | lore Message-ID |
📊 速览卡片
核心机制
模板页复用
优化目标
memmap 初始化
适用场景
大 PMEM 绑定
实测提升
-60.4%
🎯 解决什么问题
背景 / 原始动机
memmap_init_zone_device() 在绑定/重绑大容量 pmem 命名空间时耗时明显,因为它**逐 PFN 初始化几乎完全相同的 struct page 描述符**。cover letter 原话:"it initializes nearly identical struct page descriptors one PFN at a time."
系统层面:ZONE_DEVICE memmap 逐页初始化冗余
执行路径:
机制缺陷:相邻页的描述符几乎相同(同一 ZONE_DEVICE 区域、同一 pgmap/nid),只有少数 PFN 相关字段(section bits、page->virtual)不同。逐页完整初始化是大量重复工作。
memmap_init_zone_device() 对每个 PFN 调 zone_device_page_init_slow() 完整初始化。机制缺陷:相邻页的描述符几乎相同(同一 ZONE_DEVICE 区域、同一 pgmap/nid),只有少数 PFN 相关字段(section bits、page->virtual)不同。逐页完整初始化是大量重复工作。
场景层面:执行路径 → 高频场景 → 为什么遇到缺陷(框架 A)
执行路径:PMEM 命名空间绑定/重绑 →
高频触发场景:大容量 fsdax/devdax PMEM 配置(如 100GB)。用户空间操作(provisioning、热插拔 PMEM 上线、设备恢复/重绑)都**同步等待**初始化完成。
为什么该场景遇到缺陷:命名空间越大,逐页初始化的重复工作越多,同步等待越久。NDN 场景(本机持久内存,非远端)尤其明显。
收益放大硬件:PMEM 容量大(重复页多)+ 无 MMU 免 x86 加速时仍得模板复用收益(arm64 实测 -56.8%)。
memremap_pages() → memmap_init_zone_device()(同步 probe/bind 路径)。高频触发场景:大容量 fsdax/devdax PMEM 配置(如 100GB)。用户空间操作(provisioning、热插拔 PMEM 上线、设备恢复/重绑)都**同步等待**初始化完成。
为什么该场景遇到缺陷:命名空间越大,逐页初始化的重复工作越多,同步等待越久。NDN 场景(本机持久内存,非远端)尤其明显。
收益放大硬件:PMEM 容量大(重复页多)+ 无 MMU 免 x86 加速时仍得模板复用收益(arm64 实测 -56.8%)。
受影响负载:大 DAX/PMEM 设备 provisioning / hot-add / recovery / rebind · 因果:memmap 逐页初始化冗余 → 大设备时延明显
🧩 核心机制
核心逻辑点(框架 B 识别):① 模板复用 ② 非时间局部性拷贝——"减少重复初始化" + "减少缓存污染"。
从系统层面看
逻辑点①:模板复用(Patch 4-5)——第一页走慢速路径,结果存
逻辑点②:非时间局部性拷贝(Patch 6-8)——x86 上
template;后续页 zone_device_page_init_from_template():先更新 PFN 相关字段(zone_device_page_update_template()),再 memcpy(page, template, sizeof(*page))。消除"逐页重复计算字段"的 CPU 开销。逻辑点②:非时间局部性拷贝(Patch 6-8)——x86 上
memcpy_nontemporal() 映射到 memcpy_flushcache()(MOVNTI),避免污染缓存(这些 struct page 短期不会再用)。消除"写满缓存"的带宽开销。
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① 模板复用 | memcpy(&template, page, ...) → 复用 | 免逐页初始化(减 CPU 开销) |
| ② 非时间拷贝 | memcpy_nontemporal() | 免污染缓存(减带宽开销) |
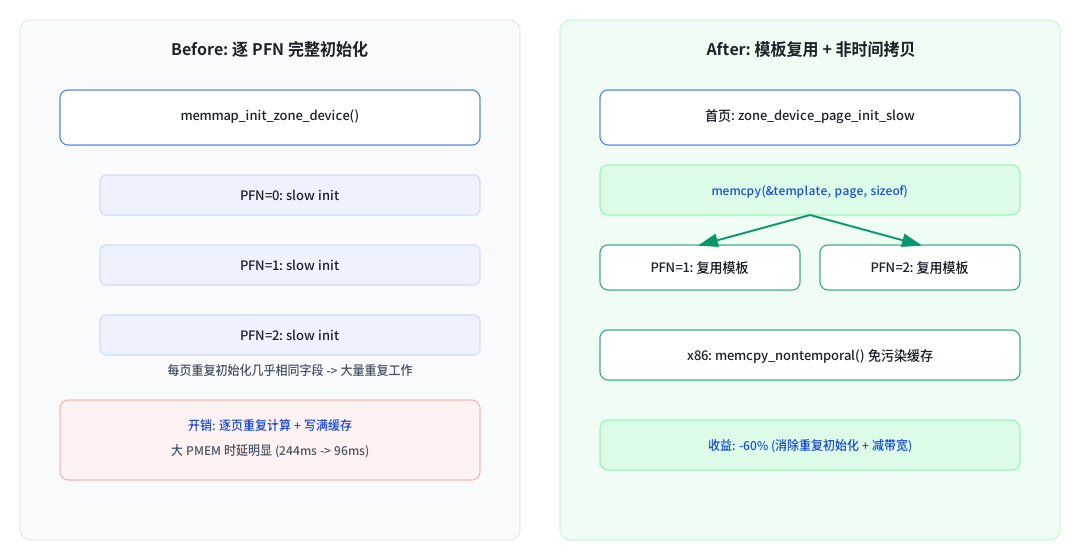
memcpy_nontemporal() 免污染缓存,叠加带来 -60% 提升。来源:基于 lore 真实补丁 diff 绘制
🔬 关键代码
按核心逻辑点组织,每点选最能体现的 diff:
逻辑点①:模板复用(体现"消除逐页重复初始化")
@@ -1144,7 +1174,22 @@ void __ref memmap_init_zone_device(struct zone *zone,
 	for (pfn = start_pfn; pfn < end_pfn; pfn += pfns_per_compound) {
 		struct page *page = pfn_to_page(pfn);

-		zone_device_page_init_slow(page, pfn, zone_idx, nid, pgmap);
+		if (pfn == start_pfn) {
+			/* Seed the reusable head-page template */
+			zone_device_page_init_slow(page, pfn, zone_idx, nid, pgmap);
+			memcpy(&template, page, sizeof(*page));
+		} else {
+			zone_device_page_init_from_template(page, pfn, &template);
+		}
▲ 为什么这是核心:首页走慢速路径作模板,后续页直接 memcpy 复用——这是 -60% 提升的关键(消除逐页重复初始化)。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| nd_pmem rebind(100GB fsdax) | Intel Ice Lake VM | 244.28 ms | 96.79 ms(-60.4%) |
| dax_pmem rebind(100GB devdax) | Intel Ice Lake VM | 273.31 ms | 119.04 ms(-56.4%) |
| nd_pmem rebind(100GB fsdax) | 物理机 x86_64 | 179 ms | 82 ms(-54.2%) |
| nd_pmem rebind | arm64 QEMU(无 MOVNTI) | 25.60 ms | 11.07 ms(-56.8%) |
说明:数据为**作者自报**(cover letter,未独立验证)。度量 memmap_init_zone_device() 时间,非完整 bind/rebind 操作。
收益推断(框架 A):模板复用消除的是"逐页重复计算字段"的 CPU 开销(on-CPU 收益),非时间拷贝消除的是"写满缓存"的带宽开销(内存带宽收益),二者叠加是 -60% 的关键(解读(AI 分析))。arm64 结果证明无 MOVNTI 时模板复用仍有效,说明主要收益来自逻辑点①。
🔄 方案演进
本系列 v1→v9 历经约 2.5 个月、8 次迭代(2026-05-15 至 08-03):
关键演进(v8→v9 为例)
v8→v9(cover letter changelog):合并移除本地非模板 fallback 的清理 patch;重排 memcpy_nontemporal() 顺序使 x86 patch 直接展示收益;用真实 ZONE_DEVICE 初始化数据替代独立 microbenchmark;补 arm64 QEMU 实测。
⚠️ 风险与局限
潜在回归 / 并发 / 边界
拷贝语义:
架构依赖:x86 MOVNTI 加速是额外收益;无专用后端架构回退 memcpy,仍得模板复用收益。
正确性:模板复用假设相邻页字段几乎相同——PFN 相关字段已单独更新(zone_device_page_update_template)。
memcpy_nontemporal() 只是拷贝原语,不含 drain/发布屏障——调用方若在 producer-consumer 交接前用需自备排序。本路径仅初始化 struct page 元数据,无此问题(cover letter 明说)。架构依赖:x86 MOVNTI 加速是额外收益;无专用后端架构回退 memcpy,仍得模板复用收益。
正确性:模板复用假设相邻页字段几乎相同——PFN 相关字段已单独更新(zone_device_page_update_template)。
严重度:MINOR · review 焦点:memcpy_nontemporal 的发布语义、x86 固定大小 fastpath 是否值得
🔗 交叉引用
📌 关联工作
block: introduce dma map backed bio type — 同日报另一篇"减少反复映射"优化(DMA 侧)
PATCH v9 0/8 cover letter — 完整问题/方案/基准/演进
PATCH v9 0/8 cover letter — 完整问题/方案/基准/演进
✅ 关键洞察
- 发现:模板页复用 + 非时间拷贝,消除 ZONE_DEVICE memmap 逐页初始化的重复工作,是 PMEM 绑定热路径的关键优化
- 证据:nd_pmem rebind -60.4%(VM)、-54.2%(物理机)、arm64 -56.8%(作者自报,cover letter)
- 边界:x86 MOVNTI 是额外收益,无后端架构仍得模板复用收益;仅初始化元数据路径
- 风险 / 建议:memcpy_nontemporal 发布语义需注意;跨 8 版本演进说明 review 严格,值得跟进合并
⚠️ 免责声明
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。