arm64: preempt: Simplify and optimize __preempt_count_dec_and_test()
💡 一句话总结
在 arm64 上,preempt_enable() / preempt_enable_notrace() 每次执行临界区出口时都要调用 __preempt_count_dec_and_test()——一个递减"禁止抢占计数器"并判断"是否该调度"的热函数。旧实现为"计数器恰好减到 0 且已有人请求调度"这种罕见情况特设了一条捷径,结果常见路径反而被编译器塞进 2 个条件分支,慢路径(preempt_schedule_notrace())也无法干净外提。补丁删掉这个特判,改成"先递减 count、再统一重读 64 位合一值判断是否为 0"的写法,使常见路径收敛为单个 not-taken 分支 + 慢路径整体外提,语义完全等价。作者明确表示尚未做基准测试(RFC 原话 "I haven't had the chance to benchmark this"),唯一证据是 GCC 15.2.0 编译前后代码生成对比:常见路径条件分支数从 2 降到 1。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 · 热路径减分支/减指令,行为等价重构) |
| 性能类别 | 热路径(preempt_count 递减热路径的代码生成优化,不改变语义) |
| 状态 | In Review(RFC v1;截至 Linux 7.2-rc6 未合入 mainline,本地 git 仍为旧实现) |
| 当前版本 | v1(RFC)· 当前版链接 |
| 版本演进 | 首版 RFC(2026-07-28),暂无演进 系列共 13 补丁:[RFC PATCH 00/13] arm64: Preemptible this_cpu_*() operations |
| 作者机构 | Mark Rutland(Arm) |
| 提交日期 | 2026-07-28 |
| 改动范围 | arch/arm64/include/asm/preempt.h,+11/-18 行,1 文件 |
| 核心函数 | __preempt_count_dec_and_test() / __preempt_count_sub() / should_resched() |
| 原始链接 | lore Message-ID: 20260728123859.2911495-2-mark.rutland@arm.com |
Reviewed-by: Jinjie Ruan <ruanjinjie@huawei.com>。arm64 维护者 Will Deacon / Catalin Marinas 在本补丁下尚无公开回复(截至 lore 索引 2026-08-03)。
📊 速览卡片
🎯 解决什么问题
preempt_disable() 把计数 +1,离开时 preempt_enable() 把计数 -1。只有计数减到 0(锁完全释放)且"有更高优先级的任务正在等我让出 CPU"(need_resched 被置位)时,才需要主动调用调度器切换。这个"减一 + 判断"就是 __preempt_count_dec_and_test() 干的事。本补丁是 13 补丁系列 "arm64: Preemptible this_cpu_*() operations" 的第 1 个(cover letter 明说"Patches 1 and 2 are complete as-is, and can be taken without the rest of the series")。系列整体目标是让 arm64 的
this_cpu_*()(per-CPU 变量访问)不再需要临时禁抢占,从而免掉每次 percpu 访问都要 preempt_disable()/preempt_enable() 的开销。本补丁负责把 preempt_enable() 的出口判断本身做干净——它是系列所有收益的地基。动机里还有一个 s390 先例:Heiko Carstens 已在 s390 上优化过同名函数(s390/preempt: Optimize __preempt_count_dec_and_test()),系列 cover letter 引用其系列作为参考 [1]。arm64 因为 thread_info 把 count 和 need_resched 放在同一个 64 位 union 里,问题形态与 s390 不同(详见下)。
preempt_disable()...preempt_enable() 临界区出口 → preempt_enable[_notrace]() → unlikely(__preempt_count_dec_and_test()) → 若返回真则调用 preempt_schedule[_notrace]() 让出 CPU。arm64 的 thread_info 布局:低 32 位是
count(禁抢占嵌套计数),高 32 位是 need_resched(0=需要调度,1=不需要,反逻辑编码)。两者拼在一个 64 位 preempt_count union 里,因此"减 count + 看 need_resched"可以用一次 64 位读写完成。机制缺陷:旧实现
return !pc || !READ_ONCE(ti->preempt_count) 里的 !pc 特判——"递减后整值恰好为 0"(即 count 原本为 1 且 need_resched 原本为 0)——只在罕见情况下成立(作者分析:count 为 1 的嵌套临界区不存在 + 恰好同时有人请求调度)。但为了跳过这个罕见情况下的第二次重读,编译器不得不在常见路径上放一条 cbz 条件分支。结果常见路径变成"cbz(不跳) → 重读 → cbnz(跳走)"的 2 分支结构,慢路径也无法整体外提。
preempt_enable() 是内核最高频的出口之一。它由 preempt_disable() 的反向配对触发,而禁抢占几乎无处不在——自旋锁/位图锁的临界区、this_cpu_*() per-CPU 变量访问、RCU 读侧、本地中断保护、perf/tracing 计数、调度统计等。arm64 上 this_cpu_*() 每次访问都临时禁抢占(这正是本系列要消除的),因此 percpu 计数器、per-cpu 队列、NUMA 统计这类高频路径会反复执行这段递减判断。为什么遇到缺陷:这段判断越高频,多出的那条条件分支(取指 + 预测 + 可能的推测执行)被重复的次数就越多;且 2 分支 + 慢路径内联混排会占用 I-cache,压低热路径命中率。注意收益属于 on-CPU 环节(减少指令执行/分支开销),不涉及锁等待、调度延迟等 off-CPU 因素——慢路径本身(真要去调度)没变快,变快的是"判断要不要走慢路径"这件事。
🧩 核心机制
核心逻辑点(框架 B 识别):① 删除 !pc 特判捷径 ② 改为"递减 count + should_resched(0) 统一重读"——①是消除多余分支的根源,②是让慢路径可被干净外提的关键。
!pc),否则才重读 64 位合一值。新代码无条件走 __preempt_count_sub(1)(只减低 32 位 count),再 should_resched(0) 统一重读合一值判断 pc == 0。为什么能支撑收益:删掉特判后,编译器看到"无论哪种情况都要重读合一值",于是:①不再需要为"跳过重读"发
cbz;②判断条件收敛为单一的 pc == 0,配合外层 unlikely() 提示,慢路径(preempt_schedule_notrace())可以被整体搬到函数末尾的冷区(out-of-line),常见路径是一条不跳转的 cbz + ret 直通。语义为何不变:返回值真 ⟺ 递减后
count == 0 且 need_resched == 0(需要调度)。旧代码靠"!pc(罕见捷径)+ 重读后 !preempt_count"两条路返回真;新代码靠 should_resched(0) 一条路覆盖全部。作者在注释里保留了关键不变式:必须在递减 count 之后重读合一值——因为中断可能在"读 count"与"写 count"之间把 need_resched 清 0(有人请求调度),重读保证看到最新状态。代价:罕见情况(count 原本为 1 且已有人请求调度)下,新代码会多执行一次 64 位重读 load;作者认为该路径本就快进入调度慢路径,成本被其他因素主导。
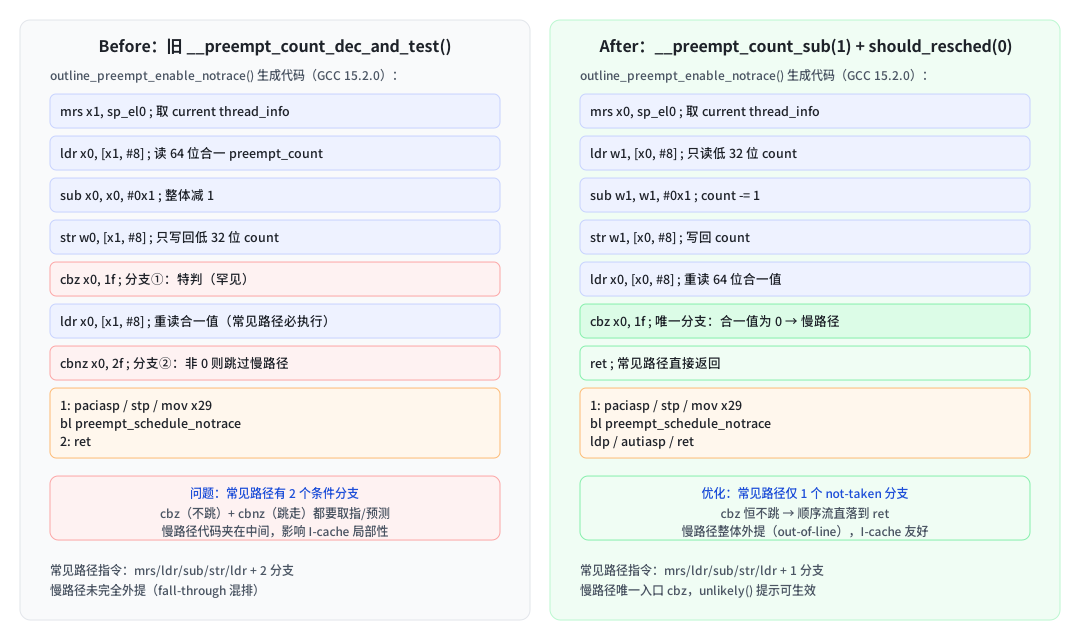
preempt_enable_notrace() 的生成代码对比(GCC 15.2.0)。左边旧实现常见路径有 cbz + cbnz 两条条件分支、慢路径混排;右边新实现常见路径只留一条不跳转的 cbz,慢路径整体外提到 1: 冷区。来源:基于 lore 真实补丁 commit message 中的汇编示例(GCC 15.2.0)绘制
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① 删特判 | __preempt_count_sub(1); return should_resched(0); | 去掉 !pc 罕见捷径,常见路径不再被"跳过重读"的分支污染 |
| ① 统一重读 | should_resched(0) → READ_ONCE(ti->preempt_count) == 0 | 递减 count 后重读合一值,既看到最新 need_resched,又给编译器单一出口条件 |
| ② 慢路径外提 | 配合 unlikely(),cbz x0, 1f 跳转到函数末尾冷区 | 常见路径直通 ret,I-cache 局部性更好,分支预测压力更小 |
🔬 关键代码
diff 逐字来自 lore 真实补丁(RFC v1),按核心逻辑点组织:
diff --git a/arch/arm64/include/asm/preempt.h b/arch/arm64/include/asm/preempt.h
index 932ea4b620428..ca2ad1a8db095 100644
--- a/arch/arm64/include/asm/preempt.h
+++ b/arch/arm64/include/asm/preempt.h
@@ -55,30 +55,23 @@ static inline void __preempt_count_sub(int val)
 	WRITE_ONCE(current_thread_info()->preempt.count, pc);
 }

-static inline bool __preempt_count_dec_and_test(void)
-{
-	struct thread_info *ti = current_thread_info();
-	u64 pc = READ_ONCE(ti->preempt_count);
-
-	/* Update only the count field, leaving need_resched unchanged */
-	WRITE_ONCE(ti->preempt.count, --pc);
-
-	/*
-	 * If we wrote back all zeroes, then we're preemptible and in
-	 * need of a reschedule. Otherwise, we need to reload the
-	 * preempt_count in case the need_resched flag was cleared by an
-	 * interrupt occurring between the non-atomic READ_ONCE/WRITE_ONCE
-	 * pair.
-	 */
-	return !pc || !READ_ONCE(ti->preempt_count);
-}
-
 static inline bool should_resched(int preempt_offset)
 {
 	u64 pc = READ_ONCE(current_thread_info()->preempt_count);
 	return pc == preempt_offset;
 }

+static inline bool __preempt_count_dec_and_test(void)
+{
+	/*
+	 * We must load the combined 'prempt_count' after decrementing
+	 * 'preempt.count' as an interrupt could modify 'need_resched' before
+	 * __preempt_count_sub() writes back to 'preempt.count'.
+	 */
+	__preempt_count_sub(1);
+	return should_resched(0);
+}
+
 #ifdef CONFIG_PREEMPTION

 void preempt_schedule(void);
▲ 为什么这么改:被删的旧实现里 u64 pc = READ_ONCE(ti->preempt_count) 读的是 64 位合一值,而 WRITE_ONCE(ti->preempt.count, --pc) 只写低 32 位 count——--pc 先整体减 1,写回时只取低 32 位。于是 !pc(减后整值为 0)只有在"count 原本为 1 且 need_resched 原本为 0"时才成立,编译器为这个罕见捷径在常见路径上多塞了一条 cbz。新实现用 __preempt_count_sub(1)(只读/写 count 一个 u32)+ should_resched(0)(重读合一值判断 == 0)表达完全相同的语义,但消除了特判。
关键一行:return should_resched(0)——返回值真 ⟺ 递减后合一值 == 0(count 归零且 need_resched 为 0,即"刚好可抢占且需要调度")。新注释里刻意保留了"必须在递减后重读合一值"的不变式(对应旧注释里"中断可能在 READ/WRITE 之间清掉 need_resched"的竞态说明),并保留了一个原样的拼写笔误 'prempt_count'。
📈 性能影响
| 场景/用例 | 运行环境 | 指标 | Before(旧) | After(新) |
|---|---|---|---|---|
| preempt_enable_notrace() 常见路径 | GCC 15.2.0 编译(commit message 示例) | 常见路径条件分支数 | 2(cbz + cbnz) | 1(cbz) |
| preempt_enable_notrace() 常见路径 | 同上 | 慢路径布局 | 混排(fall-through 进入 1:) | 整体外提(out-of-line) |
| 全系列 defconfig Image 大小 | defconfig,v7.2-rc4 基线(cover letter) | Image 大小 | 41,617,920 B | 41,552,384 B(-64K) |
| 全系列 defconfig .text 大小 | 同上 | .text 大小 | 20,331,206 B | 20,323,522 B(约 -7.5K) |
说明:本补丁未提供任何运行时基准数据——作者在 cover letter 的 RFC 原因 (1) 明确写 "I haven't had the chance to benchmark this. While I think the changes look good from inspection, we should obviously get some actual performance figures."(作者自报,未独立验证)。前两行是 commit message 里给出的代码生成对比(GCC 15.2.0,属"生成代码形态"而非端到端吞吐);后两行是 cover letter 里整个 13 补丁系列的 defconfig 尺寸对比(不是本补丁单独的效果),引用时已标注范围。
on-CPU vs off-CPU 视角:本补丁优化的是 on-CPU 环节——减少 preempt_enable 常见路径的条件分支数(2→1)并让慢路径外提,属于指令执行/分支预测/I-cache 范畴,不涉及锁等待或调度延迟。off-CPU 的调度切换成本(preempt_schedule_notrace() 本身)完全不变。端到端收益需独立基准验证(解读(AI 分析)):从路径推断,this_cpu_*()/自旋锁/RCU 读侧等 preempt 临界区高频负载最可能受益,但缺少实测数字,无法量化。
🔄 方案演进
本补丁目前为单版本(RFC v1),暂无演进;方案整体脉络放在系列上下文里说明:
已获 Jinjie Ruan Reviewed-by(2026-07-29)。作者在 cover letter 中说明 patch 1/2 可独立于系列先合入,其余补丁(实现 preemptible this_cpu_*() 的"PCPU GPR 临界区"方案,见 patch 6)仍在设计/讨论中;RFC 的 (2)(3) 点(SDEI 异常入口未接好、this_cpu_read 是否用 LDA[P]R)与本补丁无关。
⚠️ 风险与局限
!pc 捷径跳过)。作者主张该成本被"即将进入调度慢路径"的主导因素掩盖,此判断合理但未经测量。依赖编译器与优化提示(解读(AI 分析)):收益的实现依赖编译器能否把慢路径外提——commit message 展示了 GCC 15.2.0 的效果,但 clang、老版本 GCC、不同
inline/unlikely() 处理下是否同样干净外提未验证;若编译器选择内联展开而非外提,收益形态可能变化。语义等价性依赖"递减后重读"不变式:新实现把竞态保证集中到
should_resched(0) 的重读上。若未来有人把 __preempt_count_dec_and_test() 改成"减完不重读"或把 should_resched() 改成从低 32 位判断,会破坏"中断可能清 need_resched"的正确性(当前补丁注释已明确标注,风险低)。并发/多核扩展性(解读(AI 分析)):本改动不引入锁、不新增共享状态、无原子操作差异,per-CPU 的 thread_info 依旧只被本 CPU 读写的语义不变;扩展性与旧实现一致。
未基准验证:作者明确表示尚未跑 benchmark,这是当前最大的不确定性——优化方向符合代码生成直觉,但缺少实测数据支撑。
🔗 交叉引用
Jinjie Ruan Reviewed-by — 唯一公开 review,确认分析并 Reviewed-by
s390/preempt: Optimize __preempt_count_dec_and_test() — Heiko Carstens 在 s390 上的同名优化(2024-12,+1/-1,用 flag 输出约束单指令完成减+测),是系列的参考先例之一
s390/preempt: Optimize __preempt_count_dec_and_test()(2026-01) — Heiko Carstens 后续迭代(改用 alternatives 避免低核基址),同类"减 preempt_count + 测 need_resched"热路径优化
✅ 关键洞察
- 发现:arm64 旧
__preempt_count_dec_and_test()的!pc特判(罕见捷径)反而污染了常见路径的代码生成——preempt_enable 常见路径因此多一条条件分支、慢路径无法外提;补丁用__preempt_count_sub(1) + should_resched(0)统一重读,语义等价但代码生成干净 - 证据:commit message 的 GCC 15.2.0 代码生成对比(作者自报,未独立验证)——常见路径条件分支从 2(
cbz+cbnz)降到 1(cbz),慢路径整体外提;无运行时基准数据,作者明确说还没机会 benchmark - 边界:仅 arm64 生效;罕见路径(count 原本为 1 且已请求调度)多一次重读 load;收益形态依赖编译器能否外提慢路径(GCC 15.2.0 已验证,clang 等未验证)
- 风险 / 建议:优化方向正确但缺实测,建议合入前用 hackbench/lmbench/sysbench 等 preempt 临界区密集负载补基准;本补丁为系列第 1 块基石,可独立先行合入(作者已声明),后续补丁值得持续跟踪其性能验证结果
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。