bpf: Optimize string kfuncs
💡 一句话总结
在 eBPF 字符串 kfunc(bpf_strnchr / bpf_strcmp / bpf_strcspn / bpf_strnstr 等)的扫描热路径上,原实现逐字节 nofault 加载使长串搜索的开销随字符串长度线性放大;本系列借用内核 word-at-a-time(寄存器内 SIMD / SWAR)技巧,把扫描从"每 1 字节 1 次加载 + 1 次比较"改为"每 8 字节 1 次对齐字加载 + 位掩码并行判定",作者自报在 512–2048 字节长串上提速 2.03x–11.30x、bpf_strnstr 整体约 10x(作者自报,未独立验证);但 Andrii Nakryiko 评审认为"代码与复杂度不值",作者同意并撤回系列、未合入(本地 7.2-rc6 内核确认无此改动)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 / hot-path) |
| 状态 | Rejected / 作者撤回(RFC v1,评审后主动放弃;本地 7.2-rc6 无此改动) |
| 当前版本 | RFC v1 1/6(唯一版本) · scan 补丁 lore 链接 |
| 版本演进 | 首版(2026-07-28,[RFC PATCH bpf-next 0/6],6 补丁)。作者在评审后同意撤回,无后续版本。 |
| 作者机构 | Leon Hwang(linux.dev,Isovalent 系 BPF 开发者) |
| 提交日期 | 2026-07-28 |
| 改动范围 | 系列 6 补丁:kernel/bpf/helpers.c 557 行变更 + selftests 400 行新增;4 个核心优化补丁 = scan +141/-39、compare +57/-15、span +121/-54、substring +111/-31 |
| 核心函数 | bpf_str_for_each_word() / bpf_str_find() / __bpf_strncasecmp() / __bpf_strspn() / __bpf_strnstr() |
| 原始链接 | cover letter · scan 1/6 · compare 2/6 · span 3/6 · substring 4/6 |
注:4 个补丁均含 Assisted-by: Codex:gpt-5.6-sol,为 LLM 辅助开发(cover letter 明言 "with LLM assistance, I optimized all string kfuncs")。
📊 速览卡片
🎯 解决什么问题
bpf_strnstr() kfunc 的性能不如他自己用 SWAR(SIMD Within A Register,寄存器内 SIMD)思路手写的纯 BPF 实现(bpf_swar_benchmark)。作者搭了同一套 microbench 复现:在 16 核 16GiB QEMU 虚拟机里跑 "BPF HTTP Host search"(在 HTTP 头里搜 Host 字段场景),基线 kfunc 比逐字节实现快 1.43x–2.69x,但 SWAR 手写实现更快(2.00x–4.36x)——内核自带 kfunc 反而慢于用户手写。这暴露了"字符串扫描类 kfunc 是热路径但从未被优化"的痛点。
kernel/bpf/helpers.c 中仍是原版,见下)对每个字节执行一次 __get_kernel_nofault()——该宏要处理页边界/异常表等安全开销,一次调用比普通内存读贵;再逐字节比较、指针自增、循环回边。对长度为 N 的字符串,内存访问次数 = N,且无法跳过任何无关字节。这是典型的"能工作但热路径次优"实现。
Host:)、bpf_strnstr 在数据包里搜子串、bpf_strcspn/bpf_strspn 做分隔符/字符集扫描、bpf_strnlen 量长度。这类负载的特征是单次处理的数据可达数百到数千字节(如完整 HTTP 请求头),且每个包/事件都执行一次——扫描越长,逐字节开销越被放大。作者基准里的 "middle/late/absent" 场景(512/1536/2048 字节、目标在尾部或缺失)正是这类负载的形状。
🧩 核心机制
一句话:把"每字节一次 nofault 加载 + 比较"改成"每次一个对齐 8 字节字加载,再用位掩码技巧在寄存器内同时判定 8 个字节是否为目标字符或 NUL"。这正是 SWAR 思路——不依赖 SIMD 指令集,只用普通整数运算模拟"一次处理多个字节"。
| 补丁 | 改了什么 | 为什么快 |
|---|---|---|
| 1/6 scan | 新增 bpf_str_for_each_word() 展开宏(对齐→字循环→字节回退三阶段)+ 共享查找器 bpf_str_find(),改造 bpf_strnchr/bpf_strchrnul/bpf_strrchr/bpf_strnlen | strchr/strlen 家族从 N 次加载降到 N/8 次 |
| 2/6 compare | __bpf_strncasecmp() 在两个操作数相对对齐相同时走字比较:word1 == word2 直接整字跳过 | 前缀相同场景跳过整字,只在失配字节处展开比较 |
| 3/6 span | bpf_strspn/bpf_strcspn 共用 __bpf_strspn(),用懒加载的 256-bit 位图缓存字符集成员;发现"单一拒绝字符集"时改走 bpf_str_find() 快速路径 | 每个 accept/reject 字符只 nofault 加载一次,源串按字扫描 |
| 4/6 substring | __bpf_strnstr() 先用 bpf_str_find() 定位 needle 首字节,再在候选点用 bpf_str_match_at() 字匹配验证 | haystack 中不可能开头的区域被整字跳过,只验证真正候选点 |
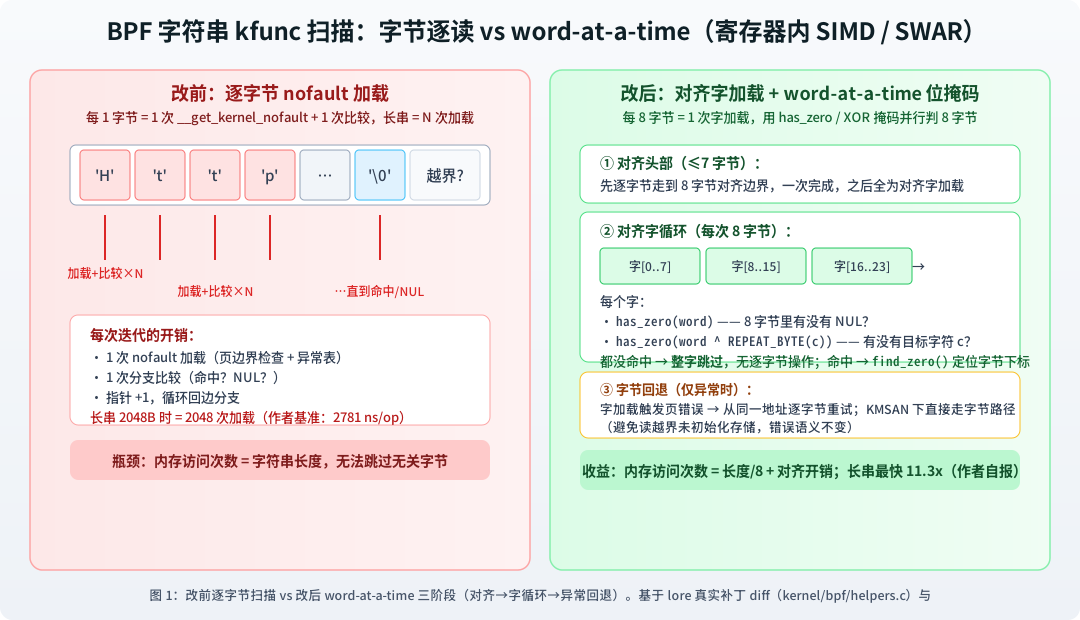
来源:基于 lore 真实补丁 diff(kernel/bpf/helpers.c)与
asm/word-at-a-time.h 语义绘制
精确语义(x86
arch/x86/include/asm/word-at-a-time.h):①
has_zero(word):((word - 0x0101…01) & ~word) & 0x8080…80——对每个字节,若该字节为 0,则从 0x01 的借位会让结果的最高位(0x80)置位,从而得到"哪些字节是 NUL"的位掩码;②
has_zero(word ^ REPEAT_BYTE(c)):先用 REPEAT_BYTE(c) 把 c 铺满整字,异或后"等于 c 的字节"变 0,再套用 ① 即得"哪些字节等于 c";③
find_zero(bits):__ffs(bits) >> 3 把首个置位 bit 换算成字节下标。一次字加载 + 3 条整数运算,就完成了原本 8 次逐字节加载 + 8 次分支比较的工作。
__get_kernel_nofault 的字加载要求地址按 sizeof(unsigned long) 对齐,所以先逐字节走到对齐边界(最多 7 字节),一次完成;对齐字循环:主体——每次整字加载 + 位掩码判定,无命中则整字跳过;
字节回退:字加载一旦跨页且下一页未映射会触发异常(
__get_kernel_nofault 通过异常表返回错误),此时从同一地址回退到逐字节,保证语义与安全不变;KMSAN 下也直接走字节路径,避免读到终止符之后的未初始化内存。
🔬 关键代码
diff 逐字取自 lore patch 字段(scan 1/6 为 +141/-39,本段摘取最能体现机制的核心片段;其余三补丁摘代表性片段)。
核心逻辑点 1:三阶段扫描宏(scan 1/6)——对齐一次、整字跳过、异常回退
+/* Abstract the common unaligned-byte, aligned-word, and byte-fallback scan. */
+#define bpf_str_for_each_word(s, limit, pos, word, byte, byte_label,	\
+			      byte_action, word_action, err_label)	\
+do {								\
+	__label__ byte_label;					\
+	size_t __word_end;					\
+								\
+	if (IS_ENABLED(CONFIG_KMSAN))				\
+		goto byte_label;				\
+								\
+	for (; (pos) < (limit) &&				\
+	       !IS_ALIGNED((unsigned long)((s) + (pos)), sizeof(word));	\
+	     (pos)++) {						\
+		__get_kernel_nofault(&(byte), (s) + (pos),	\
+				     unsigned char, err_label);	\
+		byte_action;					\
+	}							\
+								\
+	__word_end = (pos) + round_down((limit) - (pos), sizeof(word));	\
+	for (; (pos) < __word_end; (pos) += sizeof(word)) {	\
+		__get_kernel_nofault(&(word), (s) + (pos),	\
+				     unsigned long, byte_label);	\
+		word_action;					\
+	}							\
+								\
+byte_label:							\
+	for (; (pos) < (limit); (pos)++) {			\
+		__get_kernel_nofault(&(byte), (s) + (pos),	\
+				     unsigned char, err_label);	\
+		byte_action;					\
+	}							\
+} while (0)
▲ 核心是"一段宏 + 在调用点展开动作":byte_action/word_action 由各 kfunc 现场展开,避免为每个算法单独写对齐/边界/回退三遍。注意字加载的出错目标是 byte_label(回退到逐字节),而逐字节加载出错才是 err_label(返回 -EFAULT)——保证"字加载异常不丢结果、只降级"。
核心逻辑点 2:共享查找器 bpf_str_find(scan 1/6)——一次字加载判 8 字节
+	zero_at = has_zero(word, &zero_data, &constants);
+	char_at = has_zero(word ^ repeated_c, &char_data, &constants);
+	alt_at = has_alt ? has_zero(word ^ repeated_alt, &alt_data, &constants) : 0;
+	if (!zero_at && !char_at && !alt_at)
+		continue;
+
+	if (zero_at) {
+		zero_data = prep_zero_mask(word, zero_data, &constants);
+		zero_at = find_zero(create_zero_mask(zero_data));
+	} else {
+		zero_at = sizeof(word);
+	}
+	if (char_at) {
+		char_data = prep_zero_mask(word ^ repeated_c, char_data, &constants);
+		char_at = find_zero(create_zero_mask(char_data));
+	} else {
+		char_at = sizeof(word);
+	}
+	if (alt_at) {
+		alt_data = prep_zero_mask(word ^ repeated_alt, alt_data, &constants);
+		alt_at = find_zero(create_zero_mask(alt_data));
+		char_at = min(char_at, alt_at);
+	}
+
+	if (char_at <= zero_at)
+		return pos + char_at;
+	return nul_is_match ? pos + zero_at : -ENOENT;
▲ 这是"一次字加载顶 8 次比较"的心脏:has_zero(word) 查 NUL,has_zero(word ^ REPEAT_BYTE(c)) 查目标字符 c(alt_c 让大小写不敏感子串查找能同时匹配大小写变体)。若整字既无 NUL 也无目标字符,continue 整字跳过;有命中再用 find_zero 定位到字节。关键:char_at <= zero_at 决定返回目标字符位置还是 NUL 位置——保持与原实现一致的"NUL 也算字符串一部分"语义。
核心逻辑点 3:compare 2/6——同相对对齐才走字比较
+	if (!IS_ALIGNED((unsigned long)s1 ^ (unsigned long)s2, sizeof(word1))) {
+		for (; pos < limit; pos++) {
+			__get_kernel_nofault(&byte1, s1 + pos, unsigned char, err_out);
+			__get_kernel_nofault(&byte2, s2 + pos, unsigned char, err_out);
+			if (bpf_str_cmp_byte(byte1, byte2, ignore_case, &ret))
+				return ret;
+		}
+		return pos == XATTR_SIZE_MAX ? -E2BIG : 0;
+	}
+
+	bpf_str_for_each_word(s1, limit, pos, word1, byte1, byte_at_a_time, ({
+		__get_kernel_nofault(&byte2, s2 + pos, unsigned char, err_out);
+		if (bpf_str_cmp_byte(byte1, byte2, ignore_case, &ret))
+			return ret;
+	}), ({
+		__get_kernel_nofault(&word2, s2 + pos, unsigned long, byte_at_a_time);
+		if (word1 == word2) {
+			if (has_zero(word1, &data, &constants))
+				return 0;
+			continue;
+		}
▲ 关键一行:IS_ALIGNED(s1 ^ s2, sizeof(word1)) 判断两个串的相对对齐是否一致——一致时才能用同一个偏移做对齐字加载;否则回退逐字节(避免引入未对齐字加载的架构依赖)。字相等且无 NUL 时 continue 整字跳过;大小写折叠只在真正失配字节处做 tolower,避免每字节都折叠。
核心逻辑点 4:span 3/6——256-bit 位图缓存字符集 + 单字符拒绝快速路径
+static __always_inline int
+bpf_str_set_lookup(const char *set, unsigned long *set_bits, size_t *set_pos, bool *set_complete,
+		   unsigned char *set_first, unsigned char c)
+{
+	unsigned char set_c;
+
+	if (bpf_str_set_contains(set_bits, c))
+		return 1;
+	if (*set_complete)
+		return 0;
+
+	while (*set_pos < XATTR_SIZE_MAX) {
+		__get_kernel_nofault(&set_c, set + *set_pos, unsigned char, err_out);
+		if (set_c == '\0') {
+			*set_complete = true;
+			return 0;
+		}
+		if (*set_pos == 0)
+			*set_first = set_c;
+		set_bits[set_c / BITS_PER_LONG] |= BIT(set_c % BITS_PER_LONG);
+		(*set_pos)++;
+		if (set_c == c)
+			return 1;
+	}
+	return -E2BIG;
▲ 原 bpf_strcspn 对源串每个字节都要把 reject 串从头扫到尾(最坏 O(N×M));这里用 set_bits[256/64] 位图做成员缓存——每个 accept/reject 字符只 nofault 加载一次,之后 O(1) 查位。另加"单字符 reject 集"快速路径:发现 reject 串只有一个字符就转调 bpf_str_find() 整字扫描(常见分隔符场景)。
核心逻辑点 5:substring 4/6——先用查找器跳过不可能区域,再在候选点验证
+	while (pos < XATTR_SIZE_MAX && pos < len) {
+		limit = min_t(size_t, len - pos, XATTR_SIZE_MAX - pos);
+		offset = bpf_str_find(s1 + pos, limit, first, ignore_case, true);
+		if (offset < 0) {
+			if (offset == -ENOENT && limit == XATTR_SIZE_MAX - pos)
+				return -E2BIG;
+			return offset;
+		}
+		pos += offset;
+
+		/* bpf_str_find() also returns the position of a terminating
+		 * NUL. Distinguish it from a first-character match. */
+		__get_kernel_nofault(&candidate, s1 + pos, unsigned char, err_out);
+		if (candidate == '\0')
+			return -ENOENT;
+
+		limit = min_t(size_t, len - pos, XATTR_SIZE_MAX);
+		ret = bpf_str_match_at(s1 + pos, s2, limit, ignore_case);
+		if (ret > 0)
+			return pos;
+		if (ret < 0)
+			return ret;
+		pos++;
+	}
▲ 原 bpf_strnstr 是双重循环(对每个 haystack 偏移试全 needle,最坏 O(N×M))。新逻辑先用 bpf_str_find() 快速定位 needle 首字节的下一个出现位置——中间所有不可能开头的 haystack 区域都被整字跳过;找到候选点后才用 bpf_str_match_at() 做整字匹配验证。注:bpf_str_find() 会把 NUL 也当"命中",所以候选点要再读一字节区分"首字符命中"与"NUL",这是原实现语义的保留。
📈 性能影响
数据全部来自 cover letter 作者自报(未独立验证)。两个基准:① Gray 的 bpf_swar_benchmark(HTTP Host 搜索,验证 bpf_strnstr);② 作者为 4 类 kfunc 新增的 selftests 基准 bench_bpf_str_kfuncs。
| kfunc | 场景 | 长度 | 改前 ns/op | 改后 ns/op | 加速 |
|---|---|---|---|---|---|
| scan (bpf_strnchr) | first | 64B | 174.0 | 179.0 | 0.97x(略回退) |
| middle | 512B | 489.0 | 241.0 | 2.03x | |
| late | 1536B | 1706.0 | 506.0 | 3.37x | |
| absent | 2048B | 2781.0 | 727.0 | 3.83x | |
| comparison (bpf_strcmp) | first | 64B | 186.0 | 189.0 | 0.98x(略回退) |
| middle | 512B | 614.0 | 238.0 | 2.58x | |
| late | 1536B | 2234.0 | 458.0 | 4.88x | |
| equal | 2048B | 3663.0 | 634.0 | 5.78x | |
| span (bpf_strcspn) | first | 64B | 179.0 | 195.0 | 0.92x(回退) |
| middle | 512B | 1047.0 | 266.0 | 3.94x | |
| late | 1536B | 4489.0 | 482.0 | 9.31x | |
| absent | 2048B | 7468.0 | 661.0 | 11.30x | |
| substring (bpf_strnstr) | first | 64B | 277.0 | 218.0 | 1.27x |
| middle | 512B | 1115.0 | 296.0 | 3.77x | |
| late | 1536B | 4427.0 | 613.0 | 7.22x | |
| absent | 2048B | 7261.0 | 854.0 | 8.50x |
| 场景 | 长度 | 改前 kfunc | 改后 kfunc | kfunc 加速 |
|---|---|---|---|---|
| first | 64B | 345.0 | 261.0 | 1.87x |
| middle | 512B | 1193.0 | 352.0 | 8.03x |
| late | 1536B | 4469.0 | 708.0 | 17.13x |
| absent | 2048B | 7389.0 | 982.0 | 20.84x |
🔄 方案演进 + 讨论焦点
WARNING: Macros with flow control statements should be avoided(指两个带 return/goto 的宏),作者称"将在下一版处理",但下一版未出现。
- 评审核心质疑(Andrii Nakryiko)(Message-ID,2026-07-30):针对 1/6 scan 的
bpf_str_find()代码,Andrii 直言:"I'd say it's just not worth it. Too much code and complexity, IMO. For the absolute majority of BPF programs this small speed up won't matter, while for those BPF programs where doing tons of bpf_strstr-like operations is the essence of those programs and has a huge impact on the performance, they can basically implement and maintain this complexity in their own code base."——即:代码量与复杂度不划算;绝大多数 BPF 程序用不上这点提速;真正把字符串操作当核心的少数程序,可以把这套复杂度留在自己代码里。 - 作者回应(Leon Hwang)(Message-ID,2026-07-31):"Agreed on the complexity concern. Let's leave the str kfuncs as-is."——完全同意复杂度顾虑,决定不推进,系列就此终止。
- 无其他维护者参与:对 compare/span/substring/selftests 各补丁均无公开回复;只有 scan 补丁收到 Andrii 一条评审。
⚠️ 风险与局限
架构依赖:
asm/word-at-a-time.h 是架构相关实现,x86 用乘减位掩码,其他架构(如某些 32 位/有特殊字节序的架构)行为可能不同;IS_ALIGNED(s1 ^ s2) 的相对对齐判断也隐含字大小一致假设(解读(AI 分析))。宏复杂度:带
goto/return 的展开宏(checkpatch 已警告)使控制流隐藏在调用点,后续维护容易出错;这也是评审反对的主因之一。KMSAN 交互:强制走字节路径避免读越界未初始化内存,但会失去优化收益;KMSAN 使能时行为正确但性能回归是预期内的。
错误语义保持:作者声称保留 EFAULT/E2BIG/ERANGE 顺序,但该声明在 RFC 阶段未附独立测试证明(作者补了 exercise/failure 测试,评审未质疑,也未合入验证)。
性能类别定位:纯 on-CPU 热路径优化,无锁/并发改动,多核扩展性不受影响。
🔗 交叉引用
- Gray 的 bpf_swar_benchmark — 问题来源:纯 BPF SWAR 字符串实现,性能反超内核 kfunc,触发本系列。
- selftests/bpf: Benchmark string kfuncs(6/6) — 本系列新增的 4 类 kfunc 基准(数据见性能影响章节)。
- selftests/bpf: Exercise word-at-a-time string kfuncs(5/6) — 功能/边界用例(success + failure1)。
- 内核
lib/string.c/arch/x86/include/asm/word-at-a-time.h—has_zero/find_zero等位掩码原语本就服务于 VFS 路径名/strlen 等内核热路径,本系列是把同一技巧引入 BPF kfunc。
✅ 关键洞察
- 发现:BPF 字符串 kfunc 长期是"能工作但次优"的逐字节实现,在字符串密集负载(HTTP 头解析、子串搜索)上是真实可测的热路径;作者用内核已有的 word-at-a-time 位掩码技巧,把扫描从 O(N) 次加载降到 O(N/8),长串提速 2.03x–11.30x(作者自报)。
- 证据:最强数据是 HTTP Host 搜索 absent 场景 kfunc 从 7389→982 ns/op(20.84x)、以及 4-kfunc 基准中 span absent 场景 11.30x——但全部为作者自报、未独立验证,且系列已撤回。
- 边界:收益只出现在"目标靠后/缺失的长串";64B 短串反而略回退;架构依赖
asm/word-at-a-time.h,KMSAN 下自动降级。 - 风险 / 建议:评审(Andrii)判"复杂度不值",作者接受并撤回。对本日报的价值不只是性能数字,更是维护哲学案例:性能优化要过"复杂度/收益比"这道关——纯性能、大规模但复杂的内核改动,即使基准漂亮也可能因维护成本被拒。若后续想推进,建议走"只优化最高频的
bpf_strnstr+ 简化宏"的缩小版,或把 SWAR 复杂度留在 BPF 库/用户程序侧(解读(AI 分析))。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。