cpuidle:缓存 governor 延迟 QoS 约束,让 do_idle() 的选核路径快约 6 倍
💡 一句话总结
在多核服务器/云主机的 menu cpuidle governor 路径上,CPU 每次进入空闲都要重新聚合"允许睡多深"的延迟 QoS 约束(查设备结构 + 扫 QoS 优先级链表),补丁用"QoS 变化时通过 notifier 递增代数、选核时命中缓存"的方式,把聚合改为只在约束真正变化时计算一次。作者自报(ftrace,未独立验证)cpuidle_governor_latency_req() 在 menu_select() 中的耗时占比从约 19.9% 降到约 4.2%,每调用从约 1.9 µs 降到约 0.3 µs,约 6 倍;当前为 v2(2026-07-29)仍在评审。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(idle 进入路径的热路径减负) |
| 性能类别 | 热路径(idle-state 选择路径减指令/减函数调用) |
| 状态 | In Review(截至 2026-08-04 lore 归档未合入,本地内核 git 亦无对应提交) |
| 当前版本 | v2 · lore v2 cover letter |
| 版本演进 |
v1(2026-07-21,5 补丁)→ v2(2026-07-29,6 补丁) (v2 新增补丁 6/6 idle-state disable selftest,并重构补丁 4 的缓存逻辑) |
| 作者机构 | Yaxiong Tian(麒麟软件 KylinSoft) |
| 提交日期 | 2026-07-21(v1)/ 2026-07-29(v2) |
| 改动范围 | v1:10 文件 +566/-8;v2:12 文件 +885/-5。核心改动集中在 kernel/power/qos.c、include/linux/pm_qos.h、drivers/cpuidle/governor.c、drivers/cpuidle/cpuidle.c,其余为 selftests |
| 核心函数 | cpuidle_governor_latency_req() / cpuidle_aggregate_latency_req()(v2 新增)/ cpu_latency_qos_add_notifier() / cpuidle_latency_req_notifier_register() / dev_pm_qos_add_notifier() |
| 原始链接 | lore v1 Message-ID |
📊 速览卡片
注:"约 6×"为补丁作者在 cover letter 中基于 ftrace function_graph 自报(menu governor 下该函数占比 19.9%→4.2%、~1.9µs→~0.3µs/次),未独立验证。
🎯 解决什么问题
menu governor(服务器上最常见的选态策略)每次都调用 cpuidle_governor_latency_req() 计算"这次最多允许睡多深"——它把每个 CPU 自己的恢复延迟约束、系统全局 CPU 延迟 QoS、系统全局唤醒延迟 QoS 三者取最小值。为什么这是热点:这个聚合值在 QoS 约束不变时是恒定的,却每次 CPU 进入空闲都重新计算。而计算本身不便宜——cover letter 用 ftrace function_graph 逐函数记账:在
menu_select() 下,cpuidle_governor_latency_req() 约占 19.9% 的时间、约 1.9 µs/次,其中 get_cpu_device()(设备查找)、pm_qos_read_value()(遍历 QoS 优先级链表)各占约 2.5% 和 2.1%。作者动机:cover letter 开宗明义——"cpuidle: speed up do_idle() by caching the governor latency QoS constraint"。在 CPU 频繁 idle/唤醒的系统上,do_idle() 是仅次于实际睡眠本身的执行路径,选核开销被反复支付。
menu_select() 每次选 idle 状态都要知道延迟上限(latency_req),否则可能选一个过深的 idle 状态,导致延迟敏感应用唤醒超时。内核的 PM QoS 框架(kernel/power/qos.c)用"请求-约束"模型:应用(如 intel_idle、音频/网络子系统、/dev/cpu_dma_latency)注册 QoS 请求,框架维护一个按值排序的优先级链表(plist),约束值 = 链表中最严请求。问题链条:
cpu_latency_qos_limit() / cpu_wakeup_latency_qos_limit() 每次调用都要在 plist 上求当前聚合值;dev_pm_qos_raw_resume_latency() 要查每个 CPU 设备的 QoS 约束。这些查询叠加在一个每次 idle 进入都会执行的函数里。QoS 约束的实际变化频率极低(应用设置/取消约束时才变),而选核频率极高——把"低频变化的聚合"做成"高频重复计算",是典型的成本错配。为什么这么改:既然聚合值在约束不变时恒定,就用"缓存 + 失效"把计算从高频路径挪到低频事件上——约束变了才重算一次,其余命中缓存。这是"以空间换时间、以失效换新鲜"的经典思路。
do_idle() → cpuidle_idle_call() → cpuidle_select() → menu_select() → cpuidle_governor_latency_req()。cover letter 的 ftrace 显示 do_idle() 的 96.99% 时间在 cpuidle_idle_call(),其中实际睡眠占大头,但选核路径 cpuidle_select() 仍占 0.14%,而 cpuidle_governor_latency_req() 又占了 menu_select() 的 19.9%。高频触发场景:① 云计算/虚拟化宿主——大量 vCPU 轮流空闲,idle 进出每秒成千上万次;② 网络包处理——NAPI 收包后在两个软中断/中断之间 CPU 短暂空闲;③ 音频/实时——缓冲区写满后 CPU 让出,很快又被唤醒;④ 移动/嵌入式设备——绝大多数时间处于空闲。
为什么此场景遇到系统缺陷:这些负载的 idle 进出频率高,每次进出都要付一次"聚合 QoS"的固定成本(~1.9µs/次),而 QoS 约束本身并没有每次都变。省掉这次重复计算,等于把 CPU 花在"决定睡多深"上的时间省下来——CPU 能更快真正睡下去(省电),也能更快回到运行态处理下一次唤醒。
🧩 核心机制
整套机制分四步:① 给全局 CPU/唤醒延迟 QoS 补上 notifier 基础设施;② cpuidle 订阅这些 notifier,任何全局 QoS 变化就把所有 CPU的"代数"加 1;③ 每个 CPU 订阅自己的 DEV_PM_QOS_RESUME_LATENCY notifier,恢复延迟变化只失效本 CPU;④ cpuidle_governor_latency_req() 改造成"缓存命中返回,未命中才重算"。
get_cpu_device + 两个 QoS 查询),哪怕规则根本没人改过。补丁的做法是:把算好的"最长等待时间"写在小黑板上(per-CPU 缓存),只在规则真被修改时由管理员(notifier)来擦一次黑板(代数 +1)。乘客再来,窗口只看黑板、不看规则表。
kernel/power/qos.c + include/linux/pm_qos.h(补丁 1/5)——给 cpu_latency_constraints 和 cpu_wakeup_latency_constraints 两个约束结构补上 .notifiers 指向新建的 BLOCKING_NOTIFIER_HEAD,并导出注册/注销 API。为什么补在这:PM QoS 框架的 pm_qos_update_target() 本来就在约束有效值变化时调用 blocking_notifier_call_chain(c->notifiers, ...),只是 CPU/唤醒延迟这两个约束的 .notifiers 字段此前是空的。drivers/cpuidle/governor.c(补丁 2/5、3/5)——新增
latency_req_gen(per-CPU 代数计数器)与 per-CPU 缓存结构;core_initcall 注册两个全局 QoS notifier(回调里对每个 possible CPU atomic_inc),并在每个 CPU 的 cpuidle 设备注册/注销时挂载/卸载 DEV_PM_QOS_RESUME_LATENCY notifier(只失效该 CPU)。drivers/cpuidle/governor.c 的
cpuidle_governor_latency_req()(补丁 4/5)——改造成带缓存:读 cache->gen 与 atomic_read(latency_req_gen) 比较,相等直接返回缓存值;不等才走原聚合逻辑并回填缓存。v2 进一步拆出 cpuidle_aggregate_latency_req()(真正的聚合计算,static)和带缓存的 cpuidle_governor_latency_req()。为什么用 notifier 而非轮询:轮询 = 每次选核都去检查 QoS 是否变化,那正是要避免的开销。notifier 把"检测变化"从高频路径挪到低频事件上——QoS 变化是稀有事件,用现成的
pm_qos_update_target() 通知链即可,cpuidle 无需新增任何定时/扫描逻辑。缓存一致性由"代数"保证:失效动作是原子自增,选核路径是原子读 + 比较,无需锁。为什么支撑场景提升:选核高频路径从"4 次底层查询"降为"1 次缓存命中比较"——正是 cover letter 里 ftrace 显示的该函数成本下降约 6 倍、在
menu_select() 中占比从 19.9% 降到 4.2% 的来源。
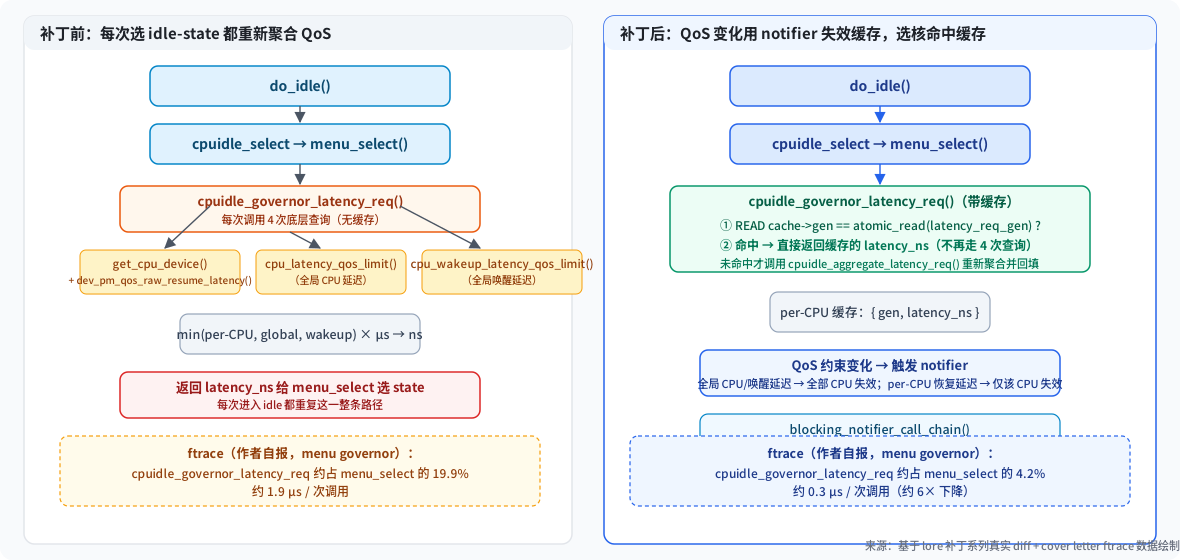
来源:基于 lore 补丁系列真实 diff + cover letter ftrace 数据绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1. 补基础设施 | pm_qos.c 给两个约束加 BLOCKING_NOTIFIER_HEAD 并导出 cpu_latency_qos_add_notifier() 等 | 复用 pm_qos_update_target() 已有的"有效值变化时调用 notifier 链"机制 |
| 2. 订阅全局 | core_initcall 注册全局 CPU/唤醒延迟 notifier → 回调对所有 possible CPU 的 latency_req_gen 原子 +1 | 全局 QoS 变化影响所有 CPU,全部失效 |
| 3. 订阅本 CPU | cpuidle 设备注册时 dev_pm_qos_add_notifier(dev, &nb, DEV_PM_QOS_RESUME_LATENCY) → 只对该 CPU 的代数 +1 | per-CPU 恢复延迟变化只失效对应 CPU,避免无谓的全量失效 |
| 4. 缓存读 | cache->gen == atomic_read(latency_req_gen) 命中 → 返回 cache->latency_ns;未命中 → 重算并回填 | 高频选核路径只剩一次比较 + 一次返回 |
🔬 关键代码
逻辑点 1:给全局 QoS 约束挂上 notifier(补丁 1/5,kernel/power/qos.c)
 #ifdef CONFIG_CPU_IDLE
 /* Definitions related to the CPU latency QoS. */

+static BLOCKING_NOTIFIER_HEAD(cpu_latency_qos_notifiers);
+
 static struct pm_qos_constraints cpu_latency_constraints = {
 	.list = PLIST_HEAD_INIT(cpu_latency_constraints.list),
 	.target_value = PM_QOS_CPU_LATENCY_DEFAULT_VALUE,
 	.default_value = PM_QOS_CPU_LATENCY_DEFAULT_VALUE,
 	.no_constraint_value = PM_QOS_CPU_LATENCY_DEFAULT_VALUE,
 	.type = PM_QOS_MIN,
+	.notifiers = &cpu_latency_qos_notifiers,
 };

 static inline bool cpu_latency_qos_value_invalid(s32 value)
▲ cpu_latency_constraints 之前从未初始化 .notifiers 字段;补上之后,pm_qos_update_target() 里那行"有效值变化时 blocking_notifier_call_chain()"才对 CPU 延迟 QoS 生效。这是整套机制的地基——没有它,cpuidle 无法被 QoS 变化唤醒。
+int cpu_latency_qos_add_notifier(struct notifier_block *notifier)
+{
+	return blocking_notifier_chain_register(&cpu_latency_qos_notifiers,
+						notifier);
+}
+EXPORT_SYMBOL_GPL(cpu_latency_qos_add_notifier);
▲ 导出的注册 API;对 wakeup latency QoS 做了同样的一套(cpu_wakeup_latency_qos_notifiers)。两个全局约束分别有独立通知链,cpuidle 两个都订阅。
逻辑点 2:订阅全局 QoS、维护 per-CPU 代数(补丁 2/5,drivers/cpuidle/governor.c)
+static DEFINE_PER_CPU(atomic_t, latency_req_gen);
+
+static void cpuidle_latency_req_invalidate_cpu(unsigned int cpu)
+{
+	atomic_inc(per_cpu_ptr(&latency_req_gen, cpu));
+}
+
+static void cpuidle_latency_req_invalidate_all(void)
+{
+	unsigned int cpu;
+
+	for_each_possible_cpu(cpu)
+		cpuidle_latency_req_invalidate_cpu(cpu);
+}
+
+static int cpuidle_global_qos_notify(struct notifier_block *nb,
+				     unsigned long action, void *data)
+{
+	cpuidle_latency_req_invalidate_all();
+	return NOTIFY_OK;
+}
+
+static struct notifier_block cpuidle_latency_qos_nb = {
+	.notifier_call = cpuidle_global_qos_notify,
+};
▲ 核心设计:代数(generation)是一个 per-CPU 原子计数器。全局 QoS 一旦变化,把每个 CPU 的代数都 +1——"全部失效"。失效动作本身极轻(原子自增),不在任何锁里做,也就不会阻塞 QoS 更新路径。
逻辑点 3:per-CPU 恢复延迟变化只失效本 CPU(补丁 3/5,drivers/cpuidle/governor.c + cpuidle.c)
+int cpuidle_latency_req_notifier_register(unsigned int cpu)
+{
+	struct device *device = get_cpu_device(cpu);
+	struct cpuidle_cpu_qos_nb *qos_nb =
+		per_cpu_ptr(&cpuidle_cpu_qos_nb, cpu);
+
+	if (!device)
+		return -ENODEV;
+
+	qos_nb->cpu = cpu;
+	qos_nb->nb.notifier_call = cpuidle_cpu_qos_notify;
+	return dev_pm_qos_add_notifier(device, &qos_nb->nb,
+				       DEV_PM_QOS_RESUME_LATENCY);
+}
▲ 每个 CPU 在 __cpuidle_register_device() 时注册自己的恢复延迟 notifier,回调只 atomic_inc 本 CPU 的代数。这样某 CPU 的 per-CPU 恢复延迟约束变化(例如该核被实时任务绑核限制),不会让所有 CPU 都失效——失效粒度精准到受影响的那一个。
逻辑点 4:缓存读 + 未命中重算(补丁 4/5,drivers/cpuidle/governor.c,v1)
 s64 cpuidle_governor_latency_req(unsigned int cpu)
 {
-	struct device *device = get_cpu_device(cpu);
-	int device_req = dev_pm_qos_raw_resume_latency(device);
-	int global_req = cpu_latency_qos_limit();
-	int global_wake_req = cpu_wakeup_latency_qos_limit();
+	struct cpuidle_latency_req_cache *cache;
+	unsigned int gen;
+	struct device *device;
+	int device_req, global_req, global_wake_req;
+	s64 latency_ns;
+
+	cache = per_cpu_ptr(&latency_req_cache, cpu);
+	gen = atomic_read(per_cpu_ptr(&latency_req_gen, cpu));
+
+	if (likely(READ_ONCE(cache->gen) == gen))
+		return READ_ONCE(cache->latency_ns);
+
+	device = get_cpu_device(cpu);
+	device_req = dev_pm_qos_raw_resume_latency(device);
+	global_req = cpu_latency_qos_limit();
+	global_wake_req = cpu_wakeup_latency_qos_limit();

 	if (global_req > global_wake_req)
 		global_req = global_wake_req;
@@ -223,5 +241,14 @@ s64 cpuidle_governor_latency_req(unsigned int cpu)
 	if (device_req > global_req)
 		device_req = global_req;

-	return (s64)device_req * NSEC_PER_USEC;
+	latency_ns = (s64)device_req * NSEC_PER_USEC;
+
+	WRITE_ONCE(cache->latency_ns, latency_ns);
+	/*
+	 * Store gen last so a concurrent invalidate cannot leave a stale
+	 * latency_ns marked as current.
+	 */
+	WRITE_ONCE(cache->gen, gen);
+
+	return latency_ns;
 }
▲ 这段是性能收益的直接来源:热路径(likely)只剩 cache->gen == gen 比较 + 返回缓存值,4 次底层查询只在"代数变了"(即 QoS 真变了)才执行。关键点 1:likely() 标注告诉 CPU 分支预测器"命中是常态";关键点 2:回填时先写 latency_ns 再写 gen(v1 用 WRITE_ONCE 保证顺序)——否则并发失效(notifier 自增代数)可能把"旧值 + 新代数"错配,让过期数据被当成新的。
逻辑点 5(v2 演进):代数从 1 开始 + 拆分聚合函数(补丁 4/6,当前版)
-static DEFINE_PER_CPU(atomic_t, latency_req_gen);
+static DEFINE_PER_CPU(atomic_t, latency_req_gen) = ATOMIC_INIT(1);
+
+struct cpuidle_latency_req_cache {
+	unsigned int gen;
+	s64 latency_ns;
+};
 ...
-s64 cpuidle_governor_latency_req(unsigned int cpu)
+static s64 cpuidle_aggregate_latency_req(unsigned int cpu)
 {
 	struct device *device = get_cpu_device(cpu);
 	int device_req = dev_pm_qos_raw_resume_latency(device);
 	int global_req = cpu_latency_qos_limit();
 	int global_wake_req = cpu_wakeup_latency_qos_limit();
 ...
-	return (s64)device_req * NSEC_PER_USEC;
 }
+
+s64 cpuidle_governor_latency_req(unsigned int cpu)
+{
+	struct cpuidle_latency_req_cache *cache;
+	unsigned int gen;
+	s64 latency_ns;
+
+	cache = per_cpu_ptr(&latency_req_cache, cpu);
+	gen = atomic_read(per_cpu_ptr(&latency_req_gen, cpu));
+
+	if (likely(cache->gen == gen))
+		return cache->latency_ns;
+
+	latency_ns = cpuidle_aggregate_latency_req(cpu);
+	cache->latency_ns = latency_ns;
+	cache->gen = gen;
+
+	return latency_ns;
+}
▲ v2 的三处修正(见 v2 cover letter Changelog):① 代数从 1 开始(ATOMIC_INIT(1))——否则 per-CPU 缓存是零初始化的(gen=0),若代数也从 0 开始,第一次进入会"假命中"并返回尚未填充的 0 值,把延迟约束误当成"零延迟"(最严约束),导致 governor 只敢选最浅的 idle 状态;② 去掉 WRITE_ONCE/READ_ONCE——v2 明确缓存字段只有本 CPU 的 idle 路径访问,远端 CPU 只动原子代数,无数据竞争,普通读写即可,并补了使用限制注释;③ 把原函数改名 cpuidle_aggregate_latency_req()(static),新 cpuidle_governor_latency_req() 只做缓存外壳——语义更清晰,也便于 haltpoll/ladder/teo 等其它 governor 共享。
📈 性能影响
数据出处:以下全部为补丁作者在 v1/v2 cover letter 中基于 ftrace function_graph 的 profile 自报(menu governor,x86 测试机),作者自报、未独立验证。补丁未提供端到端应用级基准(无网络/音频/实时负载的 before/after 对比)。
| 指标 | 运行环境/度量 | 补丁前 | 补丁后 |
|---|---|---|---|
cpuidle_governor_latency_req() 在 menu_select() 中耗时占比 | menu governor · ftrace function_graph | 19.9%(约 31.99 ms / 16718 次) | 4.2%(约 2.32 ms / 7626 次) |
| 每次调用平均耗时 | 同一 profile | 约 1.9 µs | 约 0.3 µs(约 6× 降低) |
| 函数内部主要子开销(补丁前) | get_cpu_device() / pm_qos_read_value() / cpu_latency_qos_limit() / cpu_wakeup_latency_qos_limit() | 各占约 2.57% / 2.14% / 1.87% / 1.87% | 缓存命中,不再逐次执行 |
注:补丁前后 menu_select() 自身总耗时也从约 160 ms / 16718 次降至约 55 ms / 7626 次,但两次采样的调用次数不同(16718 vs 7626),作者未声明这是相同工作负载下的对照,故百分比与每次调用耗时的对比更具可比性,绝对耗时仅作参考。解读(AI 分析):约 6× 是该函数自身的成本下降,不代表整条 do_idle() 或端到端延迟下降 6×——后者取决于该函数在整条路径中的权重。
on-CPU vs off-CPU 视角:本补丁优化的是 on-CPU 计算环节——它减少的是 CPU 在 idle 进入路径(do_idle() → menu_select())上"决定睡多深"的指令/函数调用,而不是减少某个等待环节。它的间接收益有两面(解读(AI 分析)):① 更快真正入睡——选核变快,CPU 更早进入低功耗状态,省电更充分;② 更快的 QoS 响应——约束变化后,下一次选核立刻(代数不匹配)重算,无需等任何定时器。对网络/音频等延迟敏感负载,收益主要体现为 QoS 收紧时能更快切换到更浅的 idle 状态,避免唤醒超时;但作者未提供这类负载的延迟实测数据。
🔄 方案演进与讨论焦点
v2(2026-07-29,6 补丁):
① 补丁 4 修正代数零初始化导致的假命中(
ATOMIC_INIT(1));② 补丁 4 去掉不必要的
WRITE_ONCE/READ_ONCE并加使用限制注释(缓存仅本 CPU idle 路径访问);③ 补丁 4 把原
cpuidle_governor_latency_req() 改名 cpuidle_aggregate_latency_req(),新函数只做缓存外壳;④ 补丁 5 抽出公共逻辑、加"已有 QoS/disable 设置可能干扰测试"的告警、修复
ResumeLatencyGuard 值恢复;⑤ 新增补丁 6
idle-state disable selftest(作者自述补丁 5、6 可作为独立主题)。
in_reply_to 查询均为空)。系列发给 cpuidle/PM 维护者 Rafael Wysocki、Daniel Lezcano 与 ARM 的 Christian Loehle 等(To 列表),但讨论可能发生在邮件列表之外。v2 Changelog 反映的评审关注点(来源:v2 cover letter,作者自述的修改原因):
① 缓存假命中是正确性 bug:零初始化的
latency_req_gen 与零初始化的缓存 gen 相等,首轮会返回未填充的 0(最严约束),作者在 v2 用 ATOMIC_INIT(1) 修复——说明该路径曾被(自测或评审)发现会导致 governor 长期只选最浅 idle 状态,既伤性能又费电。② 并发原语是否过度:v1 用
WRITE_ONCE/READ_ONCE,v2 去掉并补注释说明"缓存字段仅本 CPU idle 路径访问、远端仅动原子代数"——这是对并发模型的澄清。③ 函数职责拆分:聚合逻辑与缓存逻辑混在一个函数里,v2 拆成
cpuidle_aggregate_latency_req() + 缓存外壳,便于其它 governor 复用。解读(AI 分析)——潜在未决争议点:① 全局 QoS 变化时
for_each_possible_cpu() 逐 CPU 自增,在千核系统上是 O(n) 的广播失效,虽非常规路径但值得观察;② __cpuidle_register_device() 现在把 cpuidle_latency_req_notifier_register() 的失败(如 get_cpu_device() 返回 NULL 或 dev_pm_qos_add_notifier() 失败)当作 cpuidle 设备注册失败处理(goto unreg),这是行为变更,可能影响某些平台;③ 缓存一致性依赖"代数自增可见性",x86/arm64 上原子读-写顺序已足够,但未显式用 smp_rmb 等屏障,极端乱序 CPU 上(若未来出现)需复核。以上均为分析推演,非公开 review 内容。
⚠️ 风险与局限
- 代数回绕:
latency_req_gen是unsigned int,理论上 2³² 次失效后回绕。若回绕恰好让新代数与缓存里"旧值 + 旧代数"相等,会假命中返回过期约束。实际需要 42 亿次 QoS 变化才触发,风险极低(MINOR)。 - 全量失效的 O(n) 成本:全局 QoS 每次变化对每个 possible CPU 做原子自增。千核系统上这是一次 O(nr_cpus) 的扫描。QoS 变化是稀有事件,但若某驱动频繁修改全局 CPU 延迟约束,广播开销会显现(解读(AI 分析),MAJOR 边界)。
- cpuidle 设备注册行为变更:notifier 注册失败会回滚整个 cpuidle 设备注册(
goto unreg)。若某平台get_cpu_device()或dev_pm_qos_add_notifier()异常,CPU 将无法注册 cpuidle 设备——这是新引入的失败模式(解读(AI 分析),MAJOR 边界,需平台回归测试)。 - 缓存新鲜度窗口:notifier 自增代数与选核读代数之间没有互斥。极端时序下,选核可能读到"旧约束"并在本次选态使用,但下一次进入 idle 会因代数不匹配自动纠正——是自愈的瞬时陈旧,不会永久错误(v1 的 WRITE_ONCE 顺序注释即针对此;v2 论证本 CPU 独占缓存字段后移除)。
- selftest 稳定性:补丁 5/6 是新引入的 Python kselftest(
cpuidle_latency_req_qos.py),依赖真实 CPU idle-state 行为与 QoS 交互,在虚拟机/无 cpuidle 驱动环境可能不可跑或 flaky(解读(AI 分析),MINOR)。
🔗 交叉引用
cpu_latency_qos_limit(),本补丁系列优化的正是这条链路的聚合开销cpuidle: Respect the CPU system wakeup QoS limit for cpuidle — 引入
cpu_wakeup_latency_qos_limit(),本系列聚合的第二路全局约束cpuidle: Use nanoseconds as the unit of time — 选态时间基准改为 ns,本系列
cpuidle_governor_latency_req() 返回 ns 的单位基础Documentation/admin-guide/pm/cpuidle.rst — cpuidle 子系统与 governor 官方文档(menu/ladder/teo 选态逻辑)
补丁 4/5: cpuidle: cache aggregated governor latency QoS constraint — 本系列性能收益落点(缓存聚合)
✅ 关键洞察
- 发现:cpuidle 选核高频路径重复计算低频变化的 QoS 聚合值,造成约 1.9µs/次的固定开销;补丁用"per-CPU 缓存 + notifier 失效代数"把聚合挪到 QoS 真正变化时,选核热路径降为一次缓存命中判断。
- 证据:作者自报(ftrace,未独立验证)
cpuidle_governor_latency_req()在menu_select()中占比 19.9%→4.2%、每调用约 1.9µs→0.3µs(约 6×)。 - 边界:约 6× 是该函数自身的成本下降,不代表端到端延迟下降 6×;补丁未提供网络/音频/实时负载的端到端基准。对不频繁 idle、或 QoS 从不收紧的负载基本 no-op。收益随 idle 进出频率与 QoS 使用强度放大。
- 风险 / 建议:无公开 review 回复,v2 已修复"零初始化假命中"这一正确性缺陷;建议关注全局 QoS 变化时的 O(n) 广播失效与 cpuidle 设备注册失败的新失败模式,并推动维护者给出 x86/ARM 平台回归与端到端延迟数据。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。