KVM Dirty-bit cleaning hw accelerator (HACDBS):硬件加速脏页清理
💡 一句话总结
在 VM 热迁移 等需要反复「取脏页快照并重新开启写保护」的场景里,KVM/arm64 原有的软件清理路径要对每个脏页逐一修改 stage-2 页表并冲刷 TLB,脏页多时持有 mmu_lock 的循环体可达数万次;本系列引入 FEAT_HACDBS(硬件加速脏位清理)架构通用接口与 arm64 实现,把脏页列表打包成 HDBSS 条目数组一次性交给硬件走页表批量清除 writable-dirty 位,host 轮询完成寄存器即可。作者在 ARM 模型上用 dirty_log_perf_test 自报:KVM_GET_DIRTY_LOG 运行时 -87%、KVM_CLEAR_DIRTY_LOG -86%、KVM_RESET_DIRTY_RINGS -70%(即相关 ioctl 3.3x–8x 更快,作者自报,未独立验证),显著缩短迁移每轮脏页扫描/清理的时间。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 新特性 + 优化(引入硬件加速接口,主要目的为降低脏页清理开销) |
| 性能类别 | 热路径 / 虚拟化开销(dirty-log 清理 ioctl 路径) |
| 状态 | In Review(v3,作者声明「尚未就绪,不可合入」——依赖另一 HDBSS 系列) |
| 当前版本 | v3 · cover letter |
| 版本演进 | v1(04-30,12 补丁)→ v2(06-29,13 补丁,含 ACPI/HACDBSIRQ)→ v3(07-29,11 补丁,改轮询 + preempt_notifier) |
| 作者机构 | Leonardo Bras(ARM Ltd.,leo.bras@arm.com) |
| 提交日期 | 2026-07-29(v3) |
| 系列规模 | 11 补丁 · 17 文件 · +660/-22 行 |
| 核心函数 | kvm_arch_dirty_log_clear() / kvm_arch_dirty_ring_clear() / __kvm_arch_dirty_log_clear() / dirty_bit_clear() / hacdbs_start() |
| 原始链接 | lore Message-ID 20260729104548.3439958-6(patch 05/11 架构通用接口) |
📊 速览卡片
🎯 解决什么问题
kvm_get_dirty_log_protect() / kvm_clear_dirty_log_protect() 在「取快照 + 重新开启写保护」时,对 dirty bitmap 逐 unsigned long 执行 xchg() 取快照,并对每个置位页调用 kvm_arch_mmu_enable_log_dirty_pt_masked() 修改 stage-2 页表项(写保护或 DBM 位),结束后 kvm_flush_remote_tlbs_memslot() 冲刷 TLB。dirty-ring 路径 kvm_dirty_ring_reset() 则逐个 harvested 条目调 kvm_reset_dirty_gfn()。当 VM 内存大、脏页多(迁移中几乎全内存被写),这个「每脏页一次页表写」的循环就是迁移每轮的固定成本大头;且整个循环持 mmu_lock 写锁,vCPU 缺页等路径被阻塞。补丁 06/11 的 commit message 明确点出软件路径的另一重成本:manual-protect + init-set 时还需做 巨页分裂(kvm_mmu_split_huge_pages(),2MB/1GB → 4KB),逐块分裂同样耗时。
KVM_GET_DIRTY_LOG / KVM_CLEAR_DIRTY_LOG)→ 把脏页传输到目标机 → 再取下一轮脏页。内存越大、guest 写越活跃,每轮脏页越多,软件清理循环就越长;停止时间(downtime)取决于最后一轮能多快收敛,而每轮清理时间直接加在迁移总时长上。dirty-ring 变体(QEMU 用 KVM_RESET_DIRTY_RINGS 复位 ring)同样受益——迁移轮次密集调用这三个 ioctl,它们的单次耗时就是迁移的开销基线。HACDBS 把「逐页软件改 PTE」变成「一次数组提交 + 硬件批量走页表」,正好削在迁移每轮的重复开销上。
🧩 核心机制
设计取向(cover letter):不新增任何 KVM API,只在通用层加两个「未实现即返回 -ENXIO 回退软件路径」的架构钩子 kvm_arch_dirty_log_clear() / kvm_arch_dirty_ring_clear();arm64 在 asm/kvm_dirty_bit.h 提供真实现,把脏页转成 HDBSS 条目数组交给 FEAT_HACDBS 硬件。
- ① 架构通用钩子(patch 05/09):
include/linux/kvm_dirty_bit.h定义kvm_arch_dirty_log_clear()/kvm_arch_dirty_ring_clear()。无CONFIG_HAVE_KVM_HW_DIRTY_BIT时是static inline返回-ENXIO的桩;有则#include <asm/kvm_dirty_bit.h>。通用层在kvm_get_dirty_log_protect()、kvm_clear_dirty_log_protect()、kvm_dirty_ring_reset()的开头先调钩子,返回 ≥0 就跳过整段软件循环,返回负数(未实现-ENXIO/ 硬件出错-EAGAIN)则落回原有软件路径。补丁说明承诺「compiled-out and have zero impact at runtime」。 - ② 基础清理例程(patch 04):
arch/arm64/kvm/dirty_bit.c的dirty_bit_clear()是底层执行器——__load_stage2()载入 guest stage-2、置HCR_EL2.VM、hacdbs_start()把 HDBSS 数组物理地址写入HACDBSBR_EL2(含dsb(ishst)保证数组写入完成)、然后轮询HACDBSCONS_EL2的 INDEX/ERR_REASON(v3 起,见讨论)直到完成;返回成功清理的条目数,出错时返回错误索引供上层回退。 - ③ dirty-bitmap 清理例程(patch 06):
__kvm_arch_dirty_log_clear()遍历 bitmap/输入位图,把每个置位页经mask_to_hdbss()转成(IPA | TTWL | VALID)条目攒到一页数组,攒满即dirty_bit_clear()提交;manual-protect + init-set 时先kvm_mmu_split_huge_pages()分裂巨页。出错时把未处理条目写回 bitmap(hdbss_to_bitmap()/atomic_long_or),返回-EAGAIN触发软件回退。 - ④ dirty-ring 清理例程(patch 10):
__kvm_arch_dirty_ring_clear()从 ring 的reset_index起逐个 harvested 条目解析 slot/offset → 组成 HDBSS 数组 → 一次dirty_bit_clear();只把成功清理的条目置 invalid 并推进reset_index,出错时剩余条目留给软件路径。
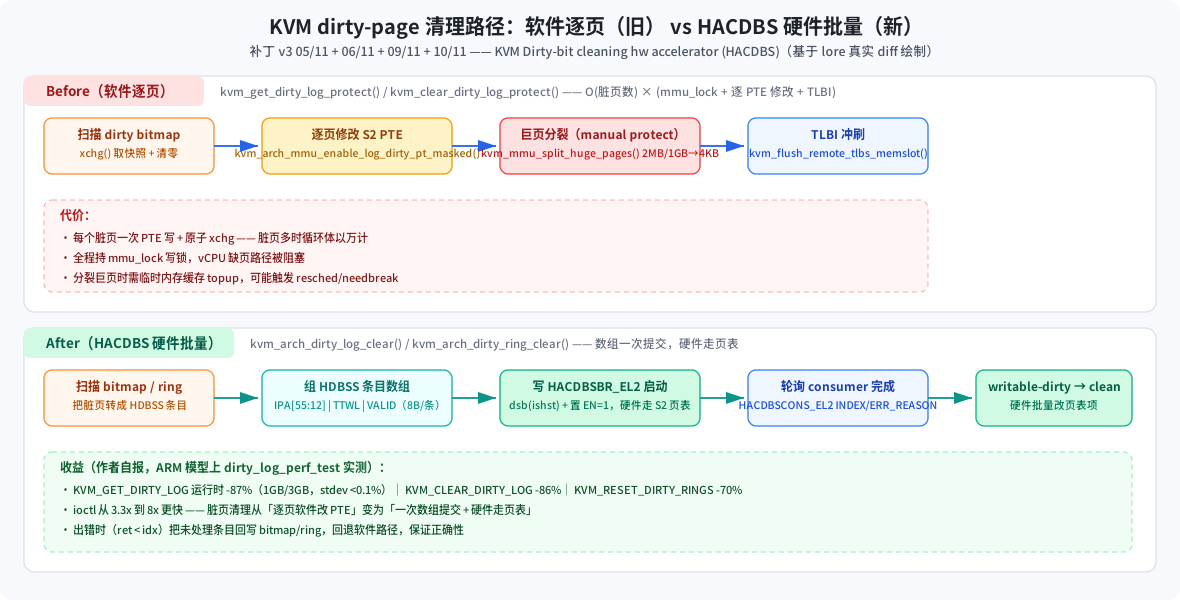
来源:基于 lore 真实补丁 diff(v3 05/11 + 06/11 + 09/11 + 10/11)与 cover letter 实测数据绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1. 取脏页集合 | kvm_arch_dirty_log_clear() / kvm_arch_dirty_ring_clear() 入口 | 通用层统一接入点;返回 ≥0 则跳过软件路径 |
| 2. 组 HDBSS 数组 | mask_to_hdbss():(gfn_to_gpa(offset+j) & HDBSS_ENTRY_IPA) | ttwl | VALID | 把每个脏页编码成 8 字节硬件条目(IPA + 页表层级 + 有效位) |
| 3. 提交给硬件 | hacdbs_start():写 HACDBSBR_EL2(BADDR|SZ|EN) | dsb(ishst) 后使能,硬件开始走 stage-2 页表清 writable-dirty 位 |
| 4. 等待完成 | 轮询 HACDBSCONS_EL2 的 INDEX / ERR_REASON(udelay(1)) | v3 起用轮询替代 IRQ(Oliver Upton 评审推动),避免 IRQ 先于 wfi 到达的竞态 |
| 5. 收尾/回退 | 成功条目置 invalid / 推进 reset_index;失败回写 bitmap 返回 -EAGAIN | 保证失败时剩余脏页仍由软件清理,正确性不丢 |
🔬 关键代码
以下 diff 逐字取自 v3 补丁(04/11、05/11、06/11、09/11、10/11)。
① 架构通用钩子:未实现即编译为空(patch 05/11)
+#ifndef CONFIG_HAVE_KVM_HW_DIRTY_BIT
+static inline int kvm_arch_dirty_log_clear(struct kvm *kvm,
+				   struct kvm_memory_slot *memslot,
+				   struct kvm_clear_dirty_log *log,
+				   unsigned long *bitmap,
+				   bool *flush)
+{
+	return -ENXIO;
+}
+#else /* CONFIG_HAVE_KVM_HW_DIRTY_BIT */
+#include <asm/kvm_dirty_bit.h>
+#endif /* CONFIG_HAVE_KVM_HW_DIRTY_BIT */
▲ 关键设计:没有该 Kconfig 的架构拿到的是返回 -ENXIO 的内联桩,调用点「钩子失败→走原软件循环」,行为与旧代码完全一致;有该 Kconfig 的架构(arm64)才展开成真实现。
② 通用层接线:命中硬件路径就整段跳过软件循环(patch 05/11)
 	} else {
 		dirty_bitmap_buffer = kvm_second_dirty_bitmap(memslot);
 		memset(dirty_bitmap_buffer, 0, n);

+		if (kvm_arch_dirty_log_clear(kvm, memslot, NULL,
+					     dirty_bitmap_buffer, &flush) >= 0)
+			goto out;
+
 		KVM_MMU_LOCK(kvm);
 		for (i = 0; i < n / sizeof(long); i++) {
 			unsigned long mask;
 			gfn_t offset;

 			if (!dirty_bitmap[i])
 				continue;

 			flush = true;
 			mask = xchg(&dirty_bitmap[i], 0);
 			dirty_bitmap_buffer[i] = mask;

 			offset = i * BITS_PER_LONG;
 			kvm_arch_mmu_enable_log_dirty_pt_masked(kvm, memslot,
 								offset, mask);
 		}
 		KVM_MMU_UNLOCK(kvm);
 	}

+out:
 	if (flush)
 		kvm_flush_remote_tlbs_memslot(kvm, memslot);
▲ goto out 使硬件成功时跳过整个 KVM_MMU_LOCK 逐页循环(这是收益核心——整段持锁软件路径不再执行),但仍走统一的 flush→TLBI 收尾;硬件出错返回负值则原样落到软件循环,保证正确性。
③ arm64 使能门控 + bitmap→HDBSS 转换(patch 06/11)
+static inline bool kvm_arch_dirty_clear_enabled(struct kvm *kvm)
+{
+	return system_supports_hacdbs() &&  kvm->arch.mmu.pgt &&
+	       (kvm->arch.mmu.pgt->flags & KVM_PGTABLE_S2_DBM);
+}
+
+static inline int kvm_arch_dirty_log_clear(struct kvm *kvm, ...)
+{
+	if (!kvm_arch_dirty_clear_enabled(kvm))
+		return -EPERM;
+	return __kvm_arch_dirty_log_clear(kvm, memslot, log, bitmap, flush);
+}
▲ 门控三条件:系统支持 FEAT_HACDBS、有 stage-2 页表、页表开了 DBM(Dirty Bit Modifier,HDBSS 硬件脏位机制的前提)。任一不满足即 -EPERM 回退软件。
+static inline int mask_to_hdbss(unsigned long *mask, u64 *hw_entries, const gfn_t offset,
+				u64 ttwl, int idx, int entries_sz)
+{
+	while (idx < entries_sz) {
+		int j = __ffs(*mask);
+		u64 a = gfn_to_gpa(offset + j);
+
+		hw_entries[idx++] = (a & HDBSS_ENTRY_IPA) |
+				    ttwl |
+				    HDBSS_ENTRY_VALID;
+
+		*mask &= ~BIT(j);
+		if (!*mask)
+			break;
+	}
+	return idx;
+}
▲ __ffs() 逐个取出位图最低置位,转成 gpa & IPA_mask | TTWL | VALID 的 HDBSS 条目。TTWL 取 KVM_PGTABLE_LAST_LEVEL(末级页表层级),告诉硬件在 stage-2 的哪一级处理该 IPA——因为手工分裂后脏页对应的是 4KB 末级 PTE。
④ 底层执行器:写寄存器 + 轮询完成(patch 04/11)
+static void hacdbs_start(u64 *hw_entries, int size)
+{
+	u64 br;
+	int size_b = size * sizeof(hw_entries[0]);
+	int size_p2 = max(roundup_pow_of_two(size_b), PAGE_SIZE);
+
+	if (size_b < size_p2)
+		hw_entries[size] = HDBSS_ENTRY_VALID | HDBSS_ENTRY_TTWL_RESV;
+
+	sysreg_clear_set_s(SYS_HACDBSCONS_EL2,
+			   HACDBSCONS_EL2_ERR_REASON | HACDBSCONS_EL2_INDEX, 0);
+
+	br = (virt_to_phys(hw_entries) & HACDBSBR_EL2_BADDR_MASK) |
+	     FIELD_PREP(HACDBSBR_EL2_SZ, ilog2(size_p2) - 12) |
+	     FIELD_PREP(HACDBSBR_EL2_EN, 1);
+
+	/* All writes to the array have to complete before starting */
+	dsb(ishst);
+	write_sysreg_s(br, SYS_HACDBSBR_EL2);
+	isb();
+}
▲ 数组大小按 2 的幂向上取整(roundup_pow_of_two),不足时末尾放一个 TTWL_RESV 保留条目作为 stop 哨兵;dsb(ishst) 保证 CPU 写完数组后硬件才开始读,这是 v3 新增的屏障。
+	hacdbs_start(hw_entries, size);
+
+	do {
+		cons = read_sysreg_s(SYS_HACDBSCONS_EL2);
+		if (FIELD_GET(HACDBSCONS_EL2_ERR_REASON, cons))
+			break;
+		if (FIELD_GET(HACDBSCONS_EL2_INDEX, cons) >= size)
+			break;
+		udelay(1);
+	} while (true);
+
+	ret = hacdbs_stop(size);
▲ v2 用 wfi() 等 IRQ,v3 改为轮询 consumer 寄存器:ERR_REASON 非零(出错)或 INDEX 越过数组(正常完成)即退出。udelay(1) 让出总线。preempt_notifier(hacdbs_sched_in/out)在抢占时保存/恢复 HACDBSBR/CONS、VTTBR/VTCR、HCR_EL2.VM——这是 v3 相对 v2 的关键改动,解决长 buffer 下 preempt_disable 过久的可调度性问题。
⑤ dirty-ring 侧:只把成功条目置 invalid(patch 10/11)
+	write_lock(&kvm->mmu_lock);
+	ret = dirty_bit_clear(kvm, hw_entries, i);
+	write_unlock(&kvm->mmu_lock);
+
+	/* Set as invalid all successfully cleaned entries */
+	for (int j = 0; j < ret; j++) {
+		struct kvm_dirty_gfn *entry;
+		entry = &ring->dirty_gfns[(ring->reset_index + j) &
+					  (ring->size - 1)];
+		kvm_dirty_gfn_set_invalid(entry);
+	}
+
+	/* In case of error, try software cleaning from the faulting entry */
+	ring->reset_index += ret;
+	*nr_entries_reset += ret;
+
+	if (ret < i)
+		return -EAGAIN;
+	return ret;
▲ 关键行:kvm_dirty_gfn_set_invalid(entry) 只对 成功清理的 ret 个条目标记失效,reset_index 只推进 ret;若 ret < i(硬件中途出错)返回 -EAGAIN,通用层 kvm_dirty_ring_reset() 从故障条目继续软件清理,不丢脏页。这是 dirty-ring 与 bitmap 共用同一底层、但错误语义更精细的体现。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
(a) KVM_GET_DIRTY_LOG(dirty-bitmap,无 manual protect)dirty_log_perf_test -m 3 -m 6 -m 12 -g | ARM Fast Model 模拟器,1GB / 3GB guest | 基线 ioctl 运行时 | -87.36%(1GB,stdev 0.08%);-87.22%(3GB,stdev 0.01%) |
(b) KVM_CLEAR_DIRTY_LOG(dirty-bitmap,manual protect)dirty_log_perf_test -m 3 -m 6 -m 12 | 同上 | 基线 ioctl 运行时 | -85.72%(1GB,stdev 0.08%);-86.10%(3GB,stdev 0.04%) |
(c) KVM_RESET_DIRTY_RINGS(dirty-ring,4096 条目/vcpu)dirty_log_perf_test -m 3 -m 6 -m 12 -d 4096 | 同上 | 基线 ioctl 运行时 | -70.08%(1GB,stdev 0.24%);-69.99%(3GB,stdev 0.03%) |
数据出处:v3 cover letter(Message-ID 20260729104548.3439958-1),作者自报,未独立验证;作者原文「those syscalls are from 3.3x to 8x faster」,且「已包含 [4](HDBSS S2 巨页分裂改进)带来的收益」。cover letter 原文把 dirty-ring 用例也标为 (b),本文按语义标注为 (c)。注意:运行环境为 ARM 模拟器(作者自报「Tests ran in the model」),非真实服务器。
mmu_lock 时可能被抢占/自旋等待其他 vCPU 释放锁。HACDBS 的收益来自两部分:① 把 on-CPU 的逐页循环换成一次寄存器写 + 硬件异步走页表(host 只付组装数组 + 轮询的少量指令);② 大幅缩短持 mmu_lock 的时间(软件路径持锁跑完整个循环,硬件路径只持锁做数组提交与 TLBI),间接降低其他 vCPU 在锁上的 off-CPU 等待。作者未提供单独区分 on/off-CPU 的数据,此分析为逻辑推断(解读(AI 分析))。补丁同样未提供端到端迁移总时长/停机时间的实测,只给了三个 ioctl 的运行时缩短。
🔄 方案演进 + 💬 讨论焦点
- 04-30 v1(12 补丁):cover letter。首版用
wfi()+ HACDBSIRQ 等待完成,含 ACPI 中断使能,preempt_disable 保护。 - 04-30/05-03 v1 评审:Marc Zyngier(KVM/arm64 维护者)连发两封(86bjf0zj2p.wl-maz、86a4ukzel3.wl-maz)——「MAINTAINERS 不需要专有条目」;「
trace_printk()是大忌,调试设施应删除」;对 1×PAGE_SIZE 缓冲:「How long is a piece of string? 4KB 下太小,缓冲大小应由 userspace 控制,绝非内核参数、更非编译选项」;「我完全不信这些 selftests」,要求生产规模的 VMM 双机热迁移 + 内存压力(swap)测试,并明确「我对效率感兴趣:HACDBS 比现在的逐页缺页好多少?只给特性不给量化收益,不足以决定采纳」。Mark Brown 对 sysreg 补丁给Reviewed-by(afaehWCHVIN7EXNB@sirena.co.uk,「Checked against DDI0601 2026-03」)。 - 06-29 v2(13 补丁):cover letter。新增「Detect (via ACPI) and initialize HACDBSIRQ」补丁(v2 05/13),仍用 IRQ 等待。
- 06-29/06-30 v2 评审:Oliver Upton(KVM/arm64 维护者)评基础例程(akKtKH8O5hngLenm@kernel.org):「
HCR_EL2.VM应在__load_stage2()之后置位(speculative AT errata 依赖顺序);需 ISB 保证载入 MMU 与使能 HACDBS 有序」;对wfi()等待:「这正是我之前说该直接轮询硬件的原因——IRQ 完全可能在 wfi 之前到达」,并要 Leo「只先用轮询,IRQ 以后再说」(akQTypBfpdqSMhm_@kernel.org)。 - 07-29 v3(11 补丁):cover letter。按 changelog 采纳上述评审:完成检测改轮询寄存器(不再用 HACDBSIRQ,ACPI 使能一并移除,修掉 wfi 可能永等的问题);清理例程改 preempt_notifier(保存/恢复寄存器,替代长时间 preempt_disable);修 dirty-ring 无效 memslot/range 的错误路径;加
dsb()屏障;修 dirty-bitmap 分裂跳过范围;把 v2 的 patch 1&2 合并。 - 截至 08-03 lore 索引:v3 系列未见新的公开回复(索引截止 2026-08-03,滞后 2 天)。
- 焦点 1(v3 已采纳):等待机制 IRQ vs 轮询。Oliver 明确指出 wfi/IRQ 的「IRQ 先到」竞态且「不应假设 WFxT 可用」,v3 因此改为轮询
HACDBSCONS_EL2。 - 焦点 2(v3 已采纳):寄存器顺序。HCR_EL2.VM 必须在
__load_stage2()之后置位并加 ISB(v3 的dirty_bit_clear()已按此重排)。 - 焦点 3(部分采纳/待决):缓冲大小由 userspace 控制。Marc 要求缓冲不固定为 1×PAGE_SIZE;v3 的
__kvm_arch_dirty_ring_clear()改用max(ring->size * 8, PAGE_SIZE)随 ring 大小伸缩,但「userspace 显式可配置」的接口仍未落地(解读(AI 分析):v3 尚未引入新 API,与 cover letter「creates no new API」一致)。 - 焦点 4(待满足):测试可信度与量化收益。Marc 要求生产规模双机热迁移 + 内存压力测试;v3 仍以模型 + selftests 为证据,cover letter 已给 ioctl 级量化数据,但双机/swap 场景尚未补齐。
⚠️ 风险与局限
- 硬件不可用时零收益但有回退成本:
kvm_arch_dirty_clear_enabled()要求system_supports_hacdbs()+ DBM 页表;无 HACDBS 的 CPU 恒走-EPERM回退,行为与旧代码一致(cover letter 承诺的零运行时影响)。 - 轮询忙等的 CPU 占用(解读(AI 分析)):
dirty_bit_clear()的udelay(1)轮询循环在硬件处理大数组期间占用当前 CPU;虽然比逐页软件循环短,但对延迟敏感宿主仍是可测开销。作者用 preempt_notifier 缓解了「长时间关抢占」,但轮询本身的 CPU 周期未提供量化数据。 - 错误路径的原子/回写正确性:出错时 bitmap 侧用
atomic_long_or回写(与 vCPU 并发置位竞争),dirty-ring 侧只推进成功数。这个「部分成功」语义正确性依赖HACDBSCONS_EL2.INDEX的可靠性;若硬件错误索引不可信,可能重复清理或漏清理(解读(AI 分析),补丁未给出故障注入测试)。 - 依赖未合入的 HDBSS 系列:cover letter 明确「not ready to be merged, as it depends on bits from another patchset」(HDBSS,Tian Zheng/Huawei);patch 01/11 是临时拼凑的 HDBSS bits。上游合入节奏受该系列制约。
- 架构通用接口的接受度:Marc 不想要专有 MAINTAINERS 条目(归 KVM/arm64 维护),但「架构通用钩子放
include/linux/、CONFIG_HAVE_KVM_HW_DIRTY_BIT全局开关」是否会与 x86 等其他架构的 dirty-log 方式冲突,仍待 Paolo Bonzini 等通用层维护者表态(解读(AI 分析))。 - 测试覆盖不足:Marc 对 selftests 明确「毫无信任」,要求生产规模双机热迁移 + 内存压力测试;当前只有模型 + selftests,迁移总时长/停机时间未量化。
🔗 交叉引用
- FEAT_HDBSS(硬件脏位设置):Tian Zheng / Huawei 系列 — 免写缺页的硬件脏位记录,要求 stage-2 PTE 带 DBM 并配合 eager 巨页分裂;本系列 HACDBS 是其「清理」侧的互补加速,且依赖其合入。
- S2 巨页分裂改进:[4](cover letter 引用)— 性能数字已包含其收益;patch 07/11「avoid splitting previously split blocks」进一步减少重复分裂。
- dirty_log_perf_test 使能 dirty-ring:[3](cover letter 引用)— 本系列性能测试所用的测试补丁。
- Marc Zyngier 评审(v1):86bjf0zj2p.wl-maz / 86a4ukzel3.wl-maz — 缓冲 userspace 化、去 trace_printk、要生产级测试与量化收益。
- Oliver Upton 评审(v2):akKtKH8O5hngLenm / akQTypBfpdqSMhm_ — 寄存器顺序、ISB、轮询替代 IRQ。
✅ 关键洞察
- 定性:这是 arm64 KVM 在「脏页记录已硬件化(HDBSS)」之后,把清理侧也硬件化(HACDBS)的特性+优化系列,核心收益是把迁移每轮的脏页清理从 O(脏页数) 软件循环降为 O(数组大小) 提交 + 硬件批量走页表。
- 证据:作者自报(未独立验证)dirty_log_perf_test 在 ARM 模型上三个 ioctl 运行时 -70%~-87%(3.3x–8x 更快);机制有逐字 diff 支撑;Marc/Oliver 两轮维护者评审意见与 v3 changelog 一一对应。
- 边界:仅 arm64 + FEAT_HACDBS + DBM 页表生效,其余平台/CPU 完全走软件路径零行为变化;性能数字来自模型非真实服务器,迁移总时长/停机时间未量化。
- 风险 / 建议:系列明确依赖未合入的 HDBSS 系列,合入节奏受其制约;待决项包括「缓冲 userspace 可配置」接口、生产规模双机热迁移 + 内存压力测试、以及通用层维护者对新增架构钩子的态度。建议关注 v4 是否落地 userspace 缓冲控制与真实硬件(非模型)基准。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。