mm: add fast path for AS_NO_DIRECT_MAP
💡 一句话总结
在机密计算场景需要把敏感页(guest_memfd / memfd_secret)从内核 direct map(内核的线性映射,即直接映射物理内存的虚拟地址区间)移除以防 Spectre 侧信道攻击时,旧的 AS_NO_DIRECT_MAP 机制每分配/释放一页都要逐页做 set_memory + 一次 TLB flush(开销大、无法摊销);本补丁是 26 篇系列《mm: Add ALLOC_UNMAPPED and AS_NO_DIRECT_MAP》的收尾篇,让页分配器直接提供"已不在 direct map"的页(ALLOC_UNMAPPED,按 pageblock 批量),并把清零改经 mermap(临时映射)完成——TLB flush 从"每页一次"变成"整块一次性摊销"。系列基准(Firecracker 填充 guest 内存,Sapphire Rapids,作者自报未独立验证):populate_latency 从 1.04s 降至 313.02ms(-70.0%)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(hot-path:让 AS_NO_DIRECT_MAP 走分配器快速路径,摊销 TLB flush) |
| 状态 | In Review(v3,尚未合入主线;lore 无 commit_oid,主线 git 也检索不到 ALLOC_UNMAPPED) |
| 当前版本 | v3(26/26)· lore 链接 |
| 版本演进 |
v1(RFC)(02-25,19 篇)→ v2(03-20,22 篇)→ v3(07-26,26 篇) (各版本超链接已通过 checking-references 验证) |
| 作者机构 | Brendan Jackman(Google);系列合作者:Patrick Roy(引入 AS_NO_DIRECT_MAP)、Nikita Kalyazin(folio_{zap,restore}_direct_map 助手) |
| 提交日期 | 2026-07-26(v3) |
| 改动范围 | 9 文件,+222/-31 行;主体在 mm/filemap.c(约 108 行改动) |
| 核心函数 | mapping_alloc_flags() / prep_add_unmapped_folio() / mermap_clear_folio() / mapping_check_flush_mermap() |
| 原始链接 | lore Message-ID(系列 cover:v3 00/26) |
📊 速览卡片
🎯 解决什么问题
问题所在:已有的
AS_NO_DIRECT_MAP 机制(一个"该地址空间的页不在 direct map"的标志,由 Patrick Roy 在 guest_memfd 系列中引入)用 folio_zap_direct_map() / folio_restore_direct_map() 按需映射/取消映射:每分配一页就调一次 set_memory 改页表、每页触发一次 TLB flush(跨核 shootdown)。当大量页都需要移除时,TLB flush 的成本完全无法摊销,填充 VM 客户机内存这样的热路径会慢得不可接受。作者动机(cover letter 原文):本系列的目标是"高效分配不在 direct map 的页",服务于两个近期目标:① guest_memfd 从 direct map 移除的努力(TLB 条目消除的难题);② 地址空间隔离 ASI(Address Space Isolation,见 linuxasi.dev)。作者把它称为给页分配器"塞进去的特洛伊木马"(Trojan horse),最终让"分配无 direct map 别名页"成为页分配器的一等公民能力。
AS_NO_DIRECT_MAP 是 address_space(页缓存映射的元数据结构)里的一个标志位,表示"本映射中的 folio 不在 direct map"。补丁前它的生命周期是:分配普通页(页在 direct map)→ 清零 → folio_zap_direct_map() 把页从 direct map 摘掉(逐页 set_memory 操作)→ 映射给用户;释放时再 folio_restore_direct_map() 映射回来。缺陷链条:每次分配/释放都伴随逐页
set_memory(修改页表属性,涉及 per-pte 操作)和一次 TLB flush(IPI 打到所有核)。页表属性和 TLB 是 CPU 的共享资源,逐页操作在"大量页需要免映射"的场景下开销被线性放大,且没有任何批量摊销机制——这是本补丁要解决的系统缺陷。
write() 逐块把数据写入 guest 内存,每块都要经过"分配不在 direct map 的页"路径;以及 memfd_secret(secretmem)这类一次性大量敏感页分配。为什么此场景受影响:客户机内存动辄几百 MB 到数 GB,按 4KB 页算就是数十万次逐页
set_memory + 逐页 TLB flush。TLB shootdown 在多核机器(作者基准用的 Sapphire Rapids)上开销尤其大——每核都要响应 IPI 并刷 TLB。填充延迟几乎被 TLB flush 主导,这正是系列基准测到的"1.04s → 313ms"差异所在。
🧩 核心机制
三层基石(由系列前 25 篇搭好)+ 本补丁把它们接到 AS_NO_DIRECT_MAP 上:freetypes(让分配器能按"是否在 direct map"索引空闲页)→ ALLOC_UNMAPPED(分配"已免映射"的页)→ mermap(临时映射,用于给免映射页清零)。本补丁是第 26/26 篇,把 page cache 的 AS_NO_DIRECT_MAP 从"按需映射"切到"分配即免映射"。
mapping_alloc_flags()——当映射设了 AS_NO_DIRECT_MAP 且内核同时开启 CONFIG_MERMAP 与 CONFIG_PAGE_ALLOC_UNMAPPED 时,返回 ALLOC_UNMAPPED。这个 alloc_flags 一路穿透 __filemap_alloc_folio → __folio_alloc_mpol_noprof → 页分配器,分配器从"freetype 带 UNMAPPED 标志的 pageblock 池"里取页——这些页本来就不在 direct map。② 清零侧(本补丁最棘手处):免映射页不能像普通页那样直接经 direct map 写 0(它不在 direct map)。解决方案是 mermap(ephemeral mapping,临时映射):在进程地址空间里预留一块 mm-local 虚拟区,把物理页临时映射进去、
clear_page 清零、再解除映射。新函数 mermap_clear_folio() 做这件事——全程不经 direct map。③ 释放侧:快速路径下页"从不回到 direct map",所以释放时不再需要
folio_restore_direct_map() + 再次清零(旧逻辑清零是因为页会回到 direct map、暴露给侧信道)。取而代之的是置一个 AS_MERMAP_STALE 标志,由 mapping_check_flush_mermap() 在合适时机做整块 flush_tlb_all()——这是 TLB flush 摊销的关键:不是每页刷一次,而是"整个 address space 一次刷掉"。与
__GFP_ZERO / 旧 __GFP_UNMAPPED 的关系:分配器自己无法给免映射页清零(分配器用 mermap 清零会泄露安全边界),因此 ALLOC_UNMAPPED 与 __GFP_ZERO 不兼容(mapping_set_gfp_mask() 里加了 WARN_ON),清零责任上移到 page cache——用 AS_NO_DIRECT_MAP 隐含"分配后清零 + 释放前清零"的语义。系列 v1/v2 曾把它做成 GFP 位(__GFP_UNMAPPED),v3 因 GFP 位空间紧张改为 mm/ 内部的 ALLOC_UNMAPPED。
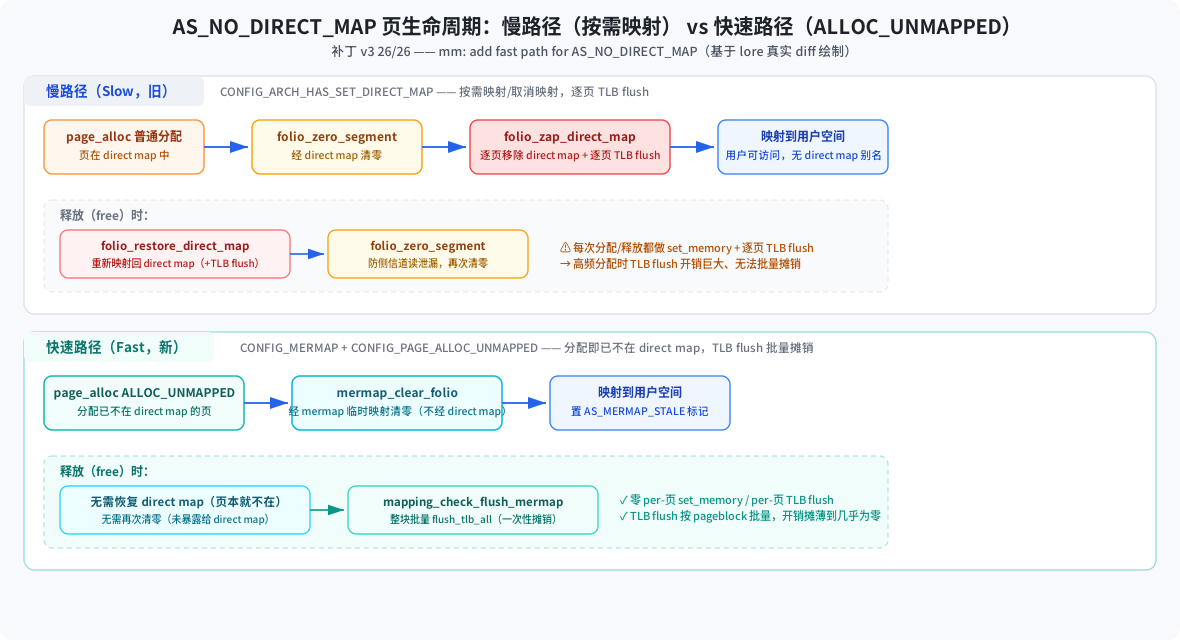
来源:基于 lore 真实补丁 diff(v3 26/26)绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 分配 | mapping_alloc_flags() 返回 ALLOC_UNMAPPED | 分配器从免映射 pageblock 池取页,页已不在 direct map |
| 清零 | mermap_clear_folio() | 经 mermap 临时映射清零,不经 direct map |
| 登记 | mapping_set_mermap_stale() | 置 AS_MERMAP_STALE,提示有陈旧 mermap TLB 项 |
| 释放 | mapping_check_flush_mermap() | 整块 flush_tlb_all(),批量摊销;不 restore direct map、不再清零 |
🔬 关键代码
以下 diff 逐字来自 lore_patch 的 v3 26/26 补丁原文。按"核心逻辑点"组织,每段讲"为什么这么写"。
+static inline unsigned int mapping_alloc_flags(struct address_space *mapping)
+{
+#ifdef CONFIG_PAGE_ALLOC_UNMAPPED
+	if (IS_ENABLED(CONFIG_MERMAP) && mapping_no_direct_map(mapping))
+		return ALLOC_UNMAPPED;
+#endif
+	return ALLOC_DEFAULT;
+}
▲ 逻辑点 1(分配侧开关):只有"映射设了 AS_NO_DIRECT_MAP"且 "mermap 与免映射分配都编译进来了"才返回 ALLOC_UNMAPPED。关键在双条件:IS_ENABLED(CONFIG_MERMAP) 是编译期常量,确保在没有 mermap 的架构上分支被优化掉、返回默认值——slow path 因此作为"无 mermap 系统的回退"保留。
+/* Fast version: pages are already unmapped, but need zeroing. */
+#if defined(CONFIG_MERMAP)
+static inline int prep_add_unmapped_folio(struct address_space *mapping,
+					  struct folio *folio)
+{
+	int err;
+
+	if (!mapping_no_direct_map(mapping))
+		return 0;
+
+	err = mermap_mm_prepare(current->mm);
+	if (err)
+		return err;
+
+	mermap_clear_folio(folio);
+	mapping_set_mermap_stale(mapping);
+	return 0;
+}
▲ 逻辑点 2(新增页的 fast path):对比旧的 slow path(清零后 folio_zap_direct_map() 逐页摘 direct map),fast path 拿到的是"已在页分配器里免过映射"的页,所以省掉了 zap;但页是脏的,必须清零——这里调用 mermap_mm_prepare(current->mm) 确保当前进程的 mm-local 区已就绪,再 mermap_clear_folio() 清零。关键一行:mapping_set_mermap_stale(mapping)——记住"本映射可能残留了指向这些页的 mermap TLB 项",供释放时统一刷。注意清零后页会经 mermap 暴露给当前进程(CPU 侧信道),因此"这些页属于当前进程"是安全前提——这就是为什么分配器自己不能做这件事、要上移到 page cache。
+/* Slow version: zap and flush direct map on-demand. */
+#elif defined(CONFIG_ARCH_HAS_SET_DIRECT_MAP)
 static inline int prep_add_unmapped_folio(struct address_space *mapping,
 					  struct folio *folio)
 {
 	if (!mapping_no_direct_map(mapping))
 		return 0;

+	/*
+	 * Note under this configuration, we could have just allocated with
+	 * __GFP_ZERO. But for consistency with the ALLOC_UNMAPPED version it's
+	 * forbidden, so zero manually.
+	 */
+	folio_zero_segment(folio, 0, folio_size(folio));
+
 	return folio_zap_direct_map(folio);
 }
▲ 逻辑点 3(无 mermap 系统的 slow path 回退):作者特意在注释里点明——这个配置本可以直接用 __GFP_ZERO 让分配器清零,但为了与 ALLOC_UNMAPPED 版本行为一致(免映射分配与 __GFP_ZERO 不兼容),这里手动 folio_zero_segment() 清零再 zap。这保证了两种路径语义一致:AS_NO_DIRECT_MAP 都隐含"分配后清零"。
+static inline void mapping_check_flush_mermap(struct address_space *mapping)
+{
+	/*
+	 * Note this flush is hugely over-aggressive: only the mermap region
+	 * needs flushing, but assume that flushing the whole address space is
+	 * faster. Also only certain mm's (most of the time, just current->mm)
+	 * actually have stale entries, but assume the benefit of tracking that
+	 * would be minimal.
+	 * ...
+	 */
+	if (mapping_grab_mermap_stale(mapping))
+		flush_tlb_all();
+}
▲ 逻辑点 4(释放侧:批量 TLB flush):这就是"摊销"的实现。不是每页刷一次,而是用 test_and_clear_bit(AS_MERMAP_STALE) 一次性消费标志,然后 flush_tlb_all() 整块刷。作者在注释里自认这是"极度过度激进"(只该刷 mermap 区、且多数 mm 根本没有陈旧项),但假设"整地址空间一次刷"仍比逐页刷快——这是本补丁性能主张的核心,也是后续可优化点(见"风险与局限")。
-static void secretmem_free_folio(struct folio *folio)
--{
--	folio_zero_segment(folio, 0, folio_size(folio));
--}
--
 static const struct address_space_operations secretmem_aops = {
 	.dirty_folio	= noop_dirty_folio,
-	.free_folio	= secretmem_free_folio,
 	.migrate_folio	= secretmem_migrate_folio,
 };
▲ 逻辑点 5(清零责任上移):secretmem 之前自己在 free_folio 里清零(因为它会回到 direct map);切到快速路径后页不再回到 direct map,这个回调就被删掉了——清零语义被统一收进 AS_NO_DIRECT_MAP 的 prep_add/remove_unmapped_folio 里,避免每个使用者各写一套。
📈 性能影响
数据出处:系列 cover letter(v1/v2/v3 相同表格)提供了一组基准,作者自报,未独立验证。注意这是整系列(含前版本 + guest_memfd 免映射 + mermap)在 Firecracker 场景测的,不是本补丁单独拆出的微基准。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| Firecracker populate_latency:填充 guest 内存(经 write() 逐块写入,走 mermap) | Sapphire Rapids 机器,30 samples | baseline(仅 secret-free 补丁):1.04s(mean,min 1.02s) | gfp_unmapped 分支:313.02ms(mean,min 299.48ms,-70.0%) |
| 对照:skip-flush(完全跳过 TLB flush,性能上界参考) | 同上 | — | 325.80ms(mean,-68.8%) |
说明:作者结论"已接近该负载的 best case"——gfp_unmapped 与 skip-flush 几乎持平(样本均值甚至略快,作者注明是噪声,非稳定观测)。本补丁 26/26 未单独提供微基准,上表数字来自系列级评测。
on-CPU vs off-CPU 视角(解读(AI 分析)):本补丁优化的是 on-CPU 计算——慢路径每 folio 一次的 set_memory(逐 PTE 改页表属性)和逐页 TLB shootdown(发 IPI 让所有核刷 TLB)被消除,换成按 pageblock 批量的 flush_tlb_all()。清零的 CPU 工作量(memset 一页)仍在(经 mermap 完成),但不再伴随逐页的页表/页目录操作。off-CPU 收益主要来自减少 IPI 等待:逐页 shootdown 时各核要响应并等待刷 TLB,批量后这类跨核同步大幅减少(解读(AI 分析),补丁未提供 off-CPU 分解数据)。
🔄 方案演进
系列从 v1(RFC)到 v3 的演进过程(基于 lore 各版本 cover letter 的 changelog 真实信息):
__GFP_UNMAPPED GFP 位 + freetypes + mermap 的完整设计。作者标注两个已知问题:① __GFP_UNMAPPED 在 guest_memfd 免映射合入前无实际用途;② 实现 mm-local 区时忘了 KPTI 在 32 位系统上存在,预期 0-day bot 会报错。v2(22 篇):① 采纳到 secretmem(patch 22 用
__GFP_UNMAPPED 改造 secretmem);② 修复 mm-local 区在 KPTI+PAE 下的问题;③ 给 __apply_to_page_range() 加 flags 参数(服务 mermap 的页表管理);④ 给 mermap_get() 加故障注入并修了暴露的 bug。v3(26 篇,本版):最大变化是放弃
__GFP_UNMAPPED,改为 ALLOC_UNMAPPED(GFP 位空间紧张,改走 mm/ 内部的 ALLOC_ 标志);放弃分配器侧清零(v2 曾支持 __GFP_UNMAPPED|__GFP_ZERO 由分配器经 mermap 清零),改为 page cache 处理;补上"pageblock 重新映射前清零"的缺失逻辑;expand() 重构 __rmqueue_direct_map();rebase 到一系列预备补丁(folio-alloc-cleanups、alloc-trylock、gfp-pessimisation 等)并修了 v2 的 flags 管道 bug。系列从 22 篇扩到 26 篇,本补丁(fast path)从 secretmem 场景推广到 AS_NO_DIRECT_MAP。
__GFP_UNMAPPED(GFP 位),v3 改为 ALLOC_UNMAPPED——因为 GFP 位空间有限(cover letter 引用 gfp64 讨论),且 ALLOC_ 标志把能力限制在 mm/ 子树,避免污染全内核的 GFP 接口。清零责任归属:v2 让分配器经 mermap 清零(
__GFP_UNMAPPED|__GFP_ZERO),但产生"泄漏抽象"——page_alloc 用户要自己管理 mermap 的 TLB flush。v3 改为"AS_NO_DIRECT_MAP 隐含清零、page cache 负责",作者承认这"可能不是其他 AS_NO_DIRECT_MAP 用户想要的",未来可能要加新 AS_ 标志或重构清零位置。
💬 讨论焦点
作者回应(同一天):因为"目前只有一种 migratetype 支持被免映射"只是 guest_memfd 用例的暂时巧合;长期要支持"任意 migratetype 的免映射变体",所以需要 freetype 这种正交扩展,而不是给每种 migratetype 都硬编码一个新类型。
作者回应——这是本系列性能主张的核心论证:
- 关键不是内存的默认状态,而是 TLB flush 的批处理(batching)
- 每分配一页就做一次 TLB flush 是性能不可接受的(performance nonstarter)——这正是本系列存在的全部理由;如果能承受每分配一次 flush,guest_memfd 直接用现有的 direct map 移除系列就够了
- 反过来,如果系统里大部分页最终都该是免映射的,那么"free 时 remap、alloc 时 unmap"的绝大多数 map/unmap 往返都是白做的(map 完马上又会被 unmap)
write() 没有 user address。
⚠️ 风险与局限
flush_tlb_all() 极度过度激进(作者在代码注释中自认):只该刷 mermap 区,却刷了整个地址空间;只有少数 mm(通常只是 current->mm)有陈旧项却不去跟踪。在多核、频繁释放的场景,整地址空间 flush 可能比"精确刷"慢——作者希望"整刷假设更快",但未量化。若未来被证伪,需要用更深的 TLB flush 逻辑替换这个简单标志(严重度 MAJOR 的潜在性能回归点)。② 侧信道安全边界敏感(CRITICAL 类):
AS_MERMAP_STALE 是单个位,粒度粗。若清零经 mermap 暴露页给当前进程后又没及时刷掉陈旧 TLB 项,该进程理论上可通过 CPU 侧信道读到其他使用者留下的数据。mermap 的安全前提是"页属于当前进程"——本补丁把清零放到 page cache 正是为了守住这条边界,但 AS_MERMAP_STALE 的粗粒度意味着"宁可多刷"换取安全。③ 清零语义硬编码进 AS_NO_DIRECT_MAP(作者自述):v3 "把当前想要的清零逻辑硬挂到 AS_NO_DIRECT_MAP 上作为副作用"。作者承认这可能不是其他未来用户的期望,未来需新 AS_ 标志或重构。这是设计层面的灵活性局限(MINOR-MAJOR)。
④ 功能边界:本系列中免映射分配仅支持 unmovable 分配(作者称是"为省数据结构空间",实现本意是通用的);mermap 目前仅 x86 有实现(其他架构走 slow path 回退);
set_direct_map_*() 不支持 large folio(mapping_set_no_direct_map() 有 WARN_ON)。⑤ review 状态:v3 尚未合入主线;Gregory 的质疑作者已回应但自由设计选择(freetype、批量 TLB flush)仍待 mm 维护者(Andrew Morton / David Hildenbrand 等在收件人列表)拍板。
🔗 交叉引用
v3 cover letter(mm: Add ALLOC_UNMAPPED and AS_NO_DIRECT_MAP) — 系列问题/设计/性能基准的权威出处
v1 RFC(__GFP_UNMAPPED) — 初始设计(GFP 位方案 + 已知问题清单)
v2(__GFP_UNMAPPED,采纳 secretmem) — 分配器侧清零方案的版本
Address Space Isolation(ASI) — 长线受益者:ALLOC_UNMAPPED 与 mermap 是 ASI 高效的基石(作者自称"特洛伊木马")
LPC 演讲:memory-firewalled client devices(Sumit Garg) — 非安全用例:免映射分配可用于内存防火墙设备
✅ 关键洞察
- 发现:AS_NO_DIRECT_MAP 的瓶颈不在"分配"而在"TLB flush 无法摊销"——本补丁把清零与取消映射从逐页操作改成"分配器批量免映射 + mermap 临时清零 + 整块 flush",把页分配器变成安全场景的一等公民
- 证据:系列基准(Firecracker populate_latency,Sapphire Rapids,作者自报未独立验证)1.04s → 313.02ms(-70.0%),且已逼近"跳过 TLB flush"的上界(-68.8%);本补丁未单独提供微基准
- 边界:仅在 CONFIG_MERMAP + CONFIG_PAGE_ALLOC_UNMAPPED(目前 x86)生效;其他架构走 slow path 回退(语义一致但无性能收益);免映射分配仅支持 unmovable
- 风险 / 建议:flush_tlb_all() 的激进整刷与 AS_MERMAP_STALE 粗粒度是主要技术债(作者自认);清零语义硬编码进 AS_NO_DIRECT_MAP 待未来解耦。建议后续关注:guest_memfd 合入后该系列的实际落地、以及 mm 维护者对 freetype 扩展设计(Gregory 已质疑)的最终裁定
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。