sched_ext: Add bandwidth-limited rescue execution for stranded tasks
💡 一句话总结
在 sched_ext 子调度器场景下,当任务的可运行 CPU(affinity)被限定在调度器未持有权限(caps)的 cid 上时,插入会被 cap-reject 并反复弹回重入队,直到任务饿死、看门狗踢出调度器,或退出中任务空烧 CPU。本补丁新增 SCX_ENQ_RESCUE 内核兜底执行机制:被拒任务转入每 CPU 的救援队列,由内核按默认 2% CPU 带宽(token bucket)以 5ms 量子运行并保证前向推进,长期得不到服务时升级为受保护执行(SCX_TASK_PROTECTED)强制抢占当前任务。作者未提供基准测试数据。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 新特性(为 sched_ext 增加内核侧"带宽受限救援执行"兜底机制,配套新 ops 字段 + 新 enqueue flag) |
| 状态 | 已合入 sched_ext/for-7.3 维护树(commit 5fd501744b10,2026-08-03)主线(torvalds)未合入——当前主线仍在 7.2-rc 周期,本补丁排队进入 7.3 合并窗口 |
| 当前版本 | v2(含 Andrea Righi 的 compat.h 修复)· v2 lore 链接 |
| 版本演进 |
v1(2026-08-01)→ v2(2026-08-02)→ for-7.3 合入版(2026-08-03) (每版本超链接均可点击;for-7.3 合入版在 v2 基础上补上 Andrea 的 compat.h 兼容修复) |
| 作者机构 | Tejun Heo(Meta,sched_ext 作者/维护者) |
| 提交日期 | v1: 2026-08-01;合入版: 2026-08-03 |
| 改动范围 | v1/v2: kernel/sched/ext/ext.c、sub.c、internal.h、sub.h、types.h、include/linux/sched/ext.h、kernel/sched/sched.h 等 7 文件,+559/-33;合入版另含 tools/sched_ext/include/scx/compat.h(8 文件 +570/-33) |
| 核心函数 | scx_resolve_local_dsq() / scx_rescue_try_admit() / scx_rescue_timerfn() / scx_rescue_charge() / scx_rescue_keep() |
| 原始链接 | Message-ID: 20260801085150.2697653-9-tj@kernel.org(PATCH 08/12) |
📊 速览卡片
🎯 解决什么问题
SCX_CAP_BASE / SCX_CAP_PERF)。cid 是 sched_ext 对 CPU 的分组标识;调度器在某个 CPU 上做入队/抢占等操作前,内核会检查它在该 CPU 的 cid 上是否持有对应 cap。
commit message 开门见山指出问题(20260801085150.2697653-9): "A local DSQ insert lacking the needed caps is diverted to the reject DSQ and bounced back through ops.enqueue() so the scheduler can re-decide. That recovery assumes the scheduler has somewhere legal to send the task. When it doesn't ... the task starves until the stall watchdog ejects the scheduler."
即:现有的"cap 拒绝→弹回重入队"恢复路径,默认假设调度器总有另一个合法去处。当这个假设不成立时,任务没有好下场。
scx_local_or_reject_dsq() 的真实逻辑):子调度器调用 scx_bpf_dsq_insert() 把任务放入本地 DSQ(每 CPU 一个 dispatch queue,调度器放置可运行任务、内核消费执行)。内核在 scx_resolve_local_dsq() 检查该调度器在目标 CPU 的 cid 上是否持有入队所需 caps;若缺失,任务被转入 reject DSQ 并记录重入队原因,随后弹回 ops.enqueue() 让调度器重新决策。这个循环假定"调度器总能找到合法去处"。
当任务的 affinity 被限定在调度器未持有的 cid 上时,这个假设失效,出现两个坏结局:
- 普通任务:反复"入队→被拒→重入队",直到 sched_ext 的重试上限(repeat limit)触发,把调度器整体 eject——一个 BPF 调度器因此被连坐踢出;
- 正在退出的任务(
PF_EXITING):更糟——它跳过ops.enqueue(),cap 拒绝变成一个"自我重入队循环",空烧 CPU 直到看门狗(watchdog)触发。
- 嵌套子调度器:一个 sched_ext 调度器作为子调度器挂载(如
sub_cgroup_id绑到 cgroup),只拿到父级授予的 部分 cid,而非全机 cid; - 任务 affinity 落在未持权 cid:例如任务被
sched_setaffinity()/ cpuset 限定到某几个 CPU,而这些 CPU 的 cid 恰好被授权给了别的子调度器。
scx_do_enqueue_task() 中直接把它放回本地 DSQ(跳过 ops.enqueue()),一旦缺 cap 被拒,就会形成内核自循环,单核 CPU 空转到看门狗触发。
🧩 核心机制
补丁在 sched_ext 里新增一条"内核兜底执行"路径:调度器在入队时用 SCX_ENQ_RESCUE 声明"这个插入如果缺 cap 被拒,请内核帮我跑",内核把这类任务转入每 CPU 的救援队列(rescue DSQ),并按配置的带宽(默认 2%)以 token bucket 方式提供有保证的、限速的 CPU 时间。救援以"持续劣势"运行(无优先级、可被正常任务抢占),只有长期得不到服务才升级为受保护执行。
SCX_DSQ_RESCUE(内置 DSQ)+ SCX_ENQ_RESCUE(仅允许本地 DSQ 插入)。scx_resolve_local_dsq() 在"缺 cap"分支里优先检查该 flag:若携带且救援未禁用(scx_rescue_bw_1024 != 0),则不再弹回 reject,而是转入救援路径。正在退出的任务由内核在 scx_do_enqueue_task() 里自动打上 SCX_ENQ_RESCUE,专门堵死"退出任务自我重入队空烧 CPU"的循环。
② per-CPU token bucket 限速:新增
struct scx_rq_rescue,含救援 DSQ、预算 budget(ns 计)、计时器 timer、当前被救援任务 curr 等。预算按 rescue_bandwidth_ppt(默认 20‰ = 2%)随真实流逝时间进账(scx_rescue_accrue()),从而把救援执行量钉死在配置带宽内——这是"带宽受限"的本质:救援是给卡死任务的救生圈,不是绕过 cap 的后门。
③ 准入与排队:
scx_rescue_try_admit() 在预算攒够一整量子且当前无救援进行时,立即把新卡死任务以整量子入队本地 DSQ 尾部(SCX_ENQ_IGNORE_CAPS,不抢占);否则先停靠 rescue DSQ,由定时器(每量子/4 唤醒一次)在预算足够后放行队首,slice 按 量子 ÷ 等待者数 分配(下限 1ms),多任务排队时轮转。
④ 按实际服务时间计费 + 抢占保留:
scx_rescue_charge() 在 update_curr_scx() 每 tick 扣减预算,按任务真实获得的 CPU 时间(sum_exec_runtime 快照差)计量,而非 slice 名义时间——调度器给救援者续 slice 也不会拖长救援。救援者被正常任务抢占但 slice 未耗尽时,scx_rescue_keep() 恢复剩余 slice 并把它放回本地 DSQ 队尾。
⑤ 升级为受保护执行:若预算累积超过 2 个量子而救援者仍在等待(被反复抢占/插队),
scx_rescue_timerfn() 把剩余 slice 置为 SCX_TASK_PROTECTED,以 SCX_ENQ_HEAD | SCX_ENQ_PREEMPT | SCX_ENQ_IGNORE_CAPS 移到队首并抢占当前任务,保证最终前向推进。升级同样受 token bucket 节流,因此无论调度器多激进,交付服务都收敛于配置带宽。
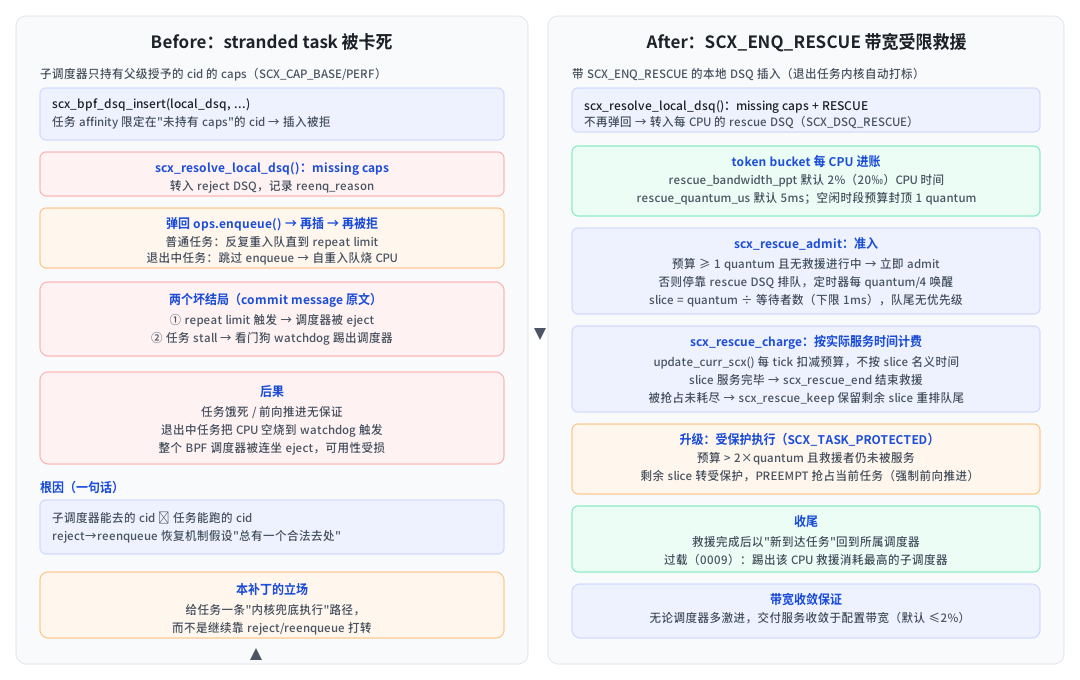
来源:基于 lore 真实补丁 diff(
20260801085150.2697653-9)与 cover letter 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 触发 | 本地 DSQ 插入带 SCX_ENQ_RESCUE(退出任务由内核自动打标) | 声明"缺 cap 时请内核兜底" |
| 分流 | scx_resolve_local_dsq():缺 cap + RESCUE → 转救援路径 | 不再 reject/弹回,避免循环 |
| 限速 | scx_rescue_accrue():按 2% 带宽进账 budget | 救援量钉死在配置带宽内 |
| 准入 | scx_rescue_try_admit() / 定时器放行队首,slice=量子÷等待数 | 一次救援一个,队尾无优先级 |
| 计费 | scx_rescue_charge():按实际服务时间扣 budget | 调度器续 slice 不拖长救援 |
| 保留 | scx_rescue_keep():被抢占则保留剩余 slice 重排 | 救援不被普通抢占打断 |
| 升级 | budget>2×量子且仍等待 → SCX_TASK_PROTECTED + 抢占 | 保证最终前向推进 |
| 收尾 | slice 服务完毕 → scx_rescue_end();任务以新到达身份回所属调度器 | 调度器恢复对任务的正常控制 |
🔬 关键代码
核心逻辑点 1:新 flag 与新 DSQ + 退出任务自动打标
diff --git a/include/linux/sched/ext.h b/include/linux/sched/ext.h
index b519fbc88e17..a6aabbefd185 100644
--- a/include/linux/sched/ext.h
+++ b/include/linux/sched/ext.h
@@ -59,6 +59,7 @@ enum scx_dsq_id_flags {
 	SCX_DSQ_LOCAL		= SCX_DSQ_FLAG_BUILTIN | 2,
 	SCX_DSQ_BYPASS		= SCX_DSQ_FLAG_BUILTIN | 3,
 	SCX_DSQ_REJECT		= SCX_DSQ_FLAG_BUILTIN | 4,	/* internal - see find_dsq_for_dispatch() */
+	SCX_DSQ_RESCUE		= SCX_DSQ_FLAG_BUILTIN | 5,	/* internal - see find_dsq_for_dispatch() */
 	SCX_DSQ_LOCAL_ON	= SCX_DSQ_FLAG_BUILTIN | SCX_DSQ_FLAG_LOCAL_ON,
diff --git a/kernel/sched/ext/ext.c b/kernel/sched/ext/ext.c
@@ -2056,6 +2067,7 @@ void scx_do_enqueue_task(struct rq *rq, struct task_struct *p, u64 enq_flags,
 	if (!(sch->ops.flags & SCX_OPS_ENQ_EXITING) &&
 	    unlikely(p->flags & PF_EXITING)) {
 		__scx_add_event(sch, SCX_EV_ENQ_SKIP_EXITING, 1);
+		enq_flags |= SCX_ENQ_RESCUE;	/* avoid looping on cap rejection */
 		goto local;
 	}
▲ 这里 enq_flags |= SCX_ENQ_RESCUE 是本补丁最"救命"的一行:退出中的任务不经过 BPF 回调,缺 cap 时原本会在内核里自我重入队空烧 CPU。让内核自动给它们打上救援标记,就把这条 CPU 空转路径改成了"进救援队列、等待内核兜底执行"。
核心逻辑点 2:分流决策——缺 cap 时优先转救援而非 reject
diff --git a/kernel/sched/ext/sub.c b/kernel/sched/ext/sub.c
@@ -282,18 +619,27 @@ struct scx_dispatch_q *scx_resolve_local_dsq(struct scx_sched *sch, struct rq *r
 	/*
-	 * Only local DSQ can honor IMMED and dsq_inc_nr() WARNs on IMMED into
-	 * others. Strip both the enq flag and the sticky task flag - the
-	 * latter can carry in from an earlier admitted IMMED insert. Strip
-	 * PREEMPT too.
+	 * Diverting to rescue or reject, neither of which honors IMMED, PREEMPT
+	 * or HEAD - a diversion has no priority and IMMED is not allowed on
+	 * non-local DSQs. Strip the enq and task flags along with the slice.
 	 */
-	*enq_flags &= ~(SCX_ENQ_IMMED | SCX_ENQ_PREEMPT);
+	*enq_flags &= ~(SCX_ENQ_IMMED | SCX_ENQ_PREEMPT | SCX_ENQ_HEAD |
+			SCX_ENQ_APPLY_SLICE | SCX_ENQ_SLICE_DFL);
 	p->scx.flags &= ~SCX_TASK_IMMED;

+	/* the enqueuer opted for rescue instead of rejection and reenqueue */
+	if ((*enq_flags & SCX_ENQ_RESCUE) && likely(scx_rescue_bw_1024)) {
+		__scx_add_event(sch, SCX_EV_SUB_RESCUE, 1);
+		if (scx_rescue_try_admit(rq, p))
+			return &rq->scx.local_dsq;
+		else
+			return &rq->scx.rescue.dsq;
+	}
+
+	p->scx.reenq_reason_caps = missing;
+	p->scx.reenq_reason_cid = cid;
+
 	return &rq->scx.reject_dsq;
 }
▲ 这是"何时救、何时仍拒"的分水岭:只有插入携带 SCX_ENQ_RESCUE 且救援未禁用(scx_rescue_bw_1024 非零)时才走救援;否则保留原 reject 路径(因此 SCX_RESCUE_DISABLE 可以让救援彻底关掉、回归旧行为)。转救援时统一剥掉 IMMED/PREEMPT/HEAD/APPLY_SLICE 等"有优先级"语义——救援者不带任何优先级入队。
核心逻辑点 3:准入 + 升级(定时器驱动)
+static bool scx_rescue_try_admit(struct rq *rq, struct task_struct *p)
+{
+	scx_rescue_accrue(rq);
+
+	if (!rq->scx.rescue.curr && list_empty(&rq->scx.rescue.dsq.list) &&
+	    rq->scx.rescue.budget >= scx_rescue_quantum_ns) {
+		scx_rescue_admit(rq, p, scx_rescue_quantum_ns);
+		return true;
+	}
+
+	scx_rescue_timer_arm(rq);
+	return false;
+}
+	} else if (p->scx.dsq && rq->scx.rescue.budget > 2 * scx_rescue_quantum_ns) {
+		/*
+		 * The rescuee waited for the CPU for too long. Escalate - grant
+		 * the unserved remainder, protect it from the schedulers and
+		 * preempt the current task. The slice is set before the
+		 * protection. Repeat beats only repeat the head move - the
+		 * slice write is refused on a protected task.
+		 */
+		scx_set_task_slice(p, scx_rescue_slice_remaining(rq));
+		p->scx.flags |= SCX_TASK_PROTECTED;
+		scx_task_unlink_from_dsq(p, &rq->scx.local_dsq);
+		scx_move_local_task_to_local_dsq(scx_task_sched(p), p,
+					SCX_ENQ_HEAD | SCX_ENQ_PREEMPT | SCX_ENQ_IGNORE_CAPS,
+					&rq->scx.local_dsq, rq);
+	}
+out_arm:
+	scx_rescue_timer_arm(rq);
+}
▲ 第一段是"快速通道":预算攒够一整量子且当前空闲时立即放行;否则排队。第二段是"强制通道"(scx_rescue_timerfn()):预算累积超过 2 量子而救援者仍未被服务,说明它被普通调度反复压制,于是把剩余 slice 标记为受保护并抢占当前任务。关键在注释:slice 在置保护之前写入,而受保护任务会被拒绝再次写 slice——这防止了调度器通过反复改写 slice 抵消升级。
核心逻辑点 4:按实际服务时间计费 + 抢占保留
+void scx_rescue_charge(struct rq *rq, s64 delta_exec)
+{
+	lockdep_assert_rq_held(rq);
+
+	/*
+	 * A rescue slice is bounded by one quantum and tick-driven expiry can
+	 * overshoot by up to a tick. Clamp to avoid wild over-charges on VMs.
+	 */
+	delta_exec = min_t(s64, delta_exec, scx_rescue_quantum_ns + TICK_NSEC);
+
+	rq->scx.rescue.budget -= delta_exec;
+
+	if (!scx_rescue_slice_remaining(rq))
+		scx_task_slice_ended(rq, rq->scx.rescue.curr);
+}
+bool scx_rescue_keep(struct rq *rq, struct task_struct *p)
+{
+	s64 remaining = scx_rescue_slice_remaining(rq);
+
+	lockdep_assert_rq_held(rq);
+
+	if (!remaining || !(p->scx.flags & SCX_TASK_QUEUED) ||
+	    scx_bypassing(scx_task_sched(p), cpu_of(rq)))
+		return false;
+
+	scx_set_task_slice(p, remaining);
+	return true;
+}
▲ scx_rescue_charge() 的注释点出"服务时间计费"的精髓:救援 slice 以实际获得的 CPU 时间(sum_exec_runtime 快照差)计量,delta_exec 上限被钳到"一量子 + 一个 tick",防止 VM 上 tick 超调造成预算被过度扣减。scx_rescue_keep() 保证"被抢占≠救援中断":剩余 slice 被恢复,任务回到本地 DSQ 队尾继续排。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| 受限 affinity 任务卡死 | 未提供(作者未给环境) | 任务饿死 / 调度器被看门狗踢出 / 退出任务空烧 CPU | 任务以 ≤2% 带宽获得有保证的前向推进 |
说明:本补丁是"前向推进正确性"修复,作者在 commit message 与 cover letter 中未提供任何基准测试数据(无吞吐/延迟数字)。下列为逻辑分析:
- on-CPU(减少空转计算):退出中任务"自我重入队→cap 被拒→再重入队"的循环会持续占用一个核直到看门狗触发。本补丁让这类插入直接进救援队列,消除该 CPU 空烧;这部分是实打实的 on-CPU 收益(省下被浪费的调度器调用与重入队指令)。无量化数据,属逻辑推断。
- off-CPU(减少饥饿等待):被卡住任务原本无限期等待(直到 eject/看门狗),现在最坏情形也能在约 2 个救援周期内得到服务(准入 1 周期 + 升级 1 周期),wall-clock 延迟从"无限/灾难"收敛到有界;对任务而言是 off-CPU 等待时间大幅缩短。同样无量化数据。
- 代价:正常调度会因救援执行损失默认 ≤2% 的 CPU 时间(token bucket 上限),这是设计内可控开销;
rescue_quantum_us越大,单次救援占核越久、打断越少,但救援之间的间隔也越长。
🔄 方案演进
本系列从提出到合入 for-7.3 的演进过程(基于 lore 各版本真实信息,不编造):
sched_ext/for-7.3(ee7aece60817)。0008 即本补丁;0009 为"过载时踢出救援消耗最高的子调度器"。v2 cover(2026-08-02):基于
c5b9316cf3d5。v2 改动来自"sashiko AI review"(作者自述):① scx_sched_all 声明移到 CONFIG_EXT_SUB_SCHED 块外(0002);② 过载宽限与用量衰减时间戳改用 jiffies_64,避免 32 位回绕(0009);③ 删除不再被读取的 always_enq_immed rodata 镜像(0011)。for-7.3 合入版(2026-08-03):在 v2 基础上补上 Andrea Righi 建议的
tools/sched_ext/include/scx/compat.h 兼容修复(__SCX_OPS_OPEN() 中对两个新 ops 字段做 __COMPAT_struct_has_field 检查,旧内核上清零该字段),并获 Reviewed-by: Andrea Righi。
- Andrea Righi(NVIDIA,sched_ext 共同维护者) — anBNAQ_dZ268Ekba@gpd4(2026-08-03,回复 v2 的 0008):"Not a blocker, but should we add compatibility handling for these two optional ops fields in tools/sched_ext/include/scx/compat.h? Otherwise the later scx_qmap patch would break the qmap build with older kernels."
要点:新增的两个 ops 字段(rescue_bandwidth_ppt、rescue_quantum_us)是可选字段;若不处理兼容性,后续 demo 消费者scx_qmap(0012)在旧内核上编译/加载会失败。Andrea 明确说"非阻塞"。
处理结果:for-7.3 合入版(5fd501744b10)在compat.h增加了__SCX_OPS_OPEN()修复(对不支持这两个字段的旧内核清零字段并告警),并在 commit 里标注 "(Andrea)" 来源与Reviewed-by: Andrea Righi——该 review 已闭环。 - Tejun Heo(作者)自述的 AI review 流程 — v2 cover letter(20260802215447.3134509-1):v2 的 3 处改动均来自"sashiko AI review"。这说明该系列在 v1→v2 之间主要由自动化代码评审驱动修正(声明位置、32 位回绕、死代码),而非人工 review 大改机制。
- 无其他公开回复:对 v1/v2 cover letter 与 0008 的回复仅上述一条人工 review(其余回复为系列内补丁本身),David Vernet / Changwoo Min 等未在本话题下公开表态。
- 为什么限速 2%:救援是"兜底"而非"绕权"。给救援一个显式小带宽,既保证被卡任务推进,又把对正常调度(持权者)的干扰压到可忽略水平。默认 2% 可经
rescue_bandwidth_ppt调到最高 25%。 - 为什么"先非破坏、后升级":救援者先以队尾无优先级身份运行,让持权调度器保持对 CPU 的控制(甚至可抢占救援者);只有救援长期得不到服务才升级为受保护执行。这是"对调度器最不打扰"到"必须推进"的渐变设计。
- 为什么按"实际服务时间"计费:若按 slice 名义时间计费,调度器给救援者续 slice 会无限延长救援;按
sum_exec_runtime实测差计费,让救援量与带宽严格挂钩。 - 待观察点(解读(AI 分析)):升级阈值(>2 量子预算)是否在所有调度器行为下都足够快、以及 2% 默认带宽在极端饥饿场景下是否仍能在看门狗超时前完成一次升级(合入版
scx_rescue_set_knobs()内置了 pr_warn 检查:若救援周期超过看门狗超时的 1/8 会告警)。
注:本补丁为单机制多版本,以上为 v1→v2→合入版的完整演进。
⚠️ 风险与局限
- 对正常调度的干扰(解读(AI 分析)):救援执行与升级抢占会打断持权子调度器的调度,虽被 2% 带宽封顶,但在救援任务恰好与高优先级持权任务争抢同一核时,可能给持权任务引入毫秒级延迟抖动。默认 2% 下影响应可忽略,但调高带宽时需权衡。
- watchdog 边界:commit message 自带的防御——若
rescue_quantum_us过大或带宽过低,一个卡死任务可能无法在看门狗超时前完成"准入+升级"两个周期(代码里scx_rescue_set_knobs()会pr_warn)。配置不当仍可能看门狗触发。 - 并发与定时器:per-CPU
timer_list(TIMER_PINNED)+ rq lock 保护;CPU 下线时scx_rescue_flush()结束当前救援、冲刷等待队列并删除定时器。若调度器在救援期间被 eject/bypass,scx_rescue_keep()会因scx_bypassing()返回 false 而结束救援——行为有定义。 - 多核扩展性:救援状态 per-CPU 独立(每核一个 token bucket + 定时器),无跨核共享锁,扩展性良好;唯一的全局量是合入版把
scx_sched_all声明外提(v2 修复点之一),不引入新的全局串行化。 - 失败模式:
SCX_RESCUE_DISABLE时回归旧行为(SCX_ENQ_RESCUE插入如常被拒)——作为逃生舱,保证新机制出问题可整体关闭。
🔗 交叉引用
[PATCHSET v2 sched_ext/for-7.3] cover letter v2 — v2 改动清单(sashiko AI review 三处修正 + v1 链接)(Tejun Heo, 2026-08-02)
Andrea Righi Review — 唯一人工 review:为两个新 ops 字段补 compat.h 兼容处理,非阻塞(2026-08-03)
sched_ext/for-7.3 合入版 commit(5fd501744b10) — 最终合入版本,含 compat.h 修复,Reviewed-by Andrea Righi
✅ 关键洞察
- 发现:sched_ext 的 cap-reject→reenqueue 恢复机制在"子调度器无权覆盖任务 affinity"时失效,导致任务饿死、调度器被看门狗踢出、退出任务空烧 CPU。本补丁用
SCX_ENQ_RESCUE+ 每 CPU 救援队列 + token bucket(默认 2% 带宽、5ms 量子)把"卡死任务"接到一条有界的前向推进路径上,必要时升级为受保护执行强制抢占。 - 证据:无量化基准——作者未提供性能数据。机制本身是正确性/可用性修复;其"on-CPU 省空转、off-CPU 消饥饿"的收益为逻辑推断(解读(AI 分析))。可验证的真实事实是:版本链 v1→v2→for-7.3 合入版、Andrea Righi 的 review 及 compat.h 修复闭环(见讨论焦点)。
- 边界:仅在"嵌套子调度器 + 任务 affinity 落在未持权 cid"时触发;
SCX_RESCUE_DISABLE可整体关闭回归旧行为;升级/看门狗之间存在配置边界(pr_warn防御)。 - 风险 / 建议:新机制复杂度高,建议部署方默认保留 2% 带宽并在压测中观察持权调度器的延迟抖动;后续值得关注 0009(过载踢出最高救援消费者)与
scx_qmapdemo 落地后的社区实测数据。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。