mm/vmscan: reduce lru_lock contention via vmstat-derived scan-balance cost
💡 一句话总结
在内存压力大、持续 swap-out/refault 的多核主机(176 核 / 256 GB)上,页回收路径的 anon/file 扫描平衡成本原本由每个回收生产者(shrink_inactive_list、shrink_active_list、workingset_refault)在 lru_lock 下记账,与真正的 LRU 操作抢同一把锁;作者改为在每次回收周期的 prepare_scan_control() 里用专用 cost_lock 从 vmstat 单调计数器增量推导成本,彻底移除 producer 侧锁获取与 memcg 层级 parent_lruvec 遍历。perf lock 实测总 LRU 锁等待 4.23 s → 1.66 s(-61%),其中两个成本记账点被完全消除(-100%)。数据作者自报,未独立验证。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance) |
| 性能类别 | 锁竞争(消除 lru_lock 上无谓的成本记账临界区) |
| 状态 | In Review(v5,尚未合入 mainline) |
| 当前版本 | v5(3/3)· 当前版链接 |
| 版本演进 | RFC(2026-06-26)→ v1(07-06)→ v2(07-13)→ v3(07-17)→ v4(07-20)→ v5(07-27) |
| 作者机构 | Usama Arif(Meta) |
| 提交日期 | 2026-07-27(本补丁 3/3;系列 1/3 为 _monotonic vmstat 读取器,2/3 为 pgrotate_anon/file 计数器) |
| 改动范围 | 9 文件,+81/-95 行(本补丁;删除 lru_note_cost_unlock_irq()/lru_note_cost_refault() 约 69 行) |
| 核心函数 | prepare_scan_control()(新增 cost_lock 逻辑)/ cost_lock / lruvec_page_state_monotonic() |
| 原始链接 | lore Message-ID |
📊 速览卡片
🎯 解决什么问题
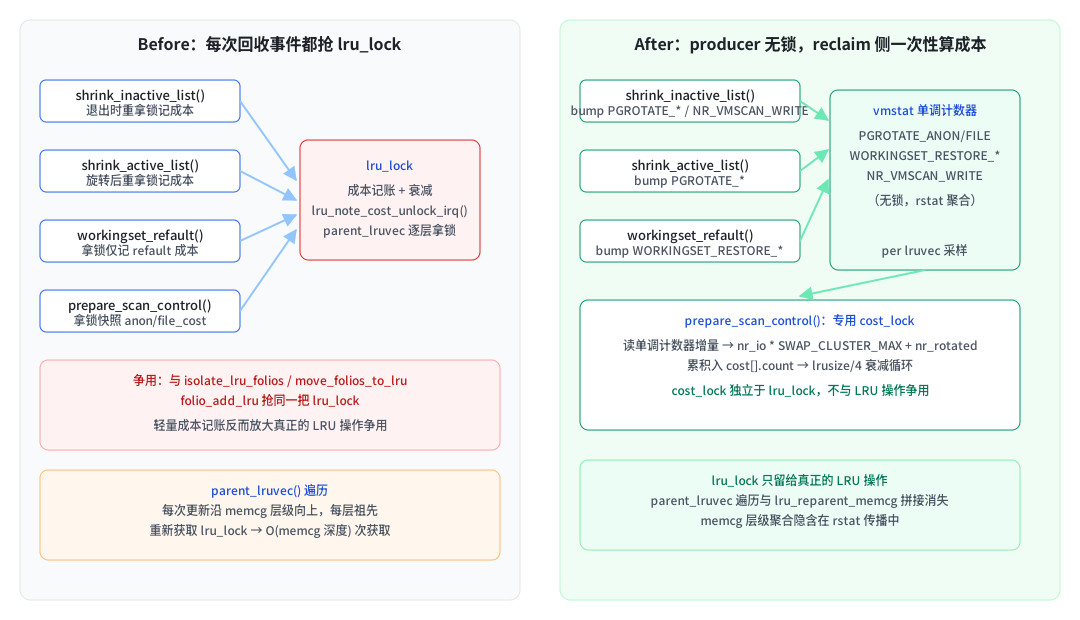
get_scan_count() 需要决定 anon 和 file 两条 LRU 各扫多少——依据是 struct lruvec 里的两个标量 anon_cost 和 file_cost("回收哪边更贵就偏向另一边")。这些标量由每个回收生产者在 lruvec->lru_lock 下更新(cover letter 原话:"accumulated by every reclaim producer under lruvec->lru_lock")。成本记账本身很轻(两次标量加法 + 一次比较),但它要和 isolate_lru_folios()、move_folios_to_lru()、folio_add_lru() 等真正的 LRU 操作抢同一把锁——lru_lock 在内存压力负载下本身就是争用点。
shrink_inactive_list()在函数退出时重新拿锁,只为调lru_note_cost_unlock_irq()——每次 inactive 收缩 1 次获取;shrink_active_list()同样,每次 active 收缩 1 次获取;workingset_refault()通过folio_lruvec_lock_irq()拿锁,只为记录 refault 成本——每次 refault 1 次获取;prepare_scan_control()拿锁只为把两个标量快照进sc->{anon,file}_cost;lru_note_cost_unlock_irq()本身遍历parent_lruvec(),在每层 memcg 祖先重新获取 lru_lock——每次调用额外 O(memcg 深度) 次获取。
memory.max=512M,4 GB anon working set 必须塞进 512 MB —— 造成连续 shrink_inactive_list() + workingset_refault()(cover letter 原文)。在这种负载下每个 CPU 都在反复进出回收路径,refault 事件以每秒数万次触发。为什么该场景遇到缺陷:176 核同时做回收 → 多个 CPU 为成本记账争抢同一个 lruvec 的 lru_lock;refault 每发生一次就要拿一次锁记成本,锁获取频率与内存压力成正比,争用随核数/压力放大。
🧩 核心机制
核心逻辑点(框架 B):① 把"记账"从 producer 移到 reclaim 侧 ② 用 vmstat 单调计数器增量替代 producer 侧 lru_note_cost() ③ 专用 cost_lock 隔离扫描平衡计算——三者构成"成本计算不再碰 lru_lock"的完整链条。
PGROTATE_ANON/FILE vmstat 计数器(前导补丁 2/3 新增);refault 输入用已有的 WORKINGSET_RESTORE_*;页写出输入用 NR_VMSCAN_WRITE,并通过 lruvec_stat_mod_folio() 计到 lruvec 统计里(使它可以按 lruvec 采样、经 memcg 层级聚合)。逻辑点②:reclaim 侧从单调计数器增量推导——每个回收周期在
prepare_scan_control() 里快照一次计数器,用"本次 - 上次"得到 delta,套用同样的成本公式 cost = nr_io * SWAP_CLUSTER_MAX + nr_rotated 累积进 cost[].count,再按 lrusize/4 做衰减。用 lruvec_page_state_monotonic()(前导补丁 1/3 新增)保证 32 位下计数器回绕时无符号减法仍得到正确 delta。逻辑点③:专用
cost_lock——新增 per-lruvec spinlock,只序列化 delta 提取、count 更新和衰减循环,不被 isolate_lru_folios()、move_folios_to_lru()、folio_add_lru() 触碰,与真正的 LRU 操作零交叉。层级聚合隐含在 rstat 传播里,parent_lruvec() 遍历和 lru_reparent_memcg() 成本拼接都随之消失。附带收益(成本模型更准):producer 侧衰减时,reclaim 空闲期间发生的事件会互相老化;新方案观察整个 reclaim 间隙的 delta,按比例衰减 anon/file,让扫描平衡历史更真实反映"上次回收以来发生了什么"。
来源:基于 lore 真实补丁 diff 绘制
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① producer 去锁 | lru_note_cost_unlock_irq() / lru_note_cost_refault() 删除 | 消除 producer 侧 lru_lock 获取(前提) |
| ② 增量推导 | prepare_scan_control() 读单调计数器 delta | 成本计算移到 reclaim 侧(实现) |
| ③ cost_lock | per-lruvec 新增 cost_lock 保护 cost[] | 与 LRU 操作隔离,减少锁交叉(落地) |
🔬 关键代码
按核心逻辑点组织,每点选最能体现的 diff(lore lore_patch 逐字原文):
struct lru_cost 取代裸标量 + 新增 cost_lockdiff --git a/include/linux/mmzone.h b/include/linux/mmzone.h
index aab06fb6c6d5..85303c5867c8 100644
--- a/include/linux/mmzone.h
+++ b/include/linux/mmzone.h
@@ -757,6 +757,12 @@ void lru_gen_reparent_memcg(struct mem_cgroup *memcg, struct mem_cgroup *parent,
#endif /* CONFIG_LRU_GEN */
+struct lru_cost {
+ unsigned long count;
+ unsigned long last_rotated;
+ unsigned long last_io;
+};
+
struct lruvec {
struct list_head lists[NR_LRU_LISTS];
/* per lruvec lru_lock for memcg */
@@ -765,9 +771,12 @@ struct lruvec {
* These track the cost of reclaiming one LRU - file or anon -
* over the other. As the observed cost of reclaiming one LRU
* increases, the reclaim scan balance tips toward the other.
+ * Updated and decayed at prepare_scan_control() time; cost_lock
+ * serialises that update.
*/
- unsigned long anon_cost;
- unsigned long file_cost;
+ struct lru_cost cost[ANON_AND_FILE];
+ /* Protects cost[]. */
+ spinlock_t cost_lock;
/* Non-resident age, driven by LRU movement */
atomic_long_t nonresident_age;
/* Refaults at the time of last reclaim cycle */▲ 为什么这是核心:把两个裸 unsigned long(anon_cost/file_cost)换成 struct lru_cost cost[ANON_AND_FILE]——每侧除累积值 count 外还记住上次采样的 last_rotated/last_io,这是"在 reclaim 侧做增量累积"的数据前提;同时新增 cost_lock 与 lru_lock 分离(v4 起按 Johannes 建议把两组数组折进一个结构体)。
diff --git a/mm/vmscan.c b/mm/vmscan.c
index 053f41584989..0f6334005610 100644
--- a/mm/vmscan.c
+++ b/mm/vmscan.c
@@ -2309,11 +2304,69 @@ static void prepare_scan_control(pg_data_t *pgdat, struct scan_control *sc)

 	/*
 	 * Determine the scan balance between anon and file LRUs.
+	 *
+	 * The cost model is based on rotations, refaults and
+	 * reclaim-driven writes (anon only) on each side.
+	 *
+	 * These event counters are monotonic, so each reclaim cycle
+	 * the delta since the last scan is extracted and incorporated
+	 * into a decaying average. This ensures currency, as workloads
+	 * change over time, and avoids overflow in the calculations.
+	 *
+	 * Use lruvec_page_state_monotonic() so unsigned subtraction
+	 * yields the correct delta across a signed-long wraparound of
+	 * the underlying counter (a real hazard on 32-bit that the
+	 * clamp in lruvec_page_state() would otherwise turn into a huge
+	 * spurious delta).
 	 */
-	spin_lock_irq(&target_lruvec->lru_lock);
-	sc->anon_cost = target_lruvec->anon_cost;
-	sc->file_cost = target_lruvec->file_cost;
-	spin_unlock_irq(&target_lruvec->lru_lock);
+	spin_lock(&target_lruvec->cost_lock);
+
+	for (int f = 0; f <= 1; f++) {
+		struct lru_cost *cost = &target_lruvec->cost[f];
+		unsigned long rotated, io, nr_rotated, nr_io;
+
+		rotated = lruvec_page_state_monotonic(target_lruvec,
+						      PGROTATE_ANON + f);
+		io = lruvec_page_state_monotonic(target_lruvec,
+						 WORKINGSET_RESTORE_BASE + f);
+		if (f == WORKINGSET_ANON)
+			io += lruvec_page_state_monotonic(target_lruvec,
+							  NR_VMSCAN_WRITE);
+
+		nr_rotated = rotated - cost->last_rotated;
+		nr_io = io - cost->last_io;
+
+		/*
+		 * Reflect the relative cost of incurring IO and spending
+		 * CPU time on rotations. This doesn't attempt to make a
+		 * precise comparison, it just says: if reloads are about
+		 * comparable between the LRU lists, or rotations are
+		 * overwhelmingly different between them, adjust scan
+		 * balance for CPU work.
+		 */
+		cost->count += nr_io * SWAP_CLUSTER_MAX + nr_rotated;
+
+		cost->last_rotated = rotated;
+		cost->last_io = io;
+	}
+
+	anon_cost = &target_lruvec->cost[WORKINGSET_ANON];
+	file_cost = &target_lruvec->cost[WORKINGSET_FILE];
+
+	lrusize = lruvec_page_state(target_lruvec, NR_INACTIVE_ANON) +
+		  lruvec_page_state(target_lruvec, NR_ACTIVE_ANON) +
+		  lruvec_page_state(target_lruvec, NR_INACTIVE_FILE) +
+		  lruvec_page_state(target_lruvec, NR_ACTIVE_FILE);
+
+	while (anon_cost->count + file_cost->count > lrusize / 4) {
+		anon_cost->count /= 2;
+		file_cost->count /= 2;
+	}
+
+	sc->anon_cost = anon_cost->count;
+	sc->file_cost = file_cost->count;
+
+	spin_unlock(&target_lruvec->cost_lock);
▲ 为什么这是核心:原来 prepare_scan_control() 要拿 lru_lock 快照两个标量;现在改拿独立的 cost_lock,在锁内读单调计数器(PGROTATE / WORKINGSET_RESTORE / anon 加 NR_VMSCAN_WRITE),用 cost->last_* 求 delta 后按原公式加权累积,再做 lrusize/4 的 while 衰减。关键点:lruvec_page_state_monotonic() 保证 32 位计数器回绕时无符号减法仍正确——这是 v1→v2 由 Johannes 和 sashiko 指出的修复。
diff --git a/mm/vmscan.c b/mm/vmscan.c
index 053f41584989..0f6334005610 100644
--- a/mm/vmscan.c
+++ b/mm/vmscan.c
@@ -2047,9 +2045,6 @@ static unsigned long shrink_inactive_list(unsigned long nr_to_scan,
 		mod_lruvec_state(lruvec, PGROTATE_ANON + file,
 				 nr_scanned - nr_reclaimed);

-	lruvec_lock_irq(lruvec);
-	lru_note_cost_unlock_irq(lruvec, file, stat.nr_pageout,
-					nr_scanned - nr_reclaimed);
 	handle_reclaim_writeback(nr_taken, pgdat, sc, &stat);
 	trace_mm_vmscan_lru_shrink_inactive(pgdat->node_id,
 		nr_scanned, nr_reclaimed, &stat, sc->priority, file);
@@ -2158,8 +2153,6 @@ static void shrink_active_list(unsigned long nr_to_scan,
 	if (nr_rotated)
 		mod_lruvec_state(lruvec, PGROTATE_ANON + file, nr_rotated);

-	lruvec_lock_irq(lruvec);
-	lru_note_cost_unlock_irq(lruvec, file, 0, nr_rotated);
 	trace_mm_vmscan_lru_shrink_active(pgdat->node_id, nr_taken, nr_activate,
 		nr_deactivate, nr_rotated, sc->priority, file);
 }
diff --git a/mm/workingset.c b/mm/workingset.c
index f351798e723a..7ac2b88c80ae 100644
--- a/mm/workingset.c
+++ b/mm/workingset.c
@@ -584,11 +584,6 @@ void workingset_refault(struct folio *folio, void *shadow)
 	/* Folio was active prior to eviction */
 	if (workingset) {
 		folio_set_workingset(folio);
-		/*
-		 * XXX: Move to folio_add_lru() when it supports new vs
-		 * putback
-		 */
-		lru_note_cost_refault(folio);
 		mod_lruvec_state(lruvec, WORKINGSET_RESTORE_BASE + file, nr);
 	}
 out:
diff --git a/mm/swap.c b/mm/swap.c
index 588f50d8f1a8..74b281778cbc 100644
--- a/mm/swap.c
+++ b/mm/swap.c
@@ -272,73 +272,6 @@ void folio_rotate_reclaimable(struct folio *folio)
 	folio_batch_add_and_move(folio, lru_move_tail);
 }

-void lru_note_cost_unlock_irq(struct lruvec *lruvec, bool file,
-		unsigned int nr_io, unsigned int nr_rotated)
-		__releases(lruvec->lru_lock)
-		__releases(rcu)
-{
-	unsigned long cost;
-
-	/*
-	 * Reflect the relative cost of incurring IO and spending CPU
-	 * time on rotations. This doesn't attempt to make a precise
-	 * comparison, it just says: if reloads are about comparable
-	 * between the LRU lists, or rotations are overwhelmingly
-	 * different between them, adjust scan balance for CPU work.
-	 */
-	cost = nr_io * SWAP_CLUSTER_MAX + nr_rotated;
-	if (!cost) {
-		spin_unlock_irq(&lruvec->lru_lock);
-		rcu_read_unlock();
-		return;
-	}
-
-	for (;;) {
-		unsigned long lrusize;
-
-		/* Record cost event */
-		if (file)
-			lruvec->file_cost += cost;
-		else
-			lruvec->anon_cost += cost;
-
-		/*
-		 * Decay previous events
-		 *
-		 * Because workloads change over time (and to avoid
-		 * overflow) we keep these statistics as a floating
-		 * average, which ends up weighing recent refaults
-		 * more than old ones.
-		 */
-		lrusize = lruvec_page_state(lruvec, NR_INACTIVE_ANON) +
-			  lruvec_page_state(lruvec, NR_ACTIVE_ANON) +
-			  lruvec_page_state(lruvec, NR_INACTIVE_FILE) +
-			  lruvec_page_state(lruvec, NR_ACTIVE_FILE);
-
-		if (lruvec->file_cost + lruvec->anon_cost > lrusize / 4) {
-			lruvec->file_cost /= 2;
-			lruvec->anon_cost /= 2;
-		}
-
-		spin_unlock_irq(&lruvec->lru_lock);
-		lruvec = parent_lruvec(lruvec);
-		if (!lruvec) {
-			rcu_read_unlock();
-			break;
-		}
-		spin_lock_irq(&lruvec->lru_lock);
-	}
-}
-
-void lru_note_cost_refault(struct folio *folio)
-{
-	struct lruvec *lruvec;
-
-	lruvec = folio_lruvec_lock_irq(folio);
-	lru_note_cost_unlock_irq(lruvec, folio_is_file_lru(folio),
-				folio_nr_pages(folio), 0);
-}
-
 static void lru_activate(struct lruvec *lruvec, struct folio *folio)
▲ 为什么这是核心:三处 lru_note_cost_* 调用删除,对应的 lruvec_lock_irq() 获取也随之消失(swap.c 里约 69 行整体删除)。producer 侧不再为记账碰锁——这正是 perf lock 里 shrink_lruvec+0x770(= lru_note_cost_unlock_irq)和 workingset_refault+0x167(= lru_note_cost_refault)被完全消除的代码依据。
diff --git a/mm/vmscan.c b/mm/vmscan.c
index 053f41584989..0f6334005610 100644
--- a/mm/vmscan.c
+++ b/mm/vmscan.c
@@ -641,7 +641,7 @@ static pageout_t writeout(struct folio *folio, struct address_space *mapping,
 		folio_clear_reclaim(folio);

 	trace_mm_vmscan_write_folio(folio);
-	node_stat_add_folio(folio, NR_VMSCAN_WRITE);
+	lruvec_stat_mod_folio(folio, NR_VMSCAN_WRITE, folio_nr_pages(folio));
 	return PAGE_SUCCESS;
 }
@@ -1418,8 +1418,6 @@ static unsigned int shrink_folio_list(struct list_head *folio_list,
 					sc->nr_scanned -= (nr_pages - 1);
 					nr_pages = 1;
 				}
-				stat->nr_pageout += nr_pages;
-
 				if (folio_test_writeback(folio))
 					goto keep;
 				if (folio_test_dirty(folio))
▲ 为什么这是核心:NR_VMSCAN_WRITE 从 node 级统计改为 lruvec/memcg 统计,使 writeout 事件能被 per-lruvec 采样并经 rstat 聚合(v2 起按 Johannes 建议复用现有计数器而非新增);reclaim_stat.nr_pageout 随之废弃(v3 移除)。
📈 性能影响
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| usemem swap-out/refault(连续 shrink_inactive_list + workingset_refault) | 176 核 / 256 GB 主机,两层 memcg(叶节点 memory.max=512M),16 GB swap,30s `perf lock record -a` 窗口 | Total LRU lock wait ≈ 4.23 s | ≈ 1.66 s(-61%) |
说明:作者自报,未独立验证(cover letter 数据,附可复现脚本)。工作量速率两内核一致(pgscan_direct/s 172,662→171,817、pgsteal_direct/s 67,162→66,306、workingset_refault_anon/s 40,696→39,830,均 ~0%),确认是纯锁开销下降而非压力变化。perf lock contention 明细(30 s 总等待):
| Lock Name | Before | After | 变化 |
|---|---|---|---|
| shrink_lruvec+0x770(= lru_note_cost_unlock_irq) | 722.84 ms | 0 | -100%(eliminated) |
| workingset_refault+0x167(= lru_note_cost_refault) | 385.26 ms | 0 | -100%(eliminated) |
| shrink_node+0x4ad | 689.43 ms | 26.95 ms | -96% |
| shrink_active_list | 208.34 ms | 15.97 ms | -92% |
| lru_add_drain_cpu+0x34 | 1.96 s | 917.71 ms | -53% |
| Total LRU lock wait | ≈ 4.23 s | ≈ 1.66 s | -61% |
on-CPU vs off-CPU 视角:本补丁收益主要在 off-CPU——减少 lru_lock 等待(锁等待是 wall-clock 里 CPU 不在算的部分);同时也有 on-CPU 收益——省掉 producer 侧锁获取/释放、parent_lruvec 遍历和 rstat 前的累加指令。剩余 ~1.66 s 等待由 per-CPU pagevec drain(lru_add_drain_cpu)和 shrink_lruvec 主路径主导(cover letter 原文)。数据出处:cover letter「== Numbers ==」节,作者自报,未独立验证。
🔄 方案演进
RFC → v5 共 6 版,演进由 Johannes Weiner(hannes)、Shakeel Butt、sashiko 的 review 驱动(cover letter changelog 原文,链接均为 lore 归档):
v1(2026-07-06):文档化"read-side 累积器改善 reclaim 间隙成本老化"(Johannes);用 while 循环把 cost_accum 完全衰减到 lrusize/4 以下(sashiko)。
v2(2026-07-13):引入
_monotonic vmstat 读取器修复 32 位 delta 下溢(Johannes 和 sashiko);系列拆成 2 个补丁。v3(2026-07-17):复用
NR_VMSCAN_WRITE 作为 anon pageout 成本(替代新增 PGRECLAIM_PAGEOUT_*,Johannes);NR_VMSCAN_WRITE 走 lruvec/memcg 统计并移除 nr_pageout 管道;MGLRU eviction 路径也计 PGROTATE_*(sashiko)。v4(2026-07-20):把两组 per-lruvec 数组折成
struct lru_cost { count, last_rotated, last_io };分开采样 rotated/io 先算原始 delta 再加权(便于推理溢出);halving 循环去掉 per-side 检查只留 sum 检查;精简注释(均 Johannes)。v5(2026-07-27,当前):代码与 v4 相同;把最后一个 patch 拆成独立补丁(PGROTATE 定义/记账独立成 patch 并文档化其诊断价值,Shakeel),commit message 更短更干净(Johannes & Shakeel)。
Acked-by。sashiko 32 位溢出质疑 + 作者回应(20260729130241.3327679-1-usama.arif@linux.dev,2026-07-29):
- 质疑 1:
nr_io * SWAP_CLUSTER_MAX在 32 位下可能溢出(nr_io是跨 reclaim 间隙的大 delta)。作者回应:ULONG_MAX / SWAP_CLUSTER_MAX = 2^32/32 ≈ 134 M页事件才会回绕;32 位可寻址 RAM 上限 ~4 GiB(约 1 M 页)/PAE ~64 GiB(约 16 M 页),意味着需 ~130 次 4 GiB LRU 完全换出再 refault 且中间无一次prepare_scan_control(),实际不可能。 - 质疑 2:溢出成小值是否会跳过
lrusize/4衰减循环。作者回应:同样受上一条"~134 M 事件 + 无中间扫描"前提限制,可安全忽略。
Acked-by: Johannes Weiner <hannes@cmpxchg.org>(本补丁已附);并在 v1/v2/v3 多次主导设计简化(复用计数器、结构体折叠、增量计算、注释精简)。
⚠️ 风险与局限
per-lruvec 内存开销:每个 lruvec 增加 4 个 unsigned long + 1 个 spinlock(
struct lru_cost 每侧 3 个 unsigned long × 2 + cost_lock),cover letter 承认是小开销。memcg 统计路径新成本:
NR_VMSCAN_WRITE 现在还要更新 folio 的 lruvec/memcg 统计,给回收写回路径新增一次 memcg stat 记账(保留 node 级总数)。失败模式:若某 lruvec 在长时间内无
prepare_scan_control(),计数器 delta 会很大——作者用"32 位可寻址 RAM 物理上限"论证不可能溢(见讨论焦点),但该论证依赖回收周期必然发生(解读(AI 分析))。MGLRU 边界:纯 MGLRU 下该信号本身不被消费(prepare_scan_control/get_scan_count 被短路,MGLRU 用 lrugen 自己的 avg_refaulted/refaulted),PGROTATE/NR_VMSCAN_WRITE 仅保持计数有意义。
🔗 交叉引用
lruvec_page_state_monotonic(),是本补丁 32 位安全采样的前提PATCH v5 2/3 · mm/vmscan: add pgrotate_anon and pgrotate_file vmstat counters — 前导补丁,新增 PGROTATE_* 计数器,是本补丁 rotation 输入来源
PATCH v5 0/3 cover letter — 系列动机 / 性能数据 / 演进 / review 来源
复现脚本 gist — cover letter 引用的 perf lock 复现脚本(作者提供)
✅ 关键洞察
- 发现:把"扫描平衡成本记账"从每个回收生产者的 lru_lock 临界区,改为回收周期一次性从 vmstat 单调计数器增量推导,是消除 lru_lock 无谓争用的关键——producer 侧 5 个获取点全部消失,memcg 层级 parent_lruvec 遍历与成本拼接也被 rstat 聚合替代。
- 证据:176 核/256 GB 主机 perf lock 实测 Total LRU lock wait 4.23 s → 1.66 s(-61%),两个记账点 shrink_lruvec+0x770 与 workingset_refault+0x167 完全消除(-100%);工作量速率两内核一致。数据作者自报,未独立验证。
- 边界:收益依赖"内存压力 + 多核并发回收 + 高 refault"场景;纯 MGLRU 路径不消费该信号;无内存压力时近 no-op;32 位溢出经作者以物理内存上限论证可忽略。
- 风险 / 建议:rstat 聚合滞后、per-lruvec 内存 +5 字、NR_VMSCAN_WRITE 新增 memcg 记账开销是待观察点;已获 Johannes Weiner 与 Shakeel Butt 双 Ack,仍 In Review(v5)未合入,建议关注合入前是否还有针对扫描平衡行为变化的进一步验证。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。