x86/kcfi: Optimize call sequence
💡 一句话总结
在内核开启 Clang kCFI(控制流完整性)后,每次间接调用前都要插入一段"哈希校验 + 非法时陷阱"的检查序列;旧序列在合法调用(绝大多数)时走一条恒跳转(taken)的 je 分支,而现代 CPU 对 taken 分支的吞吐低于 not-taken 分支。补丁在启动时用 text_poke 把这段改写为"合法时不跳转"的 jne + 内嵌 UDB(0xd6)陷阱的等价序列,把热路径分支从"恒 taken"翻转为"恒 not-taken",同时保持失配时仍触发 #UD 陷阱、CFI 语义完全不变。补丁提供 Intel Scott Constable 的间接分支 miss 率 PoC 数据(作者自报,未独立验证):BHI_DIS_S=1 下 lmbench syscall 间接分支 miss 率从 0.016990 降至 0.005852(-65.6%),redis 从 0.045540 降至 0.027946(-38.6%);BHI_DIS_S=0 下 redis 从 0.017073 降至 0.000184(-98.9%)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(性能 · 热路径减分支开销) |
| 性能类别 | 热路径(间接调用检查序列的指令级优化,不改变 CFI 语义) |
| 状态 | Merged(tip 树 x86/core 分支,commit b2250d63e642,2026-07-30;截至 Linux 7.2-rc6 未合入 mainline) |
| 当前版本 | 合并版(tip-bot2 推送)· tip-bot2 推送链接 |
| 版本演进 | v1(2026-06-12,+16/-1)→ Merged(2026-07-30,+29/-3) |
| 作者机构 | Peter Zijlstra(Intel);Suggested-by: Scott D Constable(Intel) |
| 提交日期 | AuthorDate 2026-06-11;CommitterDate 2026-07-30 |
| 改动范围 | arch/x86/kernel/alternative.c + arch/x86/kernel/cfi.c,+29/-3 行,2 文件 |
| 核心函数 | cfi_enable_callers() / handle_cfi_failure() / decode_cfi_insn() |
| 原始链接 | lore Message-ID(tip-bot2);commit b2250d63e642228911db80238f7e437dc405cc63 |
📊 速览卡片
🎯 解决什么问题
本补丁的动机来自 Peter Zijlstra 自己早先合入的 commit
85a2d4a890dc("x86,ibt: Use UDB instead of 0xEA")里的一项观察:Jcc(条件跳转)应该被预设为 not-taken(Agner Fog 优化手册原话:not-taken 分支在大多数处理器上吞吐更高),但标准 kCFI ABI 生成的调用点校验序列恰恰在合法路径上走了一条恒 taken 的 je 跳转。这个"热路径分支方向选反了"的问题就是本补丁要解决的。
CONFIG_CFI 的内核中编译出来)→ 调用点先执行 kCFI 校验序列 → 通过后 cs call __x86_indirect_thunk_r11 真正跳转。机制缺陷:编译器生成的 ABI 标准序列(配合
-mretpoline-external-thunk)是:movl $(-hash),%r10d(6B)→ addl -15(%r11),%r10d(4B)→ je 1f(2B,哈希相等则跳)→ ud2(2B,失配陷阱)→ 1: cs call ...。这里
addl 把"期望哈希的相反数"与"目标函数前导的哈希"相加,相等则 ZF=1,je 跳转成立——而合法调用时哈希总是相等的,所以这条 je 在正常路径上每次都 taken。Agner Fog 手册明确指出 taken 分支吞吐低于 not-taken,Intel 也推荐 FineIBT 的序列(其调用点分支设计为 not-taken)。旧平台(不支持 IBT、仍走 kCFI)广泛使用,就一直背着这个可避免的开销。
为什么遇到缺陷:校验序列里的
je 在合法路径恒 taken,而 taken 分支会打破指令预取/分支预测的"顺流"假设,每次间接调用都付出比必要更高的吞吐代价。负载越"间接调用密集",放大越明显。注意:这是 on-CPU 收益(减少分支执行开销),不涉及锁/等待等 off-CPU 因素。
🧩 核心机制
核心逻辑点(框架 B 识别):① 把校验序列的 je+ud2 改为 jne+内嵌 UDB 的 test 指令 ② 适配 CFI 失败处理器的陷阱定位偏移——①是"翻转分支方向"的手段,②是让新的陷阱形态仍能被 handle_cfi_failure() 正确识别。
arch/x86/kernel/alternative.c)——在 cfi_enable_callers() 里,对所有带哈希的调用点,除了原有的 text_poke_early(addr, mov, 2) 恢复 movl 指令外,新增 text_poke_early(addr + 10, udne, 4) 把偏移 +10 处的 4 字节从 je 1f; ud2 改写为 {0x75, 0x01, 0xa8, 0xd6}。字节级拆解:
0x75 0x01 = jne . + 3(rel8 短跳,跳向"当前指令起点 +3");0xa8 0xd6 = test $0xd6, %al。关键技巧:jne . + 3 跳转的目标正好落在 test 指令的立即数字节 0xd6 上——0xd6 是 UDB(Undefined Byte),是 Peter Anvin 推动 Intel/AMD 认可的"合法保留单字节未定义指令",单独执行会触发 #UD。于是:· 合法路径:哈希相等 → ZF=1 →
jne 不跳转 → 顺序执行 test $0xd6, %al(无害,只改 flags)→ 落到 cs call。热路径分支变成 not-taken。· 失配路径:哈希不等 → ZF=0 →
jne 跳到 0xd6 → UDB 触发 #UD → 进入 CFI 失败处理。语义与旧的 ud2 完全等价。为什么能支撑性能提升:指令数量与字节数不变(仍是 14 字节),唯一的改变是热路径分支的方向从 taken 翻转为 not-taken,这正是 Agner Fog/Intel 优化指引所推荐的形态。
逻辑点②:CFI 失败处理器偏移适配(
arch/x86/kernel/cfi.c)——旧序列陷阱在 ud2(2 字节 0f 0b),新序列陷阱在 test 立即数 0xd6(1 字节),即 #UD 触发点相对旧位置偏移了 1 字节。合并版改为先判断 is_cfi_trap(addr),若当前地址不是陷阱再 addr -= 1 后重判——这样既能识别新序列(偏移 +1 的陷阱),又不破坏旧序列/其他模式下"陷阱恰好在记录位置"的情况。
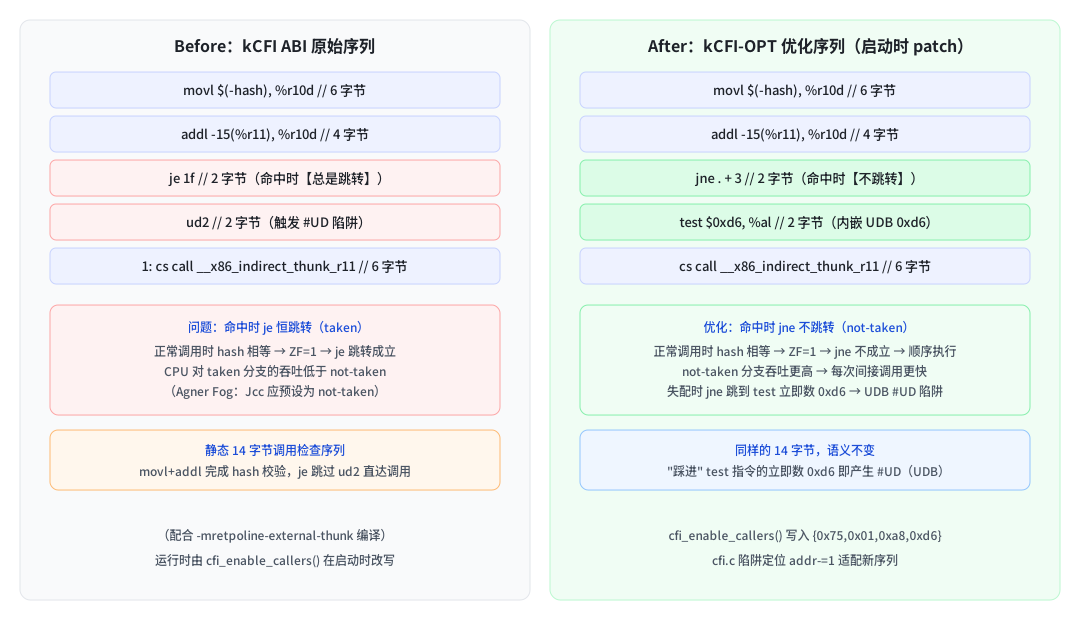
je 恒跳转(taken,吞吐低),陷阱用独立的 ud2;右边优化序列合法路径 jne 不跳转(not-taken,吞吐高),陷阱改用 test $0xd6, %al 指令内嵌的 UDB(0xd6)字节,字节数不变、CFI 语义等价。来源:基于 lore 真实补丁 diff(tip-bot2 推送)绘制
| 逻辑点 | 操作 | 目的 |
|---|---|---|
| ① 分支翻转 | text_poke_early(addr+10, {0x75,0x01,0xa8,0xd6}, 4) | 合法路径 je 恒 taken → jne 恒 not-taken,提升分支吞吐 |
| ① UDB 内嵌 | jne . + 3 跳到 test $0xd6,%al 的立即数 0xd6 | 失配仍触发 #UD 陷阱,CFI 语义不变、字节数不变 |
| ② 陷阱偏移 | if (!is_cfi_trap(addr)) { addr -= 1; ... } | 适配新序列陷阱位置 +1 的偏移,失败处理仍能定位到陷阱 |
🔬 关键代码
按核心逻辑点组织,diff 逐字来自 tip-bot2 推送(合并版 commit b2250d63e642):
diff --git a/arch/x86/kernel/alternative.c b/arch/x86/kernel/alternative.c
index 62936a3..ba7d205 100644
--- a/arch/x86/kernel/alternative.c
+++ b/arch/x86/kernel/alternative.c
@@ -1356,6 +1356,20 @@ early_param("cfi", cfi_parse_cmdline);
  *  "Make conditional jumps most often not taken: The efficiency and throughput
  *   for not-taken branches is better than for taken branches on most
  *   processors. Therefore, it is good to place the most frequent branch first"
+ *
+ * NOTE: Update the kCFI caller sequence to make use of this observation:
+ *
+ * kCFI					kCFI-OPT
+ *
+ * caller:				caller:
+ *	movl	$(-0x12345678),%r10d	 // 6	     movl	$(-0x12345678),%r10d	 // 6
+ *	addl	$-15(%r11),%r10d	 // 4	     addl	$-15(%r11),%r10d	 // 4
+ *	je	1f			 // 2	     jne	. + 3                    // 2
+ *	ud2				 // 2        test	$0xd6, %al		 // 2
+ * 1:	cs call	__x86_indirect_thunk_r11 // 6	1:   cs call	__x86_indirect_thunk_r11 // 6
+ *
+ * This new test clobbers eflags, but those are clobbered by the hash test
+ * anyway.
  */

 /*
@@ -1518,8 +1532,9 @@ static int cfi_disable_callers(s32 *start, s32 *end)
 static int cfi_enable_callers(s32 *start, s32 *end)
 {
 	/*
-	 * Re-enable kCFI, undo what cfi_disable_callers() did.
+	 * Re-enable (and update) kCFI, undo what cfi_disable_callers() did.
 	 */
+	const u8 udne[] = { 0x75, 0x01, 0xa8, 0xd6 };
 	const u8 mov[] = { 0x41, 0xba };
 	s32 *s;

@@ -1532,6 +1547,10 @@ static int cfi_enable_callers(s32 *start, s32 *end)
 		if (!hash) /* nocfi callers */
 			continue;

+		/*
+		 * See the kCFI/FineIBT comment above -- update note.
+		 */
+		text_poke_early(addr + 10, udne, 4);
 		text_poke_early(addr, mov, 2);
 	}
▲ 为什么这么改:注释块里并排给出新旧序列的字节布局(v1 里没有这个对比注释,是合入版补充的——回应了 David Laight 的 review 建议)。核心一行:text_poke_early(addr + 10, udne, 4)——调用点偏移 +10 处正是 je 1f; ud2 的 4 字节,被替换为 jne . + 3; test $0xd6, %al。新增 udne 数组名取 "UD"(陷阱)+ "ne"(jne 不跳转)之意,语义一目了然。
diff --git a/arch/x86/kernel/cfi.c b/arch/x86/kernel/cfi.c
index 638eb5c..1df26df 100644
--- a/arch/x86/kernel/cfi.c
+++ b/arch/x86/kernel/cfi.c
@@ -72,8 +72,15 @@ enum bug_trap_type handle_cfi_failure(struct pt_regs *regs)

 	switch (cfi_mode) {
 	case CFI_KCFI:
-		if (!is_cfi_trap(addr))
-			return BUG_TRAP_TYPE_NONE;
+		if (!is_cfi_trap(addr)) {
+			/*
+			 * The updated kCFI sequence has "test $0xd6, %al" instead of
+			 * "ud2", adjust the offset.
+			 */
+			addr -= 1;
+			if (!is_cfi_trap(addr))
+				return BUG_TRAP_TYPE_NONE;
+		}

 		if (!decode_cfi_insn(regs, &target, &type))
 			return report_cfi_failure_noaddr(regs, addr);
▲ 为什么这么改:旧序列陷阱是独立的 ud2(2 字节,0f 0b),#UD 的 regs->ip 直接指向记录在 __kcfi_traps 段的陷阱地址;新序列陷阱是 test $0xd6,%al 的立即数字节 0xd6,触发点相对旧位置偏移 1 字节。关键一行:addr -= 1 把 regs->ip 回退 1 字节,使 is_cfi_trap() 能命中记录的陷阱地址。注意 v1 里是无条件 addr -= 1,合并版改为先判、不行再减,更稳健(避免把旧序列/其他陷阱形态误判)。
📈 性能影响
| 场景/用例 | 运行环境 | 指标 | kCFI(旧) | kCFI-OPT(新) |
|---|---|---|---|---|
| lmbench syscall(BHI_DIS_S=1) | Intel,BHI 缓解开启(commit message PoC) | 间接分支 miss 率(越低越好) | 0.016990 | 0.005852(-65.6%) |
| redis(BHI_DIS_S=1) | 同上 | 间接分支 miss 率 | 0.045540 | 0.027946(-38.6%) |
| nginx+wrk(BHI_DIS_S=1) | 同上 | 间接分支 miss 率 | 0.132557 | 0.102417(-22.7%) |
| kbuild(BHI_DIS_S=1) | 同上 | 间接分支 miss 率 | 0.064640 | 0.048136(-25.5%) |
| redis(BHI_DIS_S=0) | Intel,BHI 缓解关闭(commit message PoC) | 间接分支 miss 率 | 0.017073 | 0.000184(-98.9%) |
| nginx+wrk(BHI_DIS_S=0) | 同上 | 间接分支 miss 率 | 0.033637 | 0.000268(-99.2%) |
| fio randread(BHI_DIS_S=0) | 同上 | 间接分支 miss 率 | 0.007096 | 0.000143(-98.0%) |
说明:数据来源为 commit message 中 Scott Constable 早期 PoC 基准(作者自报,未独立验证)。指标是"间接分支 miss 率"(br_misp_retired.indirect:k / br_inst_retired.indirect:k),越低越好,反映的是间接跳转预测失效率而非端到端吞吐;commit message 同时给出 BHI_DIS_S=1 与 =0 两组、共 20 个用例(iperf3/hackbench/lmbench/redis/nginx/fio/kbuild),此处摘录代表性几行,完整表见 tip-bot2 推送。
on-CPU vs off-CPU 视角:本补丁优化的是 on-CPU 环节——减少"每次间接调用校验序列中 taken 分支"带来的执行/预取开销,属于 CPU 指令执行吞吐,不涉及锁/等待/唤醒等 off-CPU 因素。补丁未提供端到端延迟/吞吐基准,间接分支 miss 率下降与端到端收益的换算需要额外测量(解读(AI 分析));从路径推断,间接调用密集的工作负载(网络、存储、驱动回调)收益最明显。
🔄 方案演进
本补丁从 v1 到合并版(tip x86/core)的演进(基于 lore 真实消息):
cfi_enable_callers() 写入 {0x75,0x01,0xa8,0xd6},cfi.c 在 CFI_KCFI 分支做 addr -= 1 偏移修正。Merged(2026-07-30,+29/-3):合入 tip x86/core。相对 v1 的变化:① alternative.c 注释块补充了新旧序列字节对比图(回应 review 建议 1);② cfi.c 的
addr -= 1 从无条件改为"先判 is_cfi_trap(addr)、不行再 addr -= 1"(更稳健,回应"检查改写内容"的 review 精神)。
David Laight:3 条 review 建议(20260616214722.7742e394@pumpkin):
① "I think it would be better to give the byte sequences for both pairs of instructions - it takes a bit of sleuthing to check they are the same size."——建议给出新旧两对指令的字节序列,便于核对字节数一致。→ 合并版注释块加了并排字节对比,已回应。
② "I think it would also be better if the code doing the patching checked what it was overwriting."——建议 patching 代码校验被覆盖的原内容。→ 合并版
cfi.c 改成"先判陷阱、再回退 1 字节",比 v1 无条件 addr -= 1 更谨慎,方向回应。③ "Also, what actually generates the list of cfi locations in the first place? If it is objtool, then maybe it could do the rewrite instead."——询问 CFI 位置列表由谁生成、能否由 objtool 直接改写。
Nathan Chancellor:Tested-by(合并版 commit message 收录;讨论见 20260617223728.GA3913972@ax162)。
注:David Laight 的三条建议原文引自其 review 邮件正文;Peter Zijlstra 的回复存在于同线程(多封,见 lore 线程),未逐字摘录。
⚠️ 风险与局限
test 立即数里,handle_cfi_failure() 依赖 addr -= 1 的精确偏移才能命中 __kcfi_traps 记录。若未来其他代码路径(如 kprobes、objtool、模块加载时的 CFI 处理,见 arch/x86/kernel/kprobes/core.c、kernel/cfi.c 的 module_cfi_finalize)对新序列的陷阱位置假设不一致,可能误判。合并版"先判再减"降低了误判面。兼容性边界:补丁只在
CFI_KCFI 模式下生效(FineIBT 走独立路径);且改写发生在启动早期 cfi_enable_callers()(此时指令段尚可写)。若某平台/配置下 cfi_disable_callers() 先被调用(BHI 缓解切换),cfi_enable_callers() 的 udne 覆盖仍基于 addr + 10 的固定偏移——若编译出的 kCFI 调用点字节布局与预期不符(如非 -mretpoline-external-thunk 构建),偏移假设可能被打破(解读(AI 分析):实际上 kCFI ABI 固定,风险低)。性能数据未独立验证:commit message 的间接分支 miss 率是 Scott 的早期 PoC(作者自报,未独立验证),且是 miss 率而非端到端吞吐;实际收益需合入后独立复测。
多核扩展性:本改动是单点指令改写,无锁、无共享状态,不引入串行化;扩展性与 kCFI 调用频率正相关(解读(AI 分析))。
🔗 交叉引用
David Laight review — 3 条建议(字节序列对照 / 校验覆盖内容 / objtool 改写)
Borislav Petkov Acked-by — x86 维护者 Ack
x86,ibt: Use UDB instead of 0xEA — 本补丁的机制来源:把 FineIBT 的 #UD 从保留指令 0xEA 改为受认可的 UDB(0xd6),并确立"Jcc 应预设 not-taken"原则(Peter Zijlstra,2025-09)
合并 commit b2250d63e642(tip x86/core) — 2026-07-30 合入 tip 树
✅ 关键洞察
- 发现:kCFI 间接调用校验序列在合法路径上走了一条"恒 taken"的
je分支,违背现代 CPU"not-taken 分支吞吐更高"的原则;补丁用"jne+ 内嵌 UDB(0xd6)陷阱"翻转分支方向,字节数与 CFI 语义完全不变 - 证据:Intel Scott 的 PoC(作者自报,未独立验证)——BHI_DIS_S=1 下 lmbench syscall 间接分支 miss 率 -65.6%、redis -38.6%;BHI_DIS_S=0 下 redis -98.9%、nginx+wrk -99.2%;20 个用例全部下降
- 边界:仅
CFI_KCFI模式受益(FineIBT 走独立路径);陷阱识别依赖addr -= 1的精确偏移;启动早期一次性text_poke改写,无运行期开销 - 风险 / 建议:性能数据为 miss 率且未独立验证,建议合入后补端到端基准;建议各消费 CFI 陷阱的路径(kprobes/模块 CFI 处理)与新的偏移假设保持一致;x86 维护者已 Ack,无未决反对
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。