lib/raid/xor: x86: Add AVX-512 optimized xor_gen()
💡 一句话总结
在 RAID5/6 写路径的 P 校验生成场景下,内核通用的 XOR 校验函数 xor_gen() 此前在 x86 上只能选用 256 位 AVX 实现,异或指令也仅支持两输入、多盘校验需拆成多条依赖链;本补丁新增 AVX-512 实现,用 512 位 ZMM 寄存器一次搬移 64 字节、用 vpternlogq 把「dest ⊕ src1 ⊕ src2」的三输入异或压成一条指令,并把循环控制压到每迭代两条指令,从而让校验生成吞吐在 AMD Ryzen 9 9950X 上相对 AVX 提升 26%~43%(作者自报,未独立验证)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(performance,RAID XOR 校验吞吐) |
| 状态 | In Review —— 截至 2026-08-04 未合入主线(本地 linux 树 7.2-rc6 尚无 lib/raid/xor/x86/xor-avx512.c) |
| 当前版本 | v2 · 本补丁链接(系列 cover letter) |
| 版本演进 | 独立 v1(06-12)→ 独立 v2(06-14)→ 独立 v3(06-15)→ 并入 8 补丁系列 v1 8/8(06-26)→ v2 8/8(07-28,本文档分析对象) |
| 作者机构 | Eric Biggers(ebiggers@kernel.org,Google) |
| 提交日期 | 2026-07-28(v2) |
| 改动范围 | lib/raid/xor/Makefile、lib/raid/xor/x86/xor-avx512.c(新增,121 行)、lib/raid/xor/x86/xor_arch.h,共 3 文件 +142/-11 行 |
| 核心函数 | xor_gen_avx512() / xor_avx512_2..5() / arch_xor_init() |
| 原始链接 | lore Message-ID: 20260728021603.79870-9-ebiggers@kernel.org |
📊 速览卡片
🎯 解决什么问题
xor_gen(dest, srcs, src_cnt, bytes)(crypto/async_tx/async_xor.c 供 md/raid5 调用,fs/btrfs/raid56.c 直接调用)。内核为它准备了一批 SIMD 模板(MMX/SSE/AVX),启动时 arch_xor_init() 选最快的一个并跳过校准。本补丁作者在 cover letter 里说明:为 x86 加 AVX-512 版 xor_gen() 的计划「此前一直卡在 cpu_has_xfeatures() 的混乱及其在 UML 上没有实现」上——所以本补丁属于一个更大的 8 补丁系列,先由系列前 7 个补丁把「OS/虚拟机是否开启 XCR0 里的 AVX/AVX-512 xstate 位」的检查统一到启动时一处,本补丁才得以安全启用 AVX-512 路径。
lib/raid/xor/x86/xor-avx.c 用 256 位 YMM 寄存器(每条指令 32 字节),且其 vxorps 是两输入异或——对 3 个以上缓冲的 XOR(RAID5 常见 4~5 盘 = 3~4 个数据盘 + dest),每 64 字节要拆成 2 条 32 字节载入 + 2 条两输入异或,指令多、依赖链长;循环还要显式推进指针。对于纯计算密度极高的校验路径,这就是吞吐天花板。
async_xor / xor_gen 逐块异或生成 P(RAID6 再对 Q 做伽罗华域乘法后异或)→ 写盘。这是每笔写都跑一遍的每-CPU 热路径,条带越宽(磁盘数越多)、写入越连续,异或字节数越多。为什么该场景遇到瓶颈:校验是纯 CPU 吞吐型计算,数据驻留内存、可流式预取,恰恰是「更宽 SIMD 位宽 + 更少指令」能直接兑换成 MB/s 的场景;而 256 位 AVX 的指令数/依赖链已是相对短板。
🧩 核心机制
在原有「MMX/SSE/AVX」模板之外新增 xor_block_avx512 模板,并在启动时优先选择:只要 CPU 同时具备 AVX512F 且 !PREFER_YMM,就直接 xor_force() 锁定 AVX-512 实现(跳过校准)。核心收益来自三件事:512 位 ZMM(每指令 64 字节)、vpternlogq 三输入异或(一条指令算 dest⊕a⊕b)、负索引寄存器寻址(每迭代仅 2 条循环控制指令)。
lib/raid/xor/x86/ 下的 Makefile(把 xor-avx512.o 编入 x86_64)、新增 xor-avx512.c、改 xor_arch.h 的启动选择逻辑。为什么要这么改:md/raid5 等调用方只认 static_call(xor_gen_impl) 这个入口,模板内部换实现对调用方完全透明——所以在「选择最快模板」这一处加一个分支即可,不动任何调用路径。解决了什么技术问题:把 RAID 校验生成从 256 位推到 512 位宽度,并用三输入异或砍掉依赖链。为什么支撑场景提升:写路径上每笔写要异或的字节数是固定的,每字节所需指令数下降 → 同周期内完成更多字节 → 吞吐提升。选择策略的关键细节(!PREFER_YMM):AVX-512 不是无脑最好。Intel Skylake-SP、Ice Lake 的 AVX-512(尤其 ZMM)会触发「过激降频」,用 512 位反而更慢;所以作者沿用 crypto/CRC 代码的同一策略,用
!PREFER_YMM 排除这些 CPU,只在 AMD Zen4+、Intel Sapphire Rapids+/Rocket Lake/Nova Lake+ 上启用。这是本补丁「为什么能安全生效」的关键。
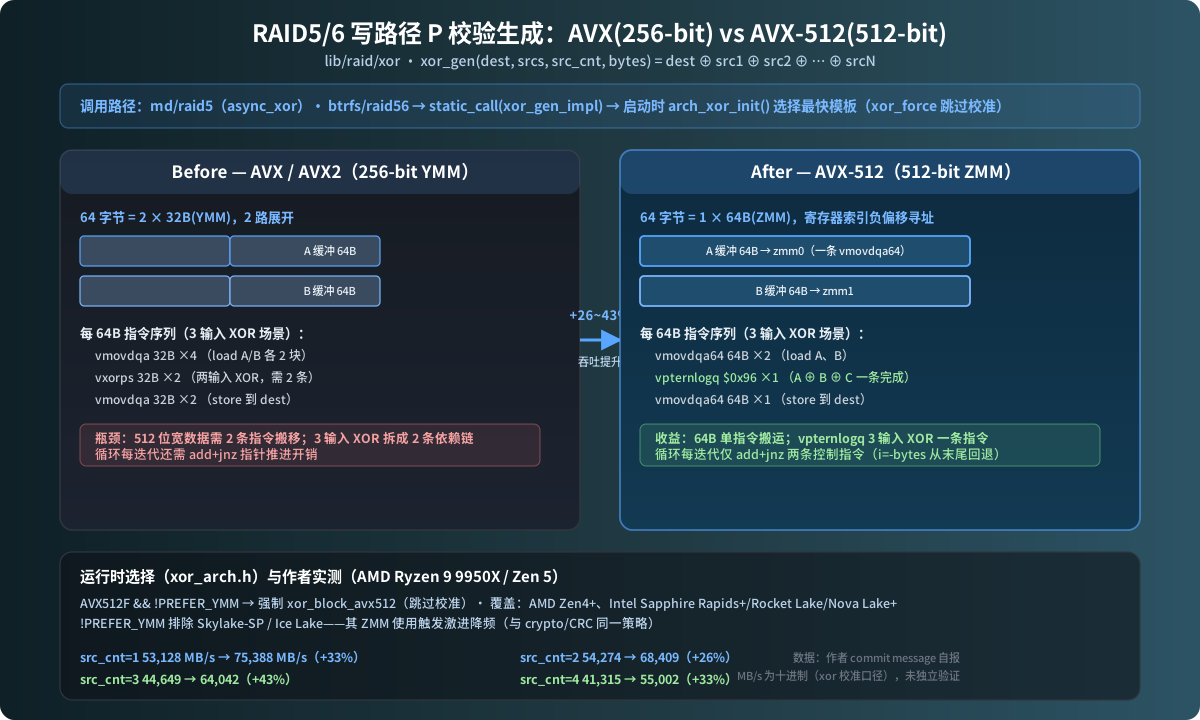
来源:基于 lore 真实补丁 diff(v2 8/8)与作者 commit message 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 启动选择 | arch_xor_init(): AVX512F && !PREFER_YMM → xor_force(&xor_block_avx512) | 在具备无降频 AVX-512 的 CPU 上直接锁定新实现,跳过校准(该 CPU 上 AVX-512 必不差于 AVX) |
| 模板分发 | DO_XOR_BLOCKS(avx512_inner, _2, _3, _4, _5) | 按源缓冲数 2~5 分派到专用内层循环(按缓冲数展开最重要) |
| 宽度翻倍 | vmovdqa64 zmm(64B)/ vpxorq | 512 位 ZMM 每指令搬运/异或 64 字节,比 YMM 翻倍 |
| 三输入异或 | vpternlogq $0x96 | 一条指令完成 dest⊕src1⊕src2(3 输入),砍掉一条两输入 XOR 及其依赖链 |
| 循环控制 | i = -bytes; add $64/$128; jnz | 负索引寄存器寻址,每迭代仅 2 条控制指令、无指针推进 |
🔬 关键代码
diff 逐字来自 lore(v2 8/8)。按核心逻辑点组织:① 新文件里的 512 位内层循环 + 三输入异或;② arch_xor_init() 的 AVX-512 选择分支。
diff --git a/lib/raid/xor/x86/xor-avx512.c b/lib/raid/xor/x86/xor-avx512.c
new file mode 100644
index 0000000000000..17f57900d8274
--- /dev/null
+++ b/lib/raid/xor/x86/xor-avx512.c
@@ -0,0 +1,121 @@
+// SPDX-License-Identifier: GPL-2.0-or-later
+/*
+ * AVX-512 optimized implementation of xor_gen()
+ *
+ * Copyright 2026 Google LLC
+ */
+
+#include <linux/types.h>
+#include <asm/fpu/api.h>
+#include "xor_impl.h"
+#include "xor_arch.h"
+
+/*
+ * Implementation notes:
+ *
+ * Unrolling by the number of buffers (2-5) is very important.
+ *
+ * Unrolling by length is less important, especially when using register-indexed
+ * addressing with negative indices from the end of the buffers.  That approach
+ * results in just two loop control instructions being needed per iteration,
+ * regardless of the number of buffers.
+ *
+ * In fact, benchmarks showed that the 2 and 3 buffer cases require only 2x
+ * unrolling by length, while the 4 and 5 buffer cases don't require any
+ * unrolling by length.  Benchmarks also showed that the register-indexed
+ * addressing isn't a bottleneck either; i.e., we can't do any better by
+ * incrementing the pointers as we go along, even with more unrolling.
+ */
+
+static void xor_avx512_2(long bytes, u8 *p1, const u8 *p2)
+{
+	long i = -bytes;
+
+	asm volatile("1: vmovdqa64 (%1,%0), %%zmm0\n"
+		     "vmovdqa64 64(%1,%0), %%zmm1\n"
+		     "vpxorq (%2,%0), %%zmm0, %%zmm0\n"
+		     "vpxorq 64(%2,%0), %%zmm1, %%zmm1\n"
+		     "vmovdqa64 %%zmm0, (%1,%0)\n"
+		     "vmovdqa64 %%zmm1, 64(%1,%0)\n"
+		     "add $128, %0\n"
+		     "jnz 1b\n"
+		     : "+&r"(i)
+		     : "r"(p1 + bytes), "r"(p2 + bytes)
+		     : "memory", "cc");
+}
+
+static void xor_avx512_3(long bytes, u8 *p1, const u8 *p2, const u8 *p3)
+{
+	long i = -bytes;
+
+	asm volatile("1: vmovdqa64 (%1,%0), %%zmm0\n"
+		     "vmovdqa64 64(%1,%0), %%zmm1\n"
+		     "vmovdqa64 (%2,%0), %%zmm2\n"
+		     "vmovdqa64 64(%2,%0), %%zmm3\n"
+		     "vpternlogq $0x96, (%3,%0), %%zmm2, %%zmm0\n"
+		     "vpternlogq $0x96, 64(%3,%0), %%zmm3, %%zmm1\n"
+		     "vmovdqa64 %%zmm0, (%1,%0)\n"
+		     "vmovdqa64 %%zmm1, 64(%1,%0)\n"
+		     "add $128, %0\n"
+		     "jnz 1b\n"
+		     : "+&r"(i)
+		     : "r"(p1 + bytes), "r"(p2 + bytes), "r"(p3 + bytes)
+		     : "memory", "cc");
+}
+
+static void xor_avx512_4(long bytes, u8 *p1, const u8 *p2, const u8 *p3,
+			 const u8 *p4)
+{
+	long i = -bytes;
+
+	asm volatile("1: vmovdqa64 (%1,%0), %%zmm0\n"
+		     "vmovdqa64 (%2,%0), %%zmm1\n"
+		     "vpxorq (%3,%0), %%zmm0, %%zmm0\n"
+		     "vpternlogq $0x96, (%4,%0), %%zmm1, %%zmm0\n"
+		     "vmovdqa64 %%zmm0, (%1,%0)\n"
+		     "add $64, %0\n"
+		     "jnz 1b\n"
+		     : "+&r"(i)
+		     : "r"(p1 + bytes), "r"(p2 + bytes), "r"(p3 + bytes),
+		       "r"(p4 + bytes)
+		     : "memory", "cc");
+}
+
+static void xor_avx512_5(long bytes, u8 *p1, const u8 *p2, const u8 *p3,
+			 const u8 *p4, const u8 *p5)
+{
+	long i = -bytes;
+
+	asm volatile("1: vmovdqa64 (%1,%0), %%zmm0\n"
+		     "vmovdqa64 (%2,%0), %%zmm1\n"
+		     "vpternlogq $0x96, (%3,%0), %%zmm1, %%zmm0\n"
+		     "vmovdqa64 (%4,%0), %%zmm1\n"
+		     "vpternlogq $0x96, (%5,%0), %%zmm1, %%zmm0\n"
+		     "vmovdqa64 %%zmm0, (%1,%0)\n"
+		     "add $64, %0\n"
+		     "jnz 1b\n"
+		     : "+&r"(i)
+		     : "r"(p1 + bytes), "r"(p2 + bytes), "r"(p3 + bytes),
+		       "r"(p4 + bytes), "r"(p5 + bytes)
+		     : "memory", "cc");
+}
+
+DO_XOR_BLOCKS(avx512_inner, xor_avx512_2, xor_avx512_3, xor_avx512_4,
+	      xor_avx512_5);
+
+/*
+ * Preconditions: bytes is a nonzero multiple of 512, and all buffers are
+ * 64-byte aligned.
+ */
+static void xor_gen_avx512(void *dest, void **srcs, unsigned int src_cnt,
+			   unsigned int bytes)
+{
+	kernel_fpu_begin();
+	xor_gen_avx512_inner(dest, srcs, src_cnt, bytes);
+	kernel_fpu_end();
+}
+
+struct xor_block_template xor_block_avx512 = {
+	.name = "avx512",
+	.xor_gen = xor_gen_avx512,
+};
▲ 这段为什么要这么写:按缓冲数展开(_2/_3/_4/_5 分别对应 1~4 个源盘 + dest)是因为异或对象个数决定能否用 vpternlogq——2 缓冲只能两输入 vpxorq,3 缓冲起就可以「加载 dest 与 src1 后,一条 vpternlogq $0x96 把 src2 也异或进来」($0x96 是三元真值表里 A⊕B⊕C 的编码)。关键一行:long i = -bytes 配合 add $64/$128, %0; jnz——用负索引从缓冲末尾回退、数到 0 结束,指针只需在循环外各加一次 bytes,于是「无论几个缓冲,每迭代都只有 2 条循环控制指令」。文件头注释点明这是 benchmark 扫出来的结论:2/3 缓冲需要 2 倍长度展开,4/5 缓冲连长度展开都不需要。外层 kernel_fpu_begin/end 是进内核 SIMD 区的标准协议。
diff --git a/lib/raid/xor/x86/xor_arch.h b/lib/raid/xor/x86/xor_arch.h
index 991abe3f4bbda..ed5921d2e2aad 100644
--- a/lib/raid/xor/x86/xor_arch.h
+++ b/lib/raid/xor/x86/xor_arch.h
@@ -6,21 +6,31 @@ extern struct xor_block_template xor_block_p5_mmx;
 extern struct xor_block_template xor_block_sse;
 extern struct xor_block_template xor_block_sse_pf64;
 extern struct xor_block_template xor_block_avx;
+extern struct xor_block_template xor_block_avx512;

-/*
- * When SSE is available, use it as it can write around L2.  We may also be able
- * to load into the L1 only depending on how the cpu deals with a load to a line
- * that is being prefetched.
- *
- * When AVX2 is available, force using it as it is better by all measures.
- *
- * 32-bit without MMX can fall back to the generic routines.
- */
 static __always_inline void __init arch_xor_init(void)
 {
-	if (boot_cpu_has(X86_FEATURE_AVX)) {
+	if (IS_ENABLED(CONFIG_X86_64) && boot_cpu_has(X86_FEATURE_AVX512F) &&
+	    !boot_cpu_has(X86_FEATURE_PREFER_YMM)) {
+		/*
+		 * Use the AVX-512 code on CPUs that support AVX-512 without
+		 * overly-eager downclocking.  On such CPUs the AVX-512 code
+		 * should always work at least as well as the AVX code, so
+		 * runtime selection is unnecessary.
+		 *
+		 * The AVX-512 code can work on X86_32.  However, due to lack of
+		 * use case for that, for now it's built only for X86_64.
+		 */
+		xor_force(&xor_block_avx512);
+	} else if (boot_cpu_has(X86_FEATURE_AVX)) {
+		/* AVX will be the best; no need to try others. */
 		xor_force(&xor_block_avx);
 	} else if (IS_ENABLED(CONFIG_X86_64) || boot_cpu_has(X86_FEATURE_XMM)) {
+		/*
+		 * When SSE is available, use it as it can write around L2.  We
+		 * may also be able to load into the L1 only depending on how
+		 * the cpu deals with a load to a line that is being prefetched.
+		 */
 		xor_register(&xor_block_sse);
 		xor_register(&xor_block_sse_pf64);
 	} else if (boot_cpu_has(X86_FEATURE_MMX)) {
▲ 这段的 why:选择条件是 X86_64 && AVX512F && !PREFER_YMM,注释明确「这类 CPU 上 AVX-512 至少不差于 AVX,所以运行时校准都不需要」——xor_force() 会让 xor-core.c 跳过 calibrate_xor_blocks 的逐模板测速,直接锁死。旧注释「When AVX2 is available, force using it」被拆散回各自分支,SSE 的「write around L2 / L1 only」说明被保留到 SSE 分支,语义不变。这也正是 v2 相对 v1 唯一的实质改动(v1 是两句简短注释,v2 扩成这段解释)。
📈 性能影响
| 场景/用例 | 运行环境 | AVX(改进前) | AVX-512(改进后) | 提升 |
|---|---|---|---|---|
xor_gen 基准,src_cnt=1 | AMD Ryzen 9 9950X(Zen 5) | 56353 MB/s | 75388 MB/s | +33% |
| src_cnt=2 | 同上 | 54274 MB/s | 68409 MB/s | +26% |
| src_cnt=3 | 同上 | 44649 MB/s | 64042 MB/s | +43% |
| src_cnt=4 | 同上 | 41315 MB/s | 55002 MB/s | +33% |
说明:数据全部来自作者 commit message 自报(作者自报,未独立验证);度量单位为 MB/s(作者原文即 MB/s,与内核 xor-core.c 校准输出的 "MB/sec" 口径一致,均为十进制 MB/s 而非 MiB/s)。补丁未提供其他 CPU(Intel SPR / Rocket Lake 等)上的数据。
🔄 方案演进 + 讨论焦点
- 2026-06-12 ~ 06-15:作为独立单补丁迭代(v1 06-12 → v2 06-14 → v3 06-15),即「lib/raid/xor: x86: Add AVX-512 optimized xor_gen()」单补丁。
- 2026-06-26:并入 8 补丁系列「x86: Remove cpu_has_xfeatures() and add AVX-512 xor_gen()」第一版(cover / 8/8,+135/-11)。AVX-512 xor 的实现(
xor-avx512.c)自本版起已与最终版相同;此时arch_xor_init()里只有两句简短注释。 - 2026-07-28 v2:系列第二版(本补丁 +142/-11)。按 cover letter 的 changelog,本补丁 8/8 的唯一改动是扩写了
arch_xor_init()的注释(说明选择策略、X86_32 未启用原因、为何无需运行时选择);另两个改动(x86 在 FPU/XSAVE 缺失时清 AVX* 位、UML commit message)属于系列前几个补丁。
- Christoph Hellwig(hch)评审本补丁(20260728034404.GE18902@lst.de):原文仅一句「Stick to the xor: prefix here as well please.」——要求补丁标题前缀统一用
xor:(即「xor: x86: Add AVX-512 …」而非「lib/raid/xor: …」),是命名风格类 nit,未涉及机制问题。 - David Laight 与 Christoph Hellwig 均为本补丁 Reviewer(补丁自带
Reviewed-by)——说明机制层面已获认可。 - 系列级评审:x86 维护者 Borislav Petkov 与 David Laight 对系列中
cpu_has_xfeatures()清理类补丁(3/8、4/8)有多轮讨论与往返(如 David Laight 07-28、BP 07-30);这些是 AVX-512 能安全启用的前提补丁,本 xor 补丁本身未见机制性质疑。
注:讨论观点均链接到来源 message-id。截止 2026-08-04 本补丁未合入主线(本地 linux 7.2-rc6 无 xor-avx512.c)。
⚠️ 风险与局限
- 降频风险(已用 !PREFER_YMM 封堵):ZMM 在 Skylake-SP / Ice Lake 上触发激进降频,作者沿用 crypto/CRC 的
PREFER_YMM策略排除之。风险点在于该位判断若有误(新 CPU 未置位 / 旧 CPU 误置),要么白启用慢路径、要么错过收益——属于配置位错误,不产生错误结果(解读(AI 分析))。 - 适用面有限:只在
AVX512F && !PREFER_YMM的 x86_64 上生效;其余 CPU(含所有 Intel 服务器 Skylake-SP/Ice Lake、Intel 客户端 < Zen5 前的部分型号)继续用 AVX/SSE,行为与现状完全一致,无回归面扩大。 - 端到端收益被 I/O 稀释:26%~43% 是纯异或吞吐(内存驻留、流式预取)的实验室数据;真实 RAID 写路径上磁盘/网络 I/O 是 off-CPU 瓶颈,端到端写吞吐提升会小得多,且作者未提供整机 RAID 写基准(解读(AI 分析))。
- FPU 进出开销:每次调用
kernel_fpu_begin()/kernel_fpu_end()要保存/恢复 FPU 状态,对每次 4KB~128KB 的校验粒度摊销后极小;但对极小条带(短bytes)调用频繁时,会成为固定开销(解读(AI 分析))。xor_gen的契约(bytes为 512 倍数、64 字节对齐)由xor-core.c的WARN_ON_ONCE与既有调用方保证。 - 无独立复现:基准为作者单机自报,未见他人在其他 CPU/编译器上复现,结论待独立验证。
🔗 交叉引用
crypto/async_tx/async_xor.c:md/raid5 的 P 校验生成经async_xor_offs()最终落到xor_gen()——这是本补丁受益的主路径(本地内核源码,lib/raid/xor/xor-core.c中的static_call(xor_gen_impl)分派点)。fs/btrfs/raid56.c:btrfs RAID5/6 直接调用xor_gen()生成 P/Q,同享本补丁收益。- 系列前 7 个补丁(cpu_has_xfeatures 清理):把「XCR0 里 AVX/AVX-512 xstate 位是否开启」统一到启动时检查,是本补丁能安全启用 AVX-512 的前提——cover letter 明确「此前 AVX-512 xor 被
cpu_has_xfeatures()的混乱与 UML 缺失阻塞」。 - 同一策略先例:crypto/CRC 的 x86 实现同样用
!PREFER_YMM排除降频 CPU,本补丁沿用该策略。
✅ 关键洞察
- 发现:RAID5/6 写路径的校验异或是一段内存带宽型纯计算,内核此前卡在 256 位 AVX + 两输入 XOR;本补丁用 512 位 ZMM +
vpternlogq三输入异或 + 负索引循环,把每字节指令数与依赖链压下来,换来纯校验吞吐 +26%~43%。 - 证据:AMD Ryzen 9 9950X(Zen 5)上 src_cnt=1/2/3/4 分别 56353→75388(+33%)、54274→68409(+26%)、44649→64042(+43%)、41315→55002(+33%)MB/s——作者 commit message 自报,未独立验证。
- 边界:仅
x86_64 && AVX512F && !PREFER_YMM(AMD Zen4+、Intel SPR/Rocket Lake/Nova Lake+)启用;Skylake-SP/Ice Lake 等降频 CPU 与全部 32 位继续走 AVX/SSE,无行为变化;端到端 RAID 写吞吐受 I/O 瓶颈稀释,实际提升可能显著小于纯异或数字。 - 风险 / 建议:未合入主线(截至 7.2-rc6),基准待独立复现;后续关注 v3 是否并入 x86 维护树,以及他人在 Intel SPR 上的复测数据。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。