mm/mglru: use folio_mark_accessed to replace folio_set_active
💡 一句话总结
在内存受限(memcg 1GB)且大量读取文件页的构建类负载下,MGLRU 原本在每次缺页时就把读入的页标记为活跃(folio_set_active()),导致预读带进来的冷页挤占"受保护"的年轻代、把真正热的工作集挤出内存,引发大量换入换出与 refault;本补丁改用 folio_mark_accessed(),让缺页读入的文件页从"第二旧代"冷起步、只有被真实复用才提升到活跃代——作者在 x86 内核构建(1GB memcg、20 线程)实测:换入页数 -57%、换出页数 -47%、内核态 CPU 时间 -9.4%(作者自报,未独立验证)。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 优化(页回收行为修正:消除 MGLRU 对缺页/预读冷页的过度保护) |
| 状态 | Merged(已合入主线 Linux 7.2,首个含此补丁的发布 tag 为 v7.2-rc1;commit 2026-06-04,Andrew Morton 合入) |
| 当前版本 | v3(合入主线版)· lore 链接 · git.kernel.org commit |
| 版本演进 | RFC(02-25,lazily activate)→ v1(04-18,+1/-1)→ v2(05-25,+15/-11)→ v3(05-26,+25/-9,合入) |
| 作者机构 | Barry Song (Xiaomi) <baohua@kernel.org>(小米),Tested-by Lance Yang / Xueyuan Chen |
| 提交日期 | 2026-06-04(合入);作者署名 2026-05-26 |
| 改动范围 | 4 文件(include/linux/mm_inline.h、mm/swap.c、mm/vmscan.c、mm/workingset.c),+25/-9 |
| 核心函数 | folio_add_lru() / lru_gen_folio_seq() / lru_gen_set_refs() / lru_gen_refault() |
| 原始链接 | [PATCH v3] lore Message-ID 20260526130938.66253-1-baohua@kernel.org |
📊 速览卡片
特性等级依据:内存受限场景收益显著(换入页 -57%、内核态 CPU 时间 -9.4%,作者自报)且纯内核改动、无硬件/配置门槛、易于落地;但收益集中在文件页 + 内存压力负载,并改变了回收语义有一定行为风险 → ★★★★
🎯 解决什么问题
lru_gen_in_fault() 为真"时就把页激活。问题是当地址 N 发生缺页时,readahead(预读)会把 N 周围许多 folio 一起读进来,这些预读 folio 也一起被激活,尽管它们中很多永远不会被真正访问。作者引用合作者 Tangquan 的观察:这在 Android 设备上用 MGLRU 时会造成显著的 file refault。作者还提到 Lei Liu 曾提出"为 readahead 单独建一条 LRU"的方案(message-id 20250916072226.220426-1-liulei.rjpt@vivo.com),但作者认为那"可能过度设计了"(over-engineered)。
max_seq 是最年轻代、min_seq 是最旧代,回收(eviction)从最旧代开始。一个 folio 落进哪一代由 lru_gen_folio_seq() 决定。补丁前,缺页路径的 folio_add_lru() 会对每一个在缺页时读入的 folio 调用 folio_set_active() 置上 PG_active 位——而 MGLRU 对带 PG_active 的 folio 是放进"第二年轻代"(活跃代)。于是"读进来但从未被访问"的预读页与真正热的工作集页享受同样的高优先级保护,把真正的热点挤出内存。
🧩 核心机制
一句话:把"缺页即激活"改成"缺页先标 referenced、真正复用才提升"——用更弱的 PG_referenced 信号起步,用更强的 PG_active/PG_workingset 信号只奖励真实热点。
| 文件/函数 | 改动 | 为什么是机制关键 |
|---|---|---|
mm/swap.c folio_add_lru() | 缺页读入时不再无条件 folio_set_active();改为:workingset folio → 仍 folio_set_active();否则若尚未 referenced → folio_mark_accessed() | 分流点:只有"refault 回来的 working set"才享受活跃代保护;普通缺页/预读页只打 PG_referenced |
include/linux/mm_inline.h lru_gen_folio_seq() | 文件页代际公式从 MAX_NR_GENS - workingset 改为 MAX_NR_GENS - (workingset || referenced);恢复 anon folio 原有分支 | 落点:带 PG_referenced 的文件页进入"第二旧代",未 referenced 的进最旧代——从冷处起步;anon 仍受保护(第二年轻代) |
mm/vmscan.c lru_gen_set_refs() | rmap 扫描路径从"一律置 workingset"改为"第 2 次访问才置 workingset,否则 folio_mark_accessed()" | 晋升门:恢复"二次访问才晋升"机制(Kairui review 驱动的修复) |
mm/workingset.c lru_gen_refault() | WORKINGSET_ACTIVATE 计数只在 workingset 分支内(与 folio_set_active() 对齐) | 记账对齐:防止 refault 非 working set 页被误计入激活统计 |
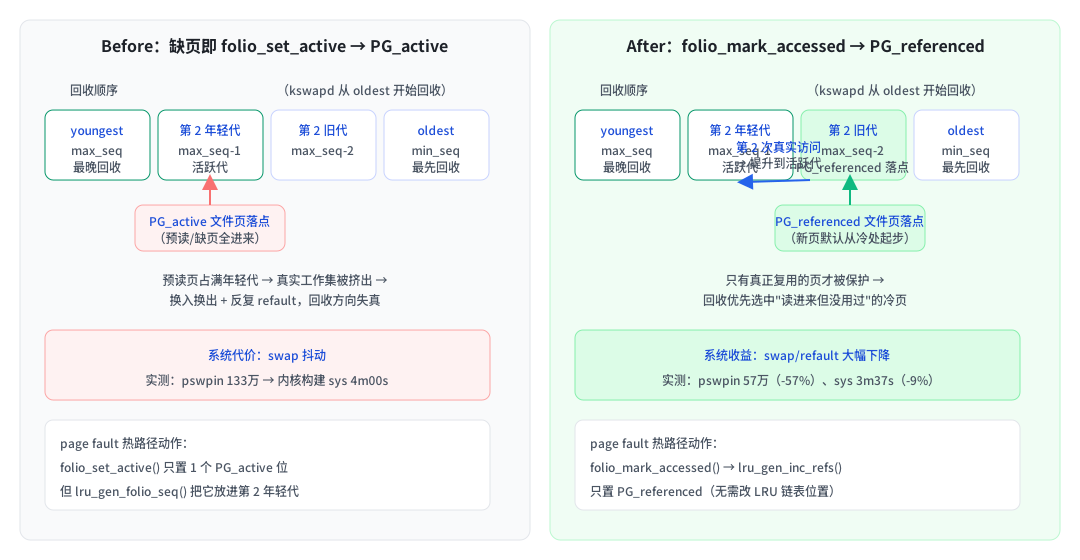
来源:基于 git show 真实 diff(commit 6cbdd9726fb5)绘制
| folio 状态 | 旧行为落点 | 新行为落点 | 回收优先级 |
|---|---|---|---|
| 缺页读入的文件页(未复用) | PG_active → 第二年轻代(活跃代) | PG_referenced → 第二旧代 | 从"难回收"变"易回收" |
| 缺页读入、从未被访问的预读页 | 同上(过度保护) | 无 referenced → 最旧代 | 最先被回收 |
| 真正被复用的文件页(第 2 次访问) | — | lru_gen_set_refs() 置 PG_workingset → 提升到活跃代 | 与旧行为一致(获得保护) |
| refault 回来的 working set 页 | folio_set_active() | folio_set_active()(保留) | 不变 |
| anon 页(非 swapcache) | 缺页时 PG_active | lru_gen_folio_seq() 的 anon 分支仍给第二年轻代 | 不变(Kairui review 要求恢复) |
diff --git a/mm/swap.c b/mm/swap.c
index 2dd84813f4dd..588f50d8f1a8 100644
--- a/mm/swap.c
+++ b/mm/swap.c
@@ -544,10 +544,20 @@ void folio_add_lru(struct folio *folio)
 			folio_test_unevictable(folio), folio);
 	VM_BUG_ON_FOLIO(folio_test_lru(folio), folio);

-	/* see the comment in lru_gen_folio_seq() */
+	/*
+	 * For refaulted workingset folios, set PG_active so they
+	 * can be added to active generations.
+	 * For prefaulted file folios, folio_mark_accessed() sets
+	 * PG_referenced so lru_gen_folio_seq() places them into
+	 * the second oldest generation.
+	 */
 	if (lru_gen_enabled() && !folio_test_unevictable(folio) &&
-	    lru_gen_in_fault() && !(current->flags & PF_MEMALLOC))
-		folio_set_active(folio);
+	    lru_gen_in_fault() && !(current->flags & PF_MEMALLOC)) {
+		if (folio_test_workingset(folio))
+			folio_set_active(folio);
+		else if (!folio_test_referenced(folio))
+			folio_mark_accessed(folio);
+	}

 	folio_batch_add_and_move(folio, lru_add);
 }
▲ 这是整个机制的分流核心:旧代码对每个缺页读入的 folio 都 folio_set_active()(置 PG_active → 活跃代);新代码只对 PG_workingset(refault 回来的真实工作集)保留 folio_set_active(),其余(含所有普通预读/缺页页)只 folio_mark_accessed()。关键在 folio_mark_accessed() 在 MGLRU 下走 lru_gen_inc_refs()——只置 PG_referenced 位并累加一个引用计数,不触碰 LRU 链表结构,比"激活"轻得多,而 lru_gen_folio_seq() 会把带 PG_referenced 的文件页放进第二旧代。
diff --git a/mm/vmscan.c b/mm/vmscan.c
index 3c856a78c0a5..76193a84a2af 100644
--- a/mm/vmscan.c
+++ b/mm/vmscan.c
@@ -850,7 +850,11 @@ static bool lru_gen_set_refs(struct folio *folio)
 		return false;
 	}

-	set_mask_bits(&folio->flags.f, LRU_REFS_FLAGS, BIT(PG_workingset));
+	/* Promote on second access */
+	if (folio_lru_refs(folio) > 1)
+		set_mask_bits(&folio->flags.f, LRU_REFS_FLAGS, BIT(PG_workingset));
+	else
+		folio_mark_accessed(folio);
 	return true;
 }
 #else
▲ 这是"复用才晋升"的第二个入口(rmap 扫描路径):旧代码对 folio_check_references() 判定为 referenced 的 folio 一律置 PG_workingset(晋升);新代码只在 folio_lru_refs() > 1(第 2 次访问)时才晋升,首次访问只 folio_mark_accessed()。为什么必须改:因为补丁让 PG_referenced 在缺页时就置上(提前了),若这里还按"首扫见 referenced 就晋升",任何刚被缺页读入的冷页都会被立刻提升——必须改判据为"引用计数 > 1"才能区分"第一次读到"与"真的在用"。
📈 性能影响
次角度:on-CPU 开销降低——换入换出减少 → kswapd/缺页/swap 处理的 CPU 时间下降(作者基准中 sys 时间 -9.4%);同时
folio_mark_accessed() 只置位/计数,比 MGLRU 下需要"从 LRU 摘下来再加回活跃代"的 folio_activate() 路径更轻(解读(AI 分析))。按 Brendan Gregg 视角:延迟 = on-CPU 计算 + off-CPU 等待,这里主要砍的是 off-CPU 的 swap/I/O 等待,附带 on-CPU 的回收处理开销。
folio_add_lru())与回收扫描(lru_gen_set_refs())两条路径,二者都只在"内存有压力、回收持续运行"时才会高频生效。因此收益前提是内存容量小于工作集(memcg 限额、容器、移动端等),且负载以文件页为主(构建、数据库缓存、文件密集服务)。无内存压力时补丁基本 no-op(解读(AI 分析))。
| 指标(x86 内核构建,memcg 1GB、20 线程) | 改进前 w/o patch | 改进后 w/ patch | 变化 |
|---|---|---|---|
| real 墙钟时间 | 1m50.764s | 1m48.879s | -1.7% |
| sys 内核态 CPU 合计 | 4m0.012s | 3m37.421s | -9.4% |
| pswpin 换入页数 | 1,333,245 | 568,480 | -57.4% |
| pswpout 换出页数 | 4,366,443 | 2,322,657 | -46.8% |
| pgpgin 页读入 | 6,962,592 | 4,073,416 | -41.5% |
| pgpgout 页写出 | 17,780,712 | 9,613,408 | -45.9% |
| refault_file 文件 refault | 287,794 | 262,505 | -8.8% |
| refault_anon 匿名 refault | 1,347,963 | 577,550 | -57.2% |
说明:数据来自 commit message(PATCH v3)作者自报,未独立验证。作者另附经典 active/inactive LRU 对照:real 1m49.928s、pswpin 463,452——说明补丁后 MGLRU 在该负载上与经典 LRU 表现相当(甚至略快),且 refault_file 更低(262,505 vs 562,555)。
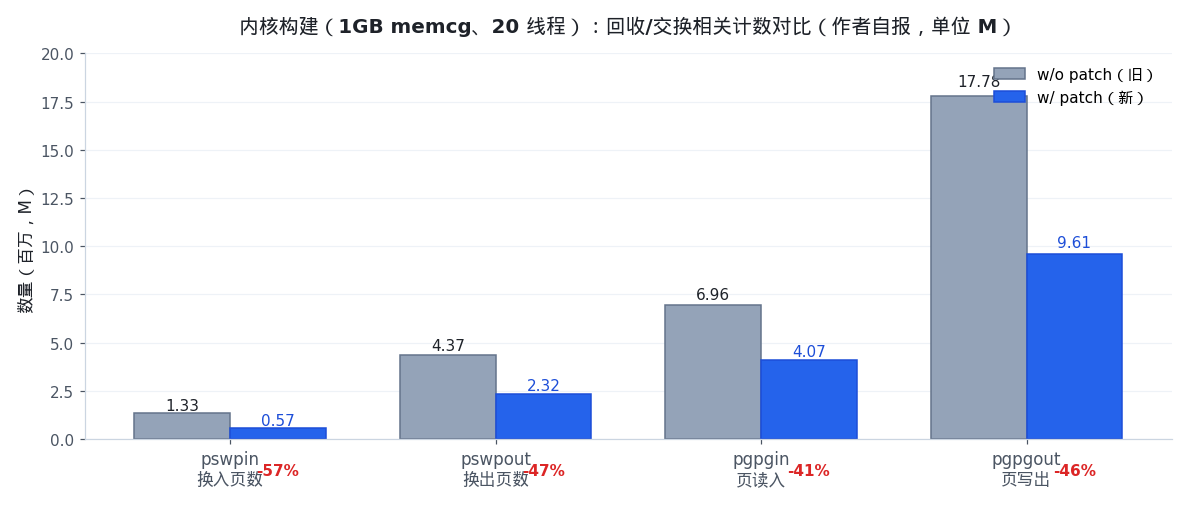
来源:作者自报数据(commit message)
🔄 方案演进
本补丁从 2 月的 RFC 到 5 月底合入主线,经历了 4 个版本,核心变化由 Kairui Song 的 review 推动。演进脉络(各版链接均经 checking-references 验证):
folio_activate_on_mapped(),在 filemap_fault()/filemap_map_pages() 真正把页映射进页表时才激活(3 文件 +19/-1)。对 anon 保留 folio_set_active(),只对文件页做"映射时才激活"。v1(04-18):收窄为 1 行改动(+1/-1)——直接把
folio_add_lru() 里的 folio_set_active(folio) 换成 folio_mark_accessed(folio)。附带 fio 模型演示与 arm64 "old PTE" 背景说明。v2(05-25):扩到 4 文件(+15/-11)——补上
lru_gen_folio_seq() 代际公式、lru_gen_set_refs()、lru_gen_refault() 的配套调整。v3(05-26):合入主线版(+25/-9)——按 Kairui review 修正两处(见下)。
lru_gen_folio_seq() 恢复 anon folio 原有分支(anon 仍放第二年轻代)。MAX_NR_GENS - folio_test_workingset(folio) || folio_test_referenced(folio) 优先级有歧义,问作者本意是 (MAX_NR_GENS - workingset) || referenced 还是 MAX_NR_GENS - (workingset || referenced) → v3 用括号写成后者。lru_gen_set_refs() 用 folio_test_active() 是坏的——"PG_active is always unset for on LRU folios for MGLRU… So PG_workingset seems broken by this point, rmap walk no longer get PG_workingset set, which removes the 'promote on 2nd access' mechanism entirely?" → v3 改用 folio_lru_refs(folio) > 1(第二次访问才晋升)。注:RFC/v1/v2/v3 各版链接均已通过 lore 索引验证(message-id 精确命中);Kairui 的 review 内容取自 lore 原文。
⚠️ 风险与局限
CONFIG_LRU_GEN,多数发行版默认开启);否则 folio_mark_accessed() 走经典 active/inactive 路径,本补丁的 4 处改动均被 lru_gen_enabled()/#ifdef CONFIG_LRU_GEN 门控,行为不变。② 必须有内存压力:改动只影响"回收选 victim"这一步,无压力时是 no-op。
③ 负载以文件页为主:作者基准与 fio 模型都是文件页场景;纯 anon 工作集负载收益有限(解读(AI 分析))。
PG_referenced/refs,被清后要重新累积计数才能晋升,热页可能在下次扫描前被误回收。作者接受此权衡(来源:Kairui review message-id CAMgjq7CZt+EFoVqSti93QpKUNJ4VySxm5TAOgkMmpkS+73QyZA@mail.gmail.com)。WORKINGSET_ACTIVATE 计数口径收紧(只在真实 workingset refault 时计数),依赖该计数做容量规划的监控可能看到数值下降——不是回归,是口径更准确。folio_mark_accessed()/folio_set_active() 均为既有 API,不改签名。对依赖 MGLRU 行为的第三方模块/调优(如显式 posix_fadvise(DONTNEED)、madvise 冷热提示)的影响很小——它们仍会走各自路径(解读(AI 分析))。
lru_gen_set_refs() 的 PG_active 误判)全部在 v3 得到修复并合入;整体方向获其明确认可(CAMgjq7CZt+EFoVqSti93QpKUNJ4VySxm5TAOgkMmpkS+73QyZA@mail.gmail.com)。此外作者也 Cc 了多位 mm 相关维护者(Matthew Wilcox、Suren Baghdasaryan、Shakeel Butt 等)与 MGLRU 生态相关人(Yuanchu Xie、Wei Xu、Kalesh Singh 等);commit message 未出现 Yu Zhao 的 Ack/Reviewed tag。
🔗 交叉引用
PG_active folio 从"最年轻代"改为"第二年轻代",但仍过度保护,本补丁在其基础上继续收紧。Lei Liu: mm/vmscan: Add readahead LRU to improve readahead file page reclamation efficiency — 被作者否定的替代方案(单独 readahead LRU),本补丁用更轻的手段达到同类目的。
Kairui Song: mm/mglru: frequency guided workingset promotion (MGLRU-FG) — review 中提到的并行演进方向(频率引导的工作集提升,RFC 06/32),与本补丁的"二次访问晋升"理念一致。
LWN: Refault distance update with MGLRU support — Kairui 引用的 refault-distance 再激活实验(某数据库 +500%),指向未来更精确的激活策略。
RFC: mm/mglru: lazily activate folios while folios are really mapped — 本补丁的起点(02-25),思路从"映射时才激活"收敛到"referenced 冷起步"。
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。