io_uring: get rid of tw_pending for !DEFER task work
💡 一句话总结
在常规(非 DEFER_TASKRUN)io_uring 高吞吐负载下,普通 task_work 的 mpscq 队列在一次运行中会多次经历"空→非空"切换,旧实现用一个 per-tctx 的 tw_pending 原子位来守卫"回调只挂入内核 task_work 链表一次";本 commit 把运行策略改为"队列一空就停"(用新增的 mpscq_pop_emptied() 判断并 break),从而移除该守卫位,连同它在入队热路径上的原子位操作和每次运行开头的内存屏障一起删掉。补丁未提供基准数据,属于 mpscq 重构系列的收尾清理 + 热路径微优化。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 重构(refactor)+ 热路径优化(performance)——移除 tw_pending 守卫机制,行为等价但删掉入队热路径上的原子位操作与屏障 |
| 状态 | 状态(Merged)· 合入版本:Linux 7.2 |
| 当前版本 | 主线合入版本 v7.2-rc1(git describe --contains 实测确认)· git.kernel.org commit |
| 版本演进 | 本 commit 为 io_uring 7.2 合并窗口内 mpscq 重构系列的收尾补丁(第 6 个)。它移除的 tw_pending 位由同系列第 3 个补丁 de7341ffe49e(2026-06-11)引入、本 commit(2026-06-15)移除,整个生命周期都在 7.2 开发窗口内,从未随任何发布版本发布。(该 commit 无 Link/Message-ID trailer;本环境 lore MCP 持续超时不可用,系列演进信息来自本地内核 git 提交链 + commit message 的 Suggested-by/Reviewed-by 链,如实标注) |
| 作者机构 | Jens Axboe(io_uring / block 子系统维护者) |
| 提交日期 | 2026-06-15(作者/提交时间 2026-06-15,时区 -0600) |
| 改动范围 | include/linux/io_uring_types.h、io_uring/mpscq.h、io_uring/tw.c,+17/-13,3 个文件 |
| 核心函数 | io_req_normal_work_add() / tctx_task_work_run() / mpscq_pop_emptied()(新增) |
| 原始链接 | git.kernel.org(完整 40 位 SHA 规范路径) |
📊 速览卡片
特性等级依据:收益真实但幅度小且无量化数据(纯删原子操作/屏障),落地零门槛、无硬件依赖、兼容好,且覆盖所有常规 io_uring 负载 → 综合 ★★★
🎯 解决什么问题
50cb44bd0d5f 引入 mpscq(无锁多生产者单消费者 FIFO 队列)原语;② d46ab2c98aba 把 DEFER_TASKRUN 的 local task_work 换到 mpscq;③ de7341ffe49e 把普通(tctx)task_work 换到 mpscq 并引入 tw_pending 守卫位;④ df58c2161684 让 tctx 的 task_work 回退直接跑;⑤ 576cce91480a 删除 per-ctx 回退机制;⑥ 本 commit ca4aa97194ae 移除 tw_pending 位。整体价值:llist 需要 O(n) 的 llist_reverse_order() 反转才能按入队顺序处理,且 capped run(sqpoll)需要额外的 retry_list 携带未处理余量;换成 mpscq 后入队 O(1)、出队天然 FIFO,本补丁再把这个迁移引入的临时守卫位去掉。单看本补丁只是删一个位,放到系列里才看到它是"迁移完成的自然收尾"。
tctx_task_work() 运行回调会增量 drain——单次运行中可以多次把队列取到"空"又因新生产者入队变"非空"。每次"空→非空"切换,mpscq_push() 都会返回 true("入队前队列为空"),如果没有守卫,生产者就会把同一个 tctx->task_work 回调头重复挂到内核的 task_work 链表上,直接破坏链表结构。为此 de7341ffe49e 引入了 tw_pending 位:入队时 test_and_set_bit 保证每轮运行只挂一次,运行开头 clear_bit 复位。本 commit 的作者采纳了 Caleb Sander Mateos(Pure Storage,commit message 中 Suggested-by 与 Reviewed-by 均是他)的建议:只要运行到队列一空就立即停止,这个守卫位就变得多余——运行结束时队列必空,下一次"空→非空"入队时的回调头必然已不在链表上,重复挂入天然安全。
test_and_set_bit(),在每次运行开头做一次 clear_bit() + smp_mb__after_atomic() 全屏障。本 commit 通过改变运行策略消除守卫需求,从而把这两块开销一并删掉。
io_uring_enter 提交成百上千个异步读/写,磁盘/NIC 完成中断在任意一个 CPU上触发,完成路径把请求塞进提交线程的 tctx->task_list 并唤醒它的 task_work 运行;提交线程回到用户态(或再次 enter)时内核运行 task_work 逐个处理完成。这种负载下 io_req_normal_work_add() 是每完成一次必走的入队路径,且完成 CPU 与提交 CPU 常常不同——旧实现里对 tctx->tw_pending 这个共享缓存行的原子读改写会在核间乒乓,正是热路径上可被观察到的开销。多队列存储、数据库、事件循环等"高频异步 I/O + 完成即唤醒"的应用都会踩到这条路径。
io_req_normal_work_add(),每次"空→非空"转换省一次跨 CPU 原子位操作,运行开头省一次 clear_bit + 全屏障🧩 核心机制
核心思路一句话:与其用一个位去拦"运行中重复挂回调",不如让运行一看到队列空就立即收工。这样运行结束时刻队列保证为空,下一次"空→非空"入队的生产者挂回调时,上一次运行早已结束(或正在处理最后一项、紧接着就收工),回调头已从内核链表出队,重复挂入安全,守卫位自然可以删掉。
xchg() 发布节点并返回"入队前是否为空"(即 tail 是否为 stub 哨兵);消费者持有外部游标 tctx->task_head 逐个 mpscq_pop() 摘节点,摘到最后一个节点时用 try_cmpxchg() 把 tail 改回 stub。消费者摘最后一个节点后,游标回到 stub、tail 也回到 stub——这是"队列真正为空"的精确时刻。本 commit 做三处改动:① 新增
mpscq_pop_emptied(q, head)——判断"最近一次返回节点的 mpscq_pop() 是否同时排空了队列",实现就是检查消费者游标是否已回到 stub;② 在 tctx_task_work_run() 处理完每项后加 if (mpscq_pop_emptied(...)) break;——一空即停;③ 删掉 io_req_normal_work_add() 里的 test_and_set_bit(tw_pending)、tctx_task_work() 与 io_tctx_fallback_work() 开头的 clear_bit(tw_pending) + smp_mb__after_atomic(),以及结构体里的 tw_pending 字段。为什么"一空即停"能替代位守卫(解读(AI 分析)):
mpscq_push() 只有观察到 tail == stub 时才返回 true("入队前队列为空");而 tail 只在消费者摘最后一个节点的那一刻才被改回 stub。所以当某个生产者看到"空→非空"并准备挂回调时,消费者要么已经结束运行,要么正在处理刚摘下的最后一项、紧接着就会因 emptied 检查而 break。两种情形下回调头都已从内核 task_work 链表出队(内核的 task_work 机制是先把回调摘下来再调用它),重复挂入同一个回调头不会造成链表重复链接——这正是旧守卫位唯一要防的场景。
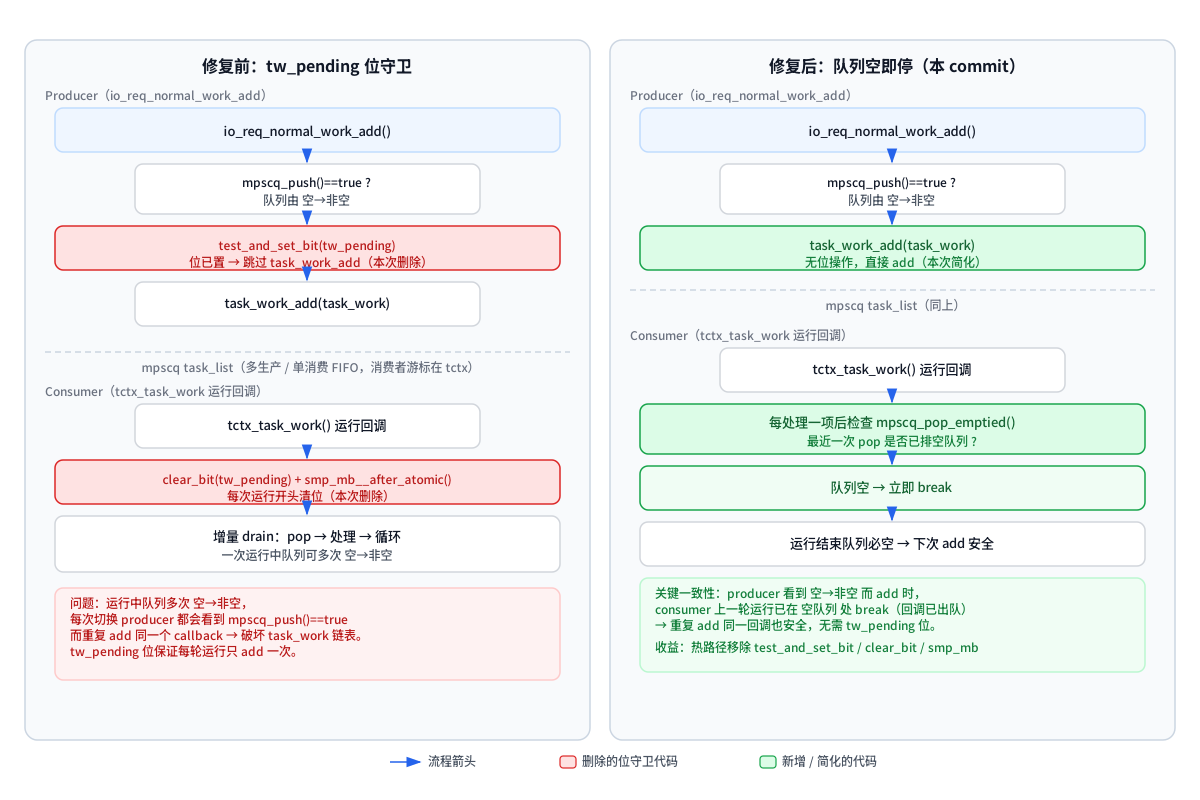
tw_pending 位守卫"回调只挂一次",修复后消费端"队列空即 break",守卫位连同其原子操作一并移除。来源:基于本地内核 git(commit ca4aa97194ae)真实 diff 绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| ① 入队 | io_req_normal_work_add():mpscq_push(&tctx->task_list, ...) | 完成请求入队;返回 true 表示"空→非空"转换,需要确保有一轮运行 |
| ② 挂回调 | task_work_add(tctx->task, &tctx->task_work, ...)(旧代码先经 test_and_set_bit(tw_pending) 判重,本 commit 删除) | 把 tctx 运行回调挂上内核 task_work 链表;守卫位已删 |
| ③ 运行 | tctx_task_work_run() 循环 mpscq_pop() → 处理请求 → mpscq_pop_emptied()? | 处理队列中请求;每处理完一项检查队列是否已空 |
| ④ 收工 | if (mpscq_pop_emptied(...)) break; | 队列一空立即停止本轮运行,保证运行结束时队列为空(新增),替代旧代码开头的 clear_bit + smp_mb |
@@ io_uring/tw.c:tctx_task_work_run() 处理完每项之后 @@
 		(*count)++;
+		/*
+		 * Break if most recent pop emptied the queue. This helps
+		 * bound task_work run, and also protects the regular
+		 * task_work addition.
+		 */
+		if (mpscq_pop_emptied(&tctx->task_list, tctx->task_head))
+			break;

@@ io_uring/mpscq.h:新增辅助函数 @@
+/*
+ * Returns true if the most recent mpscq_pop() that returned a node also
+ * emptied the queue. Consumer must be serialized.
+ */
+static inline bool mpscq_pop_emptied(struct mpscq *q, struct llist_node *head)
+{
+	return head == &q->stub;
+}
▲ 这段改动是机制成立的关键:mpscq_pop_emptied() 用"消费者游标是否回到 stub"精确判定队列已排空;每次处理完一项就检查并 break,把单次运行严格限定在"队列非空期间",从而让"下次空→非空入队时回调必然已出队"这个不变式成立,tw_pending 守卫位不再需要。
📈 性能影响
test_and_set_bit(0, &tctx->tw_pending)(每次"空→非空"转换一次);开销降低——每次 task_work 运行移除一次 clear_bit(0, ...) + smp_mb__after_atomic() 全屏障。主类是 on-CPU 减指令/减原子;不涉及锁等待或 I/O 等待(这是纯计算路径瘦身)。
tctx->tw_pending 所在的共享缓存行做原子读改写,会造成该缓存行在核间乒乓。本 commit 把入队路径的原子操作从"mpscq_push 的 xchg + tw_pending 的 test_and_set_bit 两个"降为"只剩 mpscq_push 的 xchg 一个"。此外"队列空即停"还带来运行边界更清晰的副作用:单次运行不会无限追着持续入队的新工作跑,新工作留待下一次已调度的运行。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| io_uring 常规异步 I/O 完成路径 | 任意(无特殊硬件前提) | 每次"空→非空"转换 1 次 test_and_set_bit;每次运行 1 次 clear_bit + 1 个全屏障 | 上述原子操作与屏障全部移除(补丁未提供量化基准) |
说明:补丁未提供基准数据(commit message 无 benchmark)。上表为逻辑分析(解读(AI 分析)):收益来自删除原子操作与屏障的确定性指令/总线流量减少,方向明确但幅度小且未被作者量化。读者不宜据此期望可感知的吞吐/延迟提升,它更多是"把迁移引入的临时开销清干净"的结构性收益。
🔄 方案演进
本 commit 是 mpscq 重构系列的收尾补丁,其"演进"就是该系列在 7.2 合并窗口内的推进。lore 在本环境不可用(MCP 持续超时),以下基于本地内核 git 提交链 + commit message 的 Suggested-by/Reviewed-by 链如实整理。
50cb44bd0d5f 引入 mpscq 原语 → d46ab2c98aba 换 local task_work → de7341ffe49e 换普通 task_work。换普通路径时,因 mpscq 增量 drain 会多次"空→非空",de7341ffe49e 同步引入了 tw_pending 位守卫。随后 df58c2161684 与 576cce91480a 重构了 tctx 回退路径(直接运行、删除 per-ctx 回退机制)。2026-06-15,本 commit
ca4aa97194ae 采纳 Caleb Sander Mateos 的建议,把运行策略改为"队列空即停",删除 tw_pending。整个位从引入到移除只有 4 天,都在 7.2-rc1 之前,从未随任何正式版本发布。
Suggested-by 出现并被作者采纳,同时以 Reviewed-by 背书;Jens 作为 io_uring 维护者直接合入。(讨论细节无法从 lore 取得,此处仅依据 commit message 的签名链与系列提交内容,属可核实的部分;其余 reviewer 往来无公开可查信息,不臆造)
⚠️ 风险与局限
io_req_normal_work_add() 用 tctx->task_list(mpscq);DEFER 路径走 io_req_local_work_add() 的 ctx->work_list,本就不含 tw_pending,不受影响。SQPOLL 模式的 capped run(每轮最多 IORING_TW_CAP_ENTRIES_VALUE 项)也调用 tctx_task_work_run(),"空即停"对它是纯受益(边界更早触发)。收益前提不需要任何硬件特性或配置,属于纯内核内部改动。
trace_io_uring_task_work_run 追踪点的 count 语义不变,可观测性不受影响。
tw_pending 字段是 struct io_uring_task 内部状态,从未导出、从未随版本发布(7.2 开发窗口内引入即移除),对工具链、用户态库(liburing)、其他子系统零依赖。
Suggested-by + Reviewed-by 背书,说明方案在合入前已获审阅;Jens Axboe 作为维护者合入。正确性核心("一空即停"如何替代守卫位)已在本报告核心机制章节以 mpscq 的 tail/stub 语义推演(标解读(AI 分析)),未发现需要作者回应而未回应的公开质疑。
🔗 交叉引用
50cb44bd0d5f — io_uring/mpscq: add lockless multi-producer, single-consumer FIFO queue — 系列第 1 补丁,mpscq 原语(本 commit 的
mpscq_pop_emptied 挂在这里)d46ab2c98aba — io_uring: switch local task_work to a mpscq — 系列第 2 补丁,DEFER 路径换 mpscq
df58c2161684 — io_uring: run the tctx task_work fallback directly — 系列第 4 补丁,tctx 回退直接运行
576cce91480a — io_uring: remove the per-ctx fallback task_work machinery — 系列第 5 补丁,删除 per-ctx 回退机制
ca4aa97194ae(本 commit)— io_uring: get rid of tw_pending for !DEFER task work — 系列第 6 补丁(收尾),移除 tw_pending 位
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。