sched/cache:缓存感知负载均衡 — 同进程线程聚合到同一 LLC 减少缓存缺失
💡 一句话总结
在多 LLC(最后一级缓存,多核共享)的服务器上,同一进程的多个线程往往共享同一份工作集(数据/缓存行),但默认负载均衡只按 CPU 负载搬任务、不考虑缓存域,会把同进程线程摊到不同 LLC 上,迫使线程跨 LLC 访问共享数据——每跨一次就多一次 LLC miss 和访问延迟。本系列引入缓存感知负载均衡:先跟踪每个进程在每个 CPU 上的「近期运行占比」(10ms 半衰的 epoch 衰减,越近的运行权重越高),据此选出该进程的优选 LLC,再让后续补丁在负载均衡时把偏爱该 LLC 的任务优先迁过去,把同进程线程聚合到同一个缓存域。本补丁是系列第 1 个,只铺基础设施(CONFIG_SCHED_CACHE + mm_struct.sc_stat + per-CPU 记账),机制本身在后续补丁才启用。系列基准(d59f4fd1d303,作者自报,未独立验证):hackbench 在 Sapphire Rapids 上最高 +31.9%、Genoa 上最高 +47.3%,chacha20 吞吐 +24%~+48%。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 新特性(feature)· 基础设施(为缓存感知负载均衡铺数据面与控制面地基) |
| 状态 | Merged(绿)· 合入版本:Linux 7.2(v7.2-rc1 已含) |
| 当前版本 | 主线合入版(本 commit 即最终版)· git.kernel.org 链接 |
| 版本演进 |
本 commit 为合入主线的最终版,无独立 v1/v2 演进(推测:系列在邮件列表有讨论迭代,但本地 lore 索引未收录本系列,无法回溯各版本差异)。 系列整体分 3 批合入:04-01 首批 17 补丁(基础设施+主体+启用)→ 05-13 二批 15 补丁(限制/用户控制/修复)→ 05-29 arch_llc_mask(1 补丁) |
| 作者机构 | Peter Zijlstra / Chen Yu / Tim Chen(Intel) |
| 提交日期 | 2026-04-01 |
| 系列规模 | 33 补丁(sched/cache 系列 + sched/topology arch_llc_mask) |
| 改动范围 | 7 文件(include/linux/mm_types.h、include/linux/sched.h、init/Kconfig、kernel/fork.c、kernel/sched/core.c、kernel/sched/fair.c、kernel/sched/sched.h),+359/-0 行 |
| 核心函数 | mm_init_sched() / account_mm_sched() / __update_mm_sched() / fraction_mm_sched() / task_cache_work() |
| 原始链接 | commit df0d98475954(Link 标签:patch.msgid.link) |
📊 速览卡片
特性等级依据:缓存局部性方向性改进,收益明显(hackbench +47%、chacha20 +48%,作者自报)且默认开启、无新硬件依赖,落地可行;但收益高度依赖「多 LLC + 同进程多线程共享工作集 + 中低负载」场景,内存密集/高线程数进程被刻意跳过,且机制复杂、含多批修复——综合 4 原则评 ★★★★(解读(AI 分析))。
🎯 解决什么问题
① 基础设施(df0d9847,本补丁):引入
CONFIG_SCHED_CACHE、mm_struct.sc_stat 每-进程每-CPU 运行记账、epoch 衰减与优选 LLC 计算;② 优选偏好建立(b5ea300a 使 LLC id 连续、47d8696b 给进程分配优选 LLC id、46afe3af/a8d0ca0b/82c960ae 在 rq 与 sched_group 层统计「偏爱目标 LLC 的任务数」);
③ 均衡器接入(f38cc2f0 均衡时优先搬偏爱目标 LLC 的任务、e4c9a4cb 新增
migrate_llc_task 迁移类型、714059f7/5b1d5e6d 迁移与 detach 尊重 LLC 偏好);④ 启用与用户控制(d59f4fd1 只在多 LLC NUMA 上启用、067a3135 加 debugfs 开关、c1e7fe5e 加
aggr_tolerance 等调节旋钮);⑤ 保护与修复(05-13 一批限制单线程/高线程数/内存密集进程,修复 RCU/NULL/竞态等 9 个问题;05-29 补 powerpc 的
arch_llc_mask)。
find_idlest_cpu() / 负载均衡 update_sg_lb_stats() + find_busiest_group())选核与迁移只比较 CPU 负载/利用率,不比较缓存域归属。当一个多线程进程启动或被均衡器迁移时,线程可能落在 2 个以上不同 LLC 上。结果:线程 A 在 LLC0 修改共享变量,线程 B 在 LLC1 读它——B 每次都要穿过 LLC 边界去 LLC0 拿最新值(缓存一致性协议需跨片同步),LLC miss 显著高于线程都在同一 LLC 的情形。同进程线程间的共享数据访问越多,跨 LLC 拆分的代价越大。
- 硬件场景:现代服务器普遍有多个 LLC——多路(多 socket)每路一个 LLC、AMD 每 CCD 一个 L3、单 socket 多 die;甚至 BIOS 开启内存交织时一个 NUMA node 内可能就有 2 个 LLC(如本系列测试平台 Sapphire Rapids:DRAM interleave 后 1 个 NUMA node 含 2 个 LLC,每 LLC 60 CPU)。
- 负载场景:同进程开很多线程、线程间高频共享数据的负载——hackbench(pipe 通信)、数据库、HPC 分解、chacha20 加密(共享密钥/上下文)。这类负载线程间 cache line 传递频繁。
- 触发条件:只有当「进程线程数 ≤ 一个 LLC 能装下的核数」时收益最大——若线程数远超单 LLC 容量,无论怎么放都塞不下,聚合意义消失(本系列后续补丁正是据此跳过高线程数进程)。
🧩 核心机制
本补丁的核心思路可概括为一句话:用「每进程 × 每 CPU 的近期运行占比」作缓存热度的代理,哪个 LLC 上该进程近期最活跃,就把它定为优选 LLC。机制分三块:运行时记账(数据来源)、epoch 衰减(让「近期」可计算)、延迟扫描选优选(决策)。注意:本补丁中 sched_cache_enabled() 恒返回 false,因此所有记账在运行时是空操作——这是「纯基础设施」补丁,机制由后续补丁打开(d59f4fd1 引入 sched_cache_present static key)。
update_se()(CFS 每次更新调度实体运行时间的路径)里挂一个 account_mm_sched(rq, p, delta_exec),把本次运行增量 delta_exec 同时加到「该进程在这个 CPU 上的计数器」mm->sc_stat.pcpu_sched[cpu]->runtime 和「该 CPU 的总运行时间」rq->cpu_runtime。每个进程持有 alloc_percpu(struct sched_cache_time) 的 per-CPU 数组,随 mm 生命周期分配/释放。② epoch 衰减(让「近期」可算):CPU 级维护
cpu_epoch,每 EPOCH_PERIOD(HZ/100 = 10ms)递增一次;__update_mm_sched() 在每次记账时「补齐」该进程计数器落后于 CPU 的 epoch,并对 runtime 做 几何半衰(右移一位,即 ×0.5/epoch)。这样「越近的运行」保留越多权重,长时间不运行的任务其占用度自然归零——缓存热度随之衰减,符合「缓存是最近访问才热」的直觉。③ 延迟扫描选优选(决策):tick 路径的
task_tick_cache() 发现进程的 sc_stat.epoch 落后时,用 task_work_add(..., TWA_RESUME) 把 task_cache_work() 排到该进程某个线程的用户态返回路径执行(因为扫描全部在线 CPU 很贵,不能在 tick/中断上下文做)。task_cache_work() 遍历每个 CPU,用 fraction_mm_sched() 算出该进程在这颗 CPU 上的占用度 NICE_0_LOAD × mm_runtime / cpu_runtime,按 LLC 域(sched_domain_span(sd_llc))累加成每个 LLC 的累计占用 a_occ;选累计占用最大的 LLC 的「最忙 CPU」作候选 m_a_cpu,仅当它比当前优选 LLC 的占用高出 2 倍才切换 mm->sc_stat.cpu——2 倍滞后避免优选 LLC 频繁抖动引发无谓迁移。为什么支撑场景提升:优选 LLC 正是该进程近期最活跃、缓存最热的缓存域。后续补丁让负载均衡把任务迁往其优选 LLC,即把线程往「它自己把缓存养热的地方」搬——共享数据已在热缓存里,跨片 miss 被直接消除。
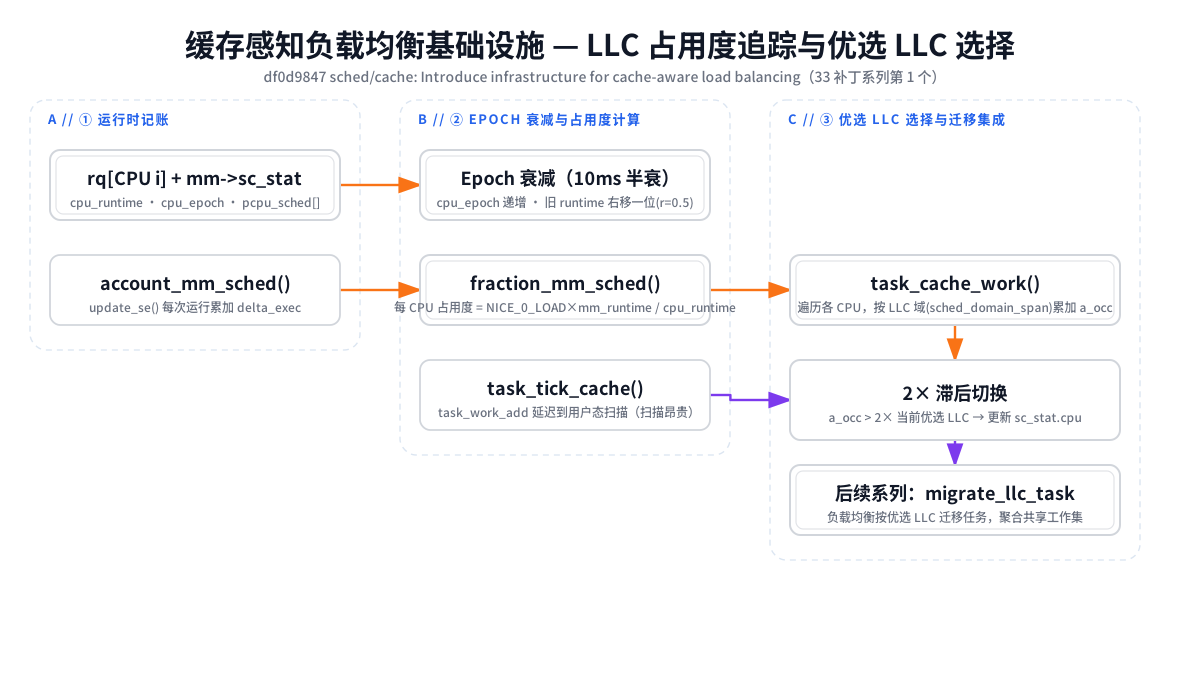
来源:基于 df0d9847 真实 diff 的
account_mm_sched() / __update_mm_sched() / fraction_mm_sched() / task_cache_work() 逻辑绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| 记账 | update_se() → account_mm_sched() 把 delta_exec 累加到 per-CPU 的 mm->sc_stat.pcpu_sched[cpu]->runtime 与 rq->cpu_runtime | 获得「该进程在该 CPU 上花了多少运行时间」的原始数据 |
| 衰减 | __update_mm_sched():补齐 epoch 落后量,对 runtime 右移一位(×0.5/10ms) | 让占用度反映「近期」而非累积,缓存热度自然随不运行而衰减 |
| 占用度 | fraction_mm_sched() = NICE_0_LOAD × mm_runtime / cpu_runtime | 把运行时间归一成「该进程占这颗 CPU 的负载比例」,便于跨 CPU 比较 |
| 调度扫描 | task_tick_cache() 用 task_work_add 把扫描排到用户态返回路径 | 扫描全部在线 CPU 很贵,避免在 tick/中断上下文做 |
| 选优选 | task_cache_work() 按 LLC 累加 a_occ,选最大且 > 2× 当前优选者更新 mm->sc_stat.cpu | 得到该进程的优选 LLC;2× 滞后防止频繁切换引发迁移抖动 |
+#ifdef CONFIG_SCHED_CACHE
+
+struct sched_cache_time {
+	u64 runtime;
+	unsigned long epoch;
+};
+
+struct sched_cache_stat {
+	struct sched_cache_time __percpu *pcpu_sched;
+	raw_spinlock_t lock;
+	unsigned long epoch;
+	int cpu;
+} ____cacheline_aligned_in_smp;
+
+#else
+
+struct sched_cache_stat { };
+
+#endif
▲ 这段定义了机制的核心数据模型:pcpu_sched[] 是「该进程在每个 CPU 上的运行记账」(runtime + 该计数器的 epoch),cpu 是算出的优选 CPU(其所属 LLC 即优选 LLC)。整个结构按 cacheline 对齐且配 raw_spinlock_t,是为并发读写准备的(每个进程独立一把锁,跨 CPU 记账互不串扰)。
+void account_mm_sched(struct rq *rq, struct task_struct *p, s64 delta_exec)
+{
+	struct sched_cache_time *pcpu_sched;
+	struct mm_struct *mm = p->mm;
+	unsigned long epoch;
+
+	if (!sched_cache_enabled())
+		return;
+
+	if (p->sched_class != &fair_sched_class)
+		return;
+	/*
+	 * init_task, kthreads and user thread created
+	 * by user_mode_thread() don't have mm.
+	 */
+	if (!mm || !mm->sc_stat.pcpu_sched)
+		return;
+
+	pcpu_sched = per_cpu_ptr(p->mm->sc_stat.pcpu_sched, cpu_of(rq));
+
+	scoped_guard (raw_spinlock, &rq->cpu_epoch_lock) {
+		__update_mm_sched(rq, pcpu_sched);
+		pcpu_sched->runtime += delta_exec;
+		rq->cpu_runtime += delta_exec;
+		epoch = rq->cpu_epoch;
+	}
+
+	/*
+	 * If this process hasn't hit task_cache_work() for a while invalidate
+	 * its preferred state.
+	 */
+	if (epoch - READ_ONCE(mm->sc_stat.epoch) > EPOCH_LLC_AFFINITY_TIMEOUT) {
+		if (mm->sc_stat.cpu != -1)
+			mm->sc_stat.cpu = -1;
+	}
+}
+
+static inline void __update_mm_sched(struct rq *rq,
+				     struct sched_cache_time *pcpu_sched)
+{
+	lockdep_assert_held(&rq->cpu_epoch_lock);
+
+	unsigned long n, now = jiffies;
+	long delta = now - rq->cpu_epoch_next;
+
+	if (delta > 0) {
+		n = (delta + EPOCH_PERIOD - 1) / EPOCH_PERIOD;
+		rq->cpu_epoch += n;
+		rq->cpu_epoch_next += n * EPOCH_PERIOD;
+		__shr_u64(&rq->cpu_runtime, n);
+	}
+
+	n = rq->cpu_epoch - pcpu_sched->epoch;
+	if (n) {
+		pcpu_sched->epoch += n;
+		__shr_u64(&pcpu_sched->runtime, n);
+	}
+}
▲ 这段是「近期热度」的核心:account_mm_sched() 在每次运行更新时把增量同时记到进程计数器与 CPU 总计数器;__update_mm_sched() 则在记账前先把两边 epoch 对齐,每过 10ms 就对 runtime 右移一位(几何半衰)。这样「占用度」不是累加值而是指数加权的近期运行率——任务停下来不跑,占用度自然衰减,缓存热度得以反映真实工作集而非历史总账。
📈 性能影响
account_mm_sched() 内的加法和锁保护(且本补丁中 sched_cache_enabled() 为 false 时不执行)。
- 多 LLC 拓扑:多 socket / AMD 多 CCD / 单 NUMA 内多 LLC(如本系列测试的 Sapphire Rapids DRAM-interleave 平台,1 NUMA node 2 LLC)。拓扑里至少要有 2 个 LLC 才有「选哪个」的问题——单 LLC 机器本补丁机制无意义(后续补丁
d59f4fd1专门检测此条件)。 - 负载条件:同进程多线程且共享数据频繁;进程线程数 ≤ 单个 LLC 核数(Sapphire Rapids 60、Genoa 16),此时「线程聚进一个 LLC」在容量上可行。线程数远超 LLC 容量时聚合无法实现,后续补丁
deee5e27直接跳过此类进程。 - 空闲/低负载:hackbench 收益集中在「活跃线程数低于 LLC 容量」时;schbench 的唤醒延迟收益也在中低利用率。LLC 满载时可用空间不足,聚合带来的收益被争用抵消(后续补丁
808915f9跳过内存密集进程)。
| 场景/用例 | 运行环境 | 改进前 | 改进后(相对基准) |
|---|---|---|---|
| hackbench pipe(threads-pipe-20, 2-group) | Sapphire Rapids 2S,DRAM interleave,60 CPU/LLC | 1.00(归一) | +31.90%(作者自报,未独立验证) |
| hackbench pipe(threads-pipe-2, 1-group) | AMD Genoa,4 node × 32 CPU,每 node 2 CCX | 1.00(归一) | +47.33%(作者自报,未独立验证) |
| chacha20(risc-v 模拟器 host 时间) | QEMU 模拟,host time 度量 | 67861ms(SR)/ 54762ms(Genoa) | 下降 24% / 48%(作者自报,未独立验证) |
| schbench 99th 唤醒延迟(thread=32) | Sapphire Rapids | 9.00us | 7.00us(+22.22%)(作者自报,未独立验证) |
说明:本补丁(df0d9847)未提供基准——它是纯基础设施,运行时记账尚未启用,无独立性能数据。上表数据来自系列后续启用补丁 d59f4fd1d303("Enable cache aware scheduling for multi LLCs NUMA node")的 commit message,属「作者自报,未独立验证」;netperf / stream / stress-ng 的 Hmean 无明显差异。chacha20 测试在 risc-v 模拟器上进行,宿主时间下降 24%(SR)/48%(Genoa)。
① 减少跨片 cache miss:同进程线程聚合到同一 LLC 后,共享变量/锁/管道缓冲的 cache line 不再跨 LLC 传播,一致性流量显著下降——这是 hackbench(管道通信频繁)与 chacha20(共享上下文)收益的主要来源(解读(AI 分析))。
② 唤醒与迁移局部性:任务长期驻留其优选 LLC,waker/wakee 更可能在相邻核,唤醒路径的 remote wakeup IPI 减少,对应 schbench 的唤醒延迟改善(解读(AI 分析))。
③ 副作用被刻意压制:为防「聚合过度」,系列对单线程、高线程数、内存密集进程一律跳过——因为这些场景聚合不带来共享数据收益、反而挤占缓存容量。这解释了为何 netperf/stream 无明显差异:stream 是带宽型负载,聚合线程只会加剧争用,后续补丁已把这类进程排除(解读(AI 分析))。
🔄 方案演进
本补丁是 33 补丁系列的起点。由于本地 lore 索引未收录本系列,演进过程基于本地内核 git 的 commit 历史与 message 重构(lore 不可用,讨论来源为本地 git commit message)。
migrate_llc_task 迁移类型(e4c9a4cb)、单任务/迁移尊重偏好(714059f7/5b1d5e6d)、多 LLC NUMA 启用(d59f4fd1)、用户开关(067a3135)。第二批(2026-05-13,15 补丁):社区测试驱动的收敛 + 修复。Prateek(AMD)与 Aaron(ByteDance)等报告 hackbench 高线程数回归、stream 内存密集回归 → 加「单线程跳过」(7b34bb1c)、「高线程数禁用」(deee5e27)、「内存密集跳过」(808915f9)、「LLC 大小计算」(7030513a)、「聚合激进程度用户控制」(c1e7fe5e)。同期修 9 个问题:RCU 警告(d943b86d)、NULL mm(9f234694)、无锁访问标注(91d07324)、enqueue/dequeue 配对(03755348)、主动均衡判定(d6b9afab)、域重建竞态(9f7c7458)、多 LLC 启用边界(5beff4f0)、has_multi_llcs 修正(a7660ce1)、新任务 stale 优选(c99b8593)。
第三批(2026-05-29,1 补丁):
1eae219e(sched/topology)提供 arch_llc_mask,修复 powerpc 上 LLC 不在 MC 域导致的 llc_mask 空指针启动 panic(Fixes: b5ea300a,sashiko/IBM 报告)。
Suggested-by / Tested-by 链可看到社区多方参与了设计收敛(lore 不可用,以下为本地 commit message 呈现,解读(AI 分析)):- 聚合过度 → 加护栏:Prateek Nayak(AMD)、Aaron Lu(ByteDance)、Tingyin Duan 报告的回归,催生了「内存密集」「高线程数」「单线程」三类跳过 +
aggr_tolerance用户旋钮——这是系列从「大胆聚合」到「受控聚合」的关键转向。 - SMT 重拓扑限制:Power10/Power11 SMT4、LLC=4 核时「线程数 > LLC 核数」判定会直接禁用该功能;Peter 建议未来用「LLC-mask」而非单值来表达偏好以缓解(deee5e27 提到)。
- 架构可移植性:powerpc 上 LLC 不在 MC/coregroup 域,
b5ea300a假设 coregroup 即 LLC 被证伪 →1eae219e引入arch_llc_mask让架构显式声明 LLC 位置。 - 重尾扫描开销:CPU 占用度扫描是 O(在线 CPU),
a2b4cf39只允许进程 1 个线程同时算占用度(对齐 NUMA balance 的task_numa_work()做法),b4606fab限制扫描 CPU 数。
注:本 commit 自身为合入主线的最终版,无独立 v1/v2 演进;以上演进是「系列整体」的合入节奏与设计收敛,非本补丁单体的版本史。
⚠️ 风险与局限
- 拓扑前提:系统里必须有 ≥2 个 LLC(同 NUMA 或多路),单 LLC 机器上机制是 no-op(后续补丁 d59f4fd1 显式检测
sched_cache_present)。 - 负载前提:同进程多线程且共享工作集;线程数 ≤ 单 LLC 核数(否则聚合容量不够,deee5e27 跳过);内存非带宽密集型(808915f9 跳过)。
- 行为前提:聚合收益在「中低负载、LLC 未饱和」时成立;LLC 满载时过度聚合会加剧争用。
- 默认开启:
CONFIG_SCHED_CACHE默认y(depends on SMP)。不想要的生产环境可在 kernel config 关掉,或运行时用 debugfs/sys/kernel/debug/sched/llc_balancing/enabled关闭(067a3135)。 - 可观测性/调参:
c1e7fe5e暴露 debugfs 旋钮:aggr_tolerance(0=关、1=严格按 LLC 容量、100+=激进)、epoch_period、epoch_affinity_timeout、imb_pct、overaggr_pct——运维可按负载调整聚合激进程度。 - 迁移代价:聚合本身会引入任务迁移(为把线程搬到优选 LLC),若优选判断不稳会抖动;本补丁用 2× 滞后缓解,但迁移次数增加是实际成本(解读(AI 分析))。
- 架构依赖:收益依赖 LLC 拓扑;powerpc 曾因「LLC 不在 MC 域」panic,需
arch_llc_mask显式声明(1eae219e)。SMT 重拓扑(Power10/11 SMT4、LLC=4)会触发高线程数禁用,功能实际不可用。 - 未来扩展口:commit message 明确把「分组单位」做成可扩展的——当前是进程,未来可推广到 NUMA group 或用户配置;缓存域也可从 LLC 扩到 L2 cluster。
- 无用户态 ABI:除 debugfs 外无 syscall/API 变更,对工具链无影响。
Suggested-by/Tested-by/Reported-by 链呈现的社区反馈(解读(AI 分析)):- 内存密集回归(stream):Prateek Nayak、Tingyin Duan 报告 → 808915f9「内存密集跳过」。
- 高线程 hackbench 回归:Prateek Nayak 报告 → deee5e27「高线程数禁用」。
- 多 LLC 启用边界:sashiko 报告 → 5beff4f0 修复「单 node 单 LLC 误启用」。
- powerpc 启动 panic:Venkat Rao Bagalkote 报告 → 1eae219e
arch_llc_mask(Fixes b5ea300a)。
🔗 交叉引用
sched_cache_present static key),含系列主要基准数据47d8696b95f7 sched/cache: Assign preferred LLC ID to processes — 消费本补丁的
sc_stat.cpu,把优选 LLC 固化为每任务属性(类比 NUMA 的 numa_preferred_nid)e4c9a4cb244a sched/cache: Add migrate_llc_task migration type — 负载均衡接入点:新迁移类型按「偏爱目标 LLC 的任务数」搬任务
c1e7fe5e75ed sched/cache: Add user control to adjust aggressiveness —
aggr_tolerance 等 debugfs 旋钮1eae219ea0e8 sched/topology: Provide arch_llc_mask — powerpc 架构适配
[日报] sched/cache: honor migrate_llc_task semantics in active load balance — 本站既有日报:修复主动均衡路径对
migrate_llc_task 的遗漏(本系列后续社区修复)
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。