fuse:未缓存 readdir 缓冲区用页支撑 — 减少目录遍历内存拷贝
💡 一句话总结
在 virtiofs 上做 overlayfs 大目录遍历(未缓存 readdir)时,fuse 把整块多 MB 的 readdir 输出缓冲当作 kvec 参数传给 virtiofs,virtiofs 在请求排队路径上要把它整块拷进 kmalloc(GFP_ATOMIC) 的 argbuf——既需要多 MB 连续物理内存的原子分配(内存压力下容易失败导致目录读取返回 -ENOMEM),回复时还要再整块 memcpy 一遍;本补丁把输出缓冲改为「离散页」并通过 out_pages 让 virtiofs 以 scatter-gather 把页直接交给设备 DMA,解析期才用 vm_map_ram 临时映射成线性地址——消除了大块连续原子分配与整块内存拷贝。补丁未提供基准数据,性能收益为逻辑分析(解读(AI 分析))。
📋 补丁基本信息
| 项目 | 内容 |
|---|---|
| 补丁类型 | 修复(bugfix)+ 优化(性能)——主导为修复:带 Fixes: 链与 Cc: stable,修掉 dabb90391028 引入的「大缓冲在 virtiofs 原子分配失败」回归;同时消除整块拷贝带来 on-CPU 收益 |
| 状态 | 状态(Merged)· 合入版本:Linux 7.2(v7.2-rc1 起,经 fuse-update-7.2 合并提交 6edc20078ad0 并入主线) |
| 当前版本 | 主线合入版 · git.kernel.org(规范 commit 链接) |
| 版本演进 | 首版即合入,暂无公开 lore 补丁系列。 commit message 无 Link:/Message-ID trailer;本环境 lore 索引多次查询均超时不可用,演进/讨论细节无法回溯,背景依据 commit message + 本地内核 git 推断(见「方案演进」数据源说明)。
|
| 作者机构 | Matthew R. Ochs(NVIDIA)<mochs@nvidia.com> |
| 提交日期 | authored 2026-05-26 · v7.2-rc1 合入(2026-06 中旬) |
| 改动范围 | fs/fuse/readdir.c,+67/-18 行,1 文件 |
| 核心函数 | fuse_readdir_alloc_buf()(新) / fuse_readdir_uncached() / alloc_pages_bulk() / vm_map_ram() |
| 原始链接 | git.kernel.org(规范 commit 链接) |
| Fixes 链 | Fixes: dabb90391028("fuse: increase readdir buffer size",2025-04 合入)· Cc: stable@vger.kernel.org |
📊 速览卡片
特性等级依据:收益机制明确(消除多 MB 连续 GFP_ATOMIC 分配失败 + 省一次整块 memcpy)且纯内核改动易落地、向后兼容(Fixes 回归 + Cc stable);但无实测数据,且仅 virtiofs/页直通传输 + 大 count 场景受益,场景覆盖面中等 → ★★★。
🎯 解决什么问题
fuse_readdir_uncached() 的临时缓冲大小从固定值改为跟随调用方 ctx->count——这对 overlayfs 等内核调用方很有用,它们用 INT_MAX 表示"不限目录读,能装多少装多少"。缓冲变大后问题随之而来:这个缓冲作为 kvec 输出参数传递时,virtiofs 传输层会在请求排队路径上把它整块拷进 req->argbuf,而 argbuf 用 kmalloc(..., GFP_ATOMIC) 分配(见 fs/fuse/virtio_fs.c:1517,请求路径传 GFP_ATOMIC)——于是出现"多 MB 连续物理内存 + 原子上下文(不可睡眠/压缩/回收)"的硬分配需求。这是本补丁要修的直接动机,来源为 commit message 原文。
fs/fuse/readdir.c + fs/fuse/virtio_fs.c:
fuse_readdir_uncached()用buf = kvmalloc(bufsize, GFP_KERNEL)分配一个线性大缓冲,并挂到请求的out_args[0].value(kvec 输出参数)。- virtiofs 的
virtio_fs_enqueue_req()(GFP_ATOMIC)调copy_args_to_argbuf(),其len把「输出参数大小」也算进去(num_out = args->out_numargs - args->out_pages),所以req->argbuf = kmalloc(len, GFP_ATOMIC)需要分配整个输出缓冲大小的连续物理内存。 GFP_ATOMIC分配不允许睡眠/直接回收/压缩/oom,多 MB 连续块在内存压力下拿不到就返回-ENOMEM,readdir 直接失败——大目录遍历被中断。- 即使分配成功,回复路径
copy_args_from_argbuf()还要memcpy(argbuf → buf)把整块数据拷回调用方缓冲(多 MB 白拷一遍)。
readdir(2) → overlayfs 的 ovl_readdir → fuse 目录文件 → fuse_readdir()(fs/fuse/readdir.c:640):目录未开 FOPEN_CACHE_DIR 或缓存未命中时走 fuse_readdir_uncached() → FUSE_READDIR/READDIRPLUS 请求 → virtiofs 队列。
高频场景:容器场景最常见的存储组合是「virtiofs 导出宿主目录 + overlayfs 做镜像层/读写层合并」。overlayfs 在 fs/overlayfs/readdir.c 多处(:429、:656、:1163、:1184、:1265)用 .ctx.count = INT_MAX 发起"不限目录读",fuse 于是把 bufsize 拉到 fc->max_pages << PAGE_SHIFT(即每请求最大页数 × 页大小,多 MB 级)。大目录(如 /usr/share、/usr/lib、node_modules、包管理器缓存)一次遍历要反复走这条路径。
为什么该场景会遇到缺陷:只要内存压力较大或系统碎片化,GFP_ATOMIC 凑不出多 MB 连续物理块,readdir 就返回 -ENOMEM——用户看到的是一次 `ls` / 镜像构建 / 依赖扫描中途报错或超时;即便分配成功,每次请求还白付一次多 MB 的 memcpy 与一次大块分配的内存管理开销(解读(AI 分析),基于上述代码路径推断)。
为什么此特性解决此场景:把「连续大块原子分配 + 整块拷贝」换成「离散页 + SG 直通」,分配不再要求物理连续、回复不再整块拷贝,从根上消除该场景的失败点与拷贝开销。
🧩 核心机制
把未缓存 readdir 的输出缓冲从「单个 kvec 线性缓冲」改为「一簇离散物理页」:页用 alloc_pages_bulk() 批量分配(不需要连续),请求打上 out_pages 标记后 virtiofs 把各页作为 scatter-gather 条目直接入 virtqueue(argbuf 只保留 header 与小参数),设备 DMA 把 dirent 直接写进各页;解析期才用 vm_map_ram() 把这些离散页临时映射成一段连续线性地址,复用既有解析器,解析完即 vm_unmap_ram() 拆除映射。
fs/fuse/readdir.c 新增 fuse_readdir_alloc_buf() 帮助函数,替换 fuse_readdir_uncached() 里的 kvmalloc(bufsize) + out_args[0].value = buf 方案;请求参数结构从 struct fuse_args * 换成 struct fuse_args_pages *ap,并用 ap->args.out_pages = true 把输出改为「页参数」。
为什么要这么改:FUSE 请求框架本身支持两种输出承载方式——kvec(out_args[].value 指向线性缓冲)与页(out_pages + folios[]/descs[])。virtiofs 对「页输出」走 sg_init_fuse_folios() 把 folio 直接 sg_set_folio() 挂进 SG 表,对「kvec 输出」则必须先拷进 argbuf。因此改走 out_pages 就让 virtiofs 的 num_out = out_numargs - out_pages 把大缓冲排除出 argbuf 的 len 计算,argbuf 立刻变小,大块连续原子分配消失;设备端也少一道「argbuf → 调用方缓冲」的整块 memcpy。
为什么能支撑场景提升:① 分配层面——alloc_pages_bulk() 拿的是离散页(buddy/PCP 上任意可用的 order-0 页),不要求物理连续,GFP_KERNEL 且非原子上下文,内存压力下也能凑齐,readdir 不再因连续大块凑不齐而 -ENOMEM;② 拷贝层面——回复数据经 SG 直达页,省掉一次多 MB memcpy;③ 解析层面——vm_map_ram() 只做临时线性映射,复用既有 parse_dirfile/parse_dirplusfile,映射生命周期短,不常驻 vmalloc 空间。
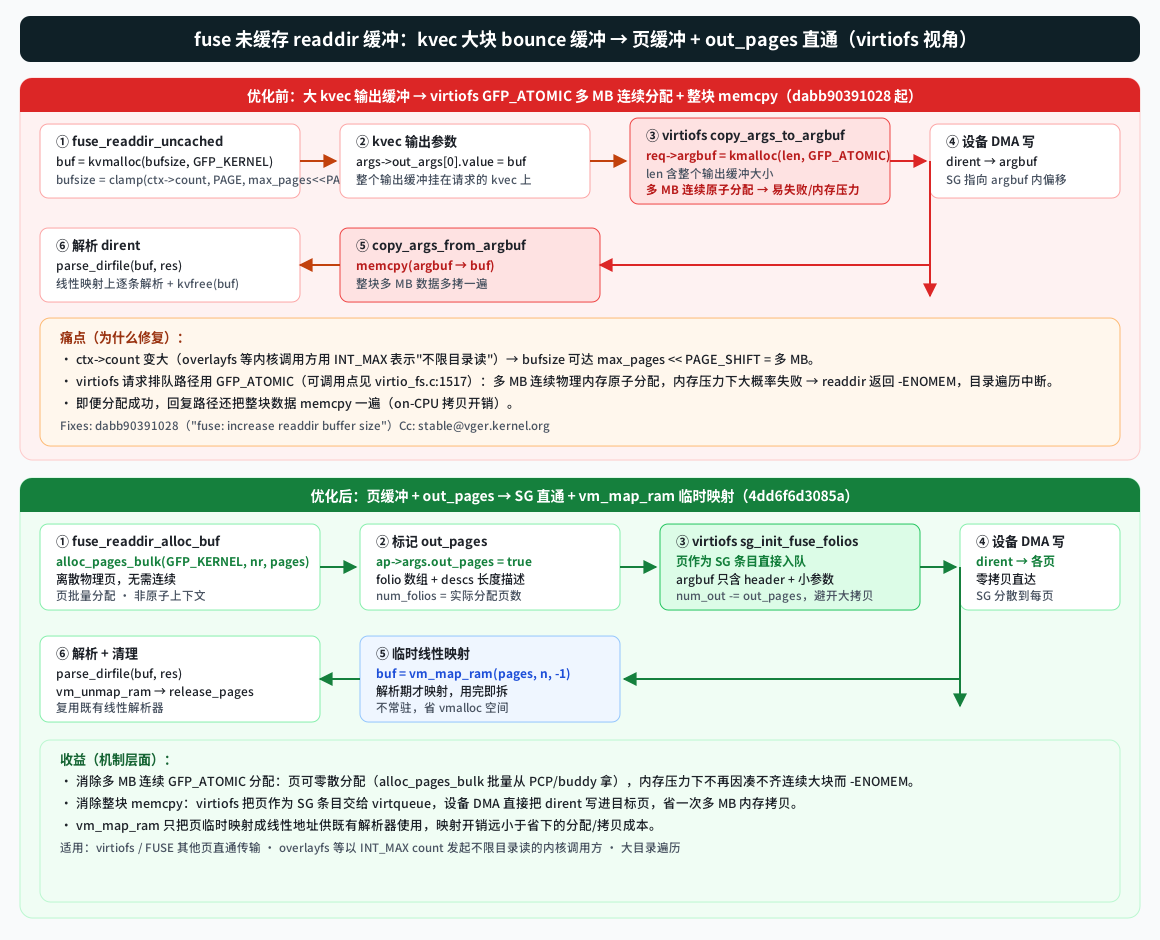
来源:基于真实 commit 4dd6f6d3085a diff 与 virtio_fs.c 请求路径绘制
| 步骤 | 操作 | 目的 |
|---|---|---|
| ① 页分配 | alloc_pages_bulk(GFP_KERNEL, nr_pages, pages) | 批量拿离散物理页,无需连续;部分成功时收缩 bufsize |
| ② 标记页输出 | ap->args.out_pages = true + folios[]/descs[].length | 让传输层把输出当页参数走 SG;virtiofs 的 argbuf 只留 header + 小参数 |
| ③ 请求发出 | fuse_simple_request(fm, &ap->args) | 设备 DMA 把 dirent 直接写进各页(零拷贝) |
| ④ 临时映射 | buf = vm_map_ram(pages, num_folios, -1) | 把离散页映射成一段线性地址,满足既有解析器按连续 char * 解析的要求 |
| ⑤ 解析 + 清理 | parse_dirfile/plus → vm_unmap_ram → release_pages | 复用既有解析逻辑;用完拆映射、还页、释放数组 |
+static struct page **fuse_readdir_alloc_buf(struct fuse_args_pages *ap, size_t *bufsize)
+{
+	unsigned int i, nr_alloc, nr_pages = DIV_ROUND_UP(*bufsize, PAGE_SIZE);
+	struct page **pages = kcalloc(nr_pages, sizeof(*pages), GFP_KERNEL);
+
+	if (!pages)
+		return NULL;
+
+	nr_alloc = alloc_pages_bulk(GFP_KERNEL, nr_pages, pages);
+	if (!nr_alloc)
+		goto free_array;
+
+	if (nr_alloc < nr_pages) {
+		nr_pages = nr_alloc;
+		*bufsize = (size_t) nr_pages << PAGE_SHIFT;
+	}
+
+	ap->folios = fuse_folios_alloc(nr_pages, GFP_KERNEL, &ap->descs);
+	if (!ap->folios)
+		goto release_pages;
+
+	for (i = 0; i < nr_pages; i++) {
+		ap->folios[i] = page_folio(pages[i]);
+		ap->descs[i].length = min_t(size_t, *bufsize - (size_t)i * PAGE_SIZE, PAGE_SIZE);
+	}
+	ap->num_folios = nr_pages;
+	ap->args.out_pages = true;
+
+	return pages;
+...
▲ 这段是机制成立的关键:alloc_pages_bulk() 批量拿离散页替代原来的一整块 kvec 缓冲——分配不再要求物理连续,且是 GFP_KERNEL(可睡眠)而非排队路径的 GFP_ATOMIC;out_pages = true 是让 virtiofs 把输出页当 SG 条目直通设备的前提。
-	buf = kvmalloc(bufsize, GFP_KERNEL);
-	if (!buf)
+	struct page **pages = fuse_readdir_alloc_buf(ap, &bufsize);
+
+	if (!pages)
 		return -ENOMEM;

-	args->out_args[0].value = buf;
-
 	plus = fuse_use_readdirplus(inode, ctx);
 	...
-	res = fuse_simple_request(fm, args);
+	res = fuse_simple_request(fm, &ap->args);
 	fuse_unlock_inode(inode, locked);
-	if (res >= 0) {
-		...
-	} else if (plus) {
-		res = parse_dirplusfile(buf, res, file, ctx, attr_version, evict_ctr);
-	} else {
+	...
+	buf = vm_map_ram(pages, ap->num_folios, -1);
+	if (!buf) {
+		res = -ENOMEM;
+	} else {
+		if (plus)
+			res = parse_dirplusfile(buf, res, file, ctx, attr_version, evict_ctr);
+		else
+			res = parse_dirfile(buf, res, file, ctx);
+
+		vm_unmap_ram(buf, ap->num_folios);
 	}
+out:
+	kfree(ap->folios);
+	release_pages(pages, ap->num_folios);
+	kfree(pages);

-	kvfree(buf);
 	fuse_invalidate_atime(inode);
▲ 关键变化:请求参数从 struct fuse_args *args 换成 struct fuse_args_pages *ap,不再设置 out_args[0].value(不再要求线性 kvec 输出),改为 out_pages 页输出;解析前用 vm_map_ram() 把离散页临时映射成线性地址,让既有 parse_dirfile() 无需改动、继续按连续 char * 解析,解析完即 vm_unmap_ram() 拆除映射并 release_pages() 还页。
📈 性能影响
memcpy(copy_args_from_argbuf 的 argbuf→调用方缓冲),以及省掉大块 kmalloc/kvmalloc 分配本身的内存管理成本;alloc_pages_bulk 批量分配比单次大块分配更省。
次类:off-CPU 分配等待/失败规避——把「多 MB 连续物理内存 + GFP_ATOMIC 原子上下文」的硬分配改成「离散页 + GFP_KERNEL」:内存压力下不再因凑不齐连续块而请求失败(-ENOMEM)或触发分配器额外开销;这是可靠性/端到端延迟层面的收益,而非单点 CPU 指令减少。属于 Brendan Gregg 视角下 on-CPU(省拷贝)与 off-CPU(规避分配失败与等待)双重收益。
ovl_readdir 以 INT_MAX count 触发未缓存 readdir,缓冲拉到 max_pages 上限(多 MB)。该场景每次 readdir 都面对大缓冲,收益直接。
② 内存压力/碎片化环境:页可零散分配,GFP_KERNEL 可睡眠回收,分配失败率显著下降。
③ 大目录被反复枚举(构建、扫描、包管理):每次省一次整块拷贝,累积可观。
④ 经典 FUSE daemon(非页直通传输):若传输层不支持 out_pages 页直通,收益主要来自「页分配替代大块线性分配」,拷贝收益可能被回退路径抵消——此项为边界说明(解读(AI 分析))。
| 场景/用例 | 运行环境 | 改进前 | 改进后 |
|---|---|---|---|
| virtiofs 未缓存 readdir 大目录遍历 | virtiofs + overlayfs,大目录(多 MB 缓冲) | 多 MB 连续 GFP_ATOMIC 分配(压力下 -ENOMEM)+ 整块 memcpy | 离散页 + SG 直通 + 临时映射(无大块原子分配、无整块拷贝) |
说明:补丁未提供基准数据(commit message 无 benchmark),上表为机制层面前后对比,量化收益属逻辑分析(解读(AI 分析)),不构造数字。分配失败率的下降依赖内存压力场景,拷贝省去量 ≈ 每次 readdir 缓冲大小(多 MB 级)。
🔄 方案演进
数据源说明:该 commit 无公开 lore 补丁系列(commit message 无 Link:/Message-ID trailer);本环境 lore MCP 多次查询(lore_find / lore_expand_citation / lore_substr_subject)均超时不可用。演进/讨论信息只能依据 commit message 与本地内核 git 推断,推断均标注"推测"。
② fuse 维护者 Miklos Szeredi(SzM)在合入整理时把「页分配」抽成独立帮助函数
fuse_readdir_alloc_buf()——commit message 末行 [SzM: separate allocation of pages into a helper function] 是维护者编辑标注(真实来自 commit message 原文)。③ 经
fuse-update-7.2 合并提交 6edc20078ad0(Merge tag 'fuse-update-7.2')并入主线,git describe --contains 确认首个包含 tag 为 v7.2-rc1 → Linux 7.2。④ 带
Fixes: dabb90391028 + Cc: stable@vger.kernel.org,预计将 backport 到 stable 系列(推测,依据 Cc stable 惯例)。
out_pages 是 FUSE 请求框架已有的页承载路径,virtiofs 已实现 SG 直通,改造成本最小;vm_map_ram 让既有解析器零改动。代价是解析期需临时映射/拆映射(vmap/vunmap 有少量开销),但相对省下的分配与拷贝成本很小(解读(AI 分析))。review 具体讨论因 lore 不可用无法回溯,如实标注。
⚠️ 风险与局限
out_pages 页承载(virtiofs 已实现;经典 FUSE daemon 的请求路径若只认 kvec,拷贝收益可能回退)。② 只作用于未缓存 readdir 路径(
FOPEN_CACHE_DIR 未开启或目录缓存未命中时),已缓存路径(fuse_readdir_cached)不受影响。③
bufsize 被 clamp 到 fc->max_pages << PAGE_SHIFT,收益上限 = max_pages 大小;alloc_pages_bulk 部分成功时 bufsize 收缩,单次返回的 dirent 变少(多分几批),属既有 clamp 语义的延续。
vm_map_ram() 需要 vmalloc 区地址空间——临时映射多 MB(等于 max_pages 上限)需要足够 vmalloc area;高并发大目录遍历时多请求并发映射可能短暂占用较多 vmalloc 空间,极端碎片化下 vm_map_ram 本身也可能失败(此时返回 -ENOMEM,但概率远低于优化前连续大块分配)。② 行为变化:页承载下 dirent 数据的物理分布从「一段连续」变为「多页」,但对解析器透明(vm_map_ram 保证线性视图),无用户态接口变化。
③ stable backport(Cc: stable)落地时需要确认目标 stable 版本同样具备
fuse_folios_alloc 等前置设施。
out_pages 与 fuse_folios_alloc(fs/fuse/fuse_i.h 已有,file.c/ioctl.c 复用同一帮助函数),无新配置项。
[SzM: ...] 维护者编辑标注表明合入前有整理,但细节无公开记录可查。
🔗 交叉引用
被修复 commit:fuse: increase readdir buffer size — dabb90391028(2025-04)把未缓存 readdir 缓冲改为跟随 ctx->count,是本补丁的
Fixes: 链源头合并提交:Merge tag 'fuse-update-7.2' — 本补丁随 fuse-update-7.2 合并进入主线(v7.2-rc1)
本站内容均由 AI 基于公开知识辅助生成,仅供学习参考,请勿直接引用作为依据。作者不对信息的准确性、完整性及适用性作保证,亦不对因使用本站内容产生的任何损失承担责任。